
机器学习7-模型保存&无监督学习
模型保存和加载
sklearn模型的保存和加载API
- from sklearn.externals import joblib
- 保存:joblib.dump(rf, 'test.pkl')
- 加载:estimator = joblib.load('test.pkl')
线性回归的模型保存加载案例
def linear3():

    """

    岭回归的优化方法对波士顿房价预测

    """

    #获取数据

    boston=load_boston()

    #划分数据集

    x_train,x_test,y_train,y_test=train_test_split(boston.data,boston.target,random_state=22)

    #标准化

    transfer=StandardScaler()

    x_train=transfer.fit_transform(x_train)

    x_test=transfer.transform(x_test)

    #预估器

    # estimator=Ridge(alpha=0.0001, max_iter=100000)

    # estimator.fit(x_train,y_train)

    #保存模型

    # joblib.dump(estimator,"my_ridge.pkl")

    #加载模型

    estimator=joblib.load("my_ridge.pkl")

    #得出模型

    print("岭回归-权重系数为:\n",estimator.coef_)

    print("岭回归-偏置为:\n",estimator.intercept_ )

    #模型评估

    y_predict = estimator.predict(x_test)

    print("预测房价:\n", y_predict)

    error = mean_squared_error(y_test, y_predict)

    print("岭回归-均方差误差:\n", error)

    return None

if __name__ == '__main__':

    # linear1()

    # linear2()

    linear3()
保存:保存训练完结束的模型
加载:加载已有的模型,去进行预测结果和之前的模型一样
无监督学习-K-means算法
K-means原理
我们先来看一下一个K-means的聚类效果图
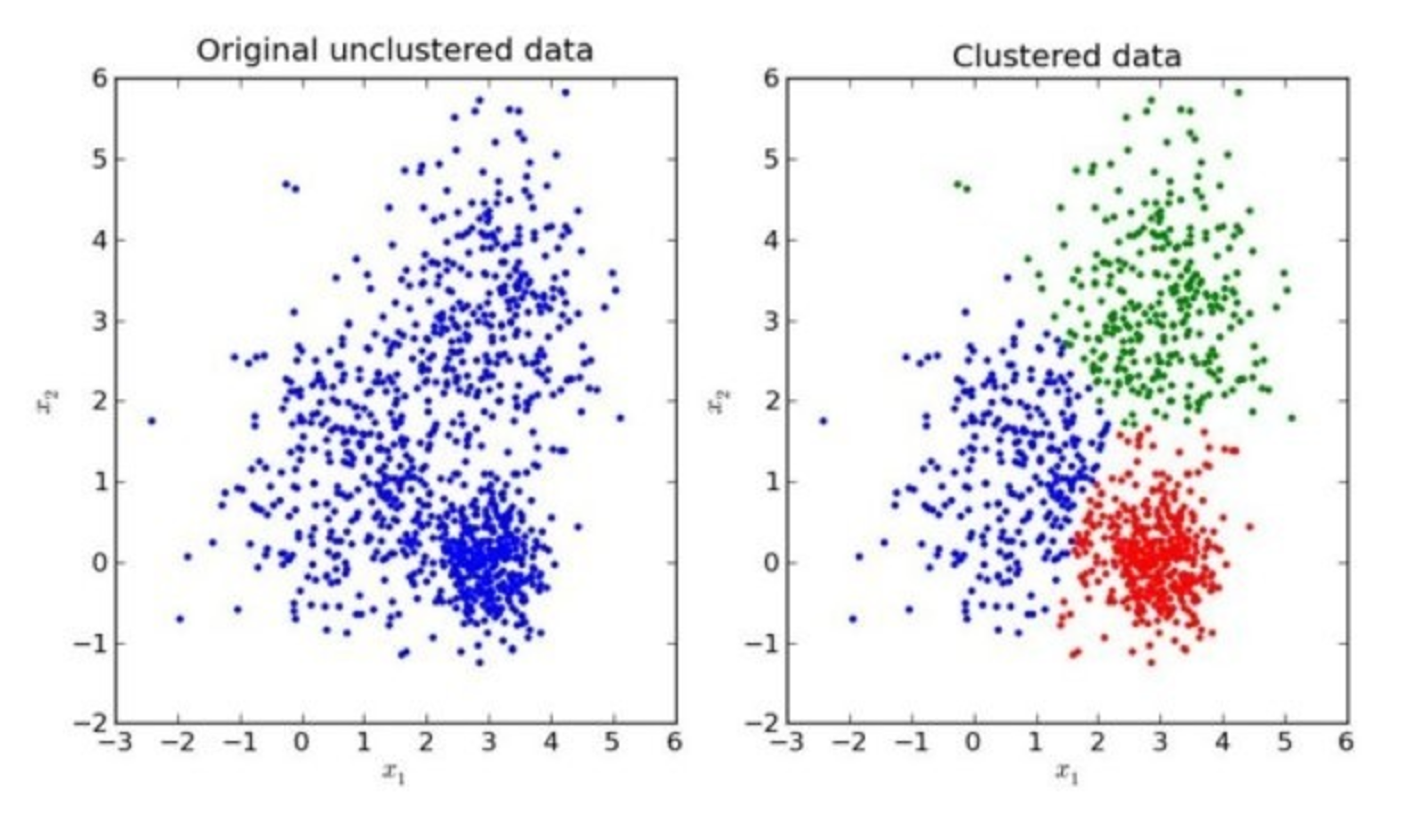
K-means聚类步骤
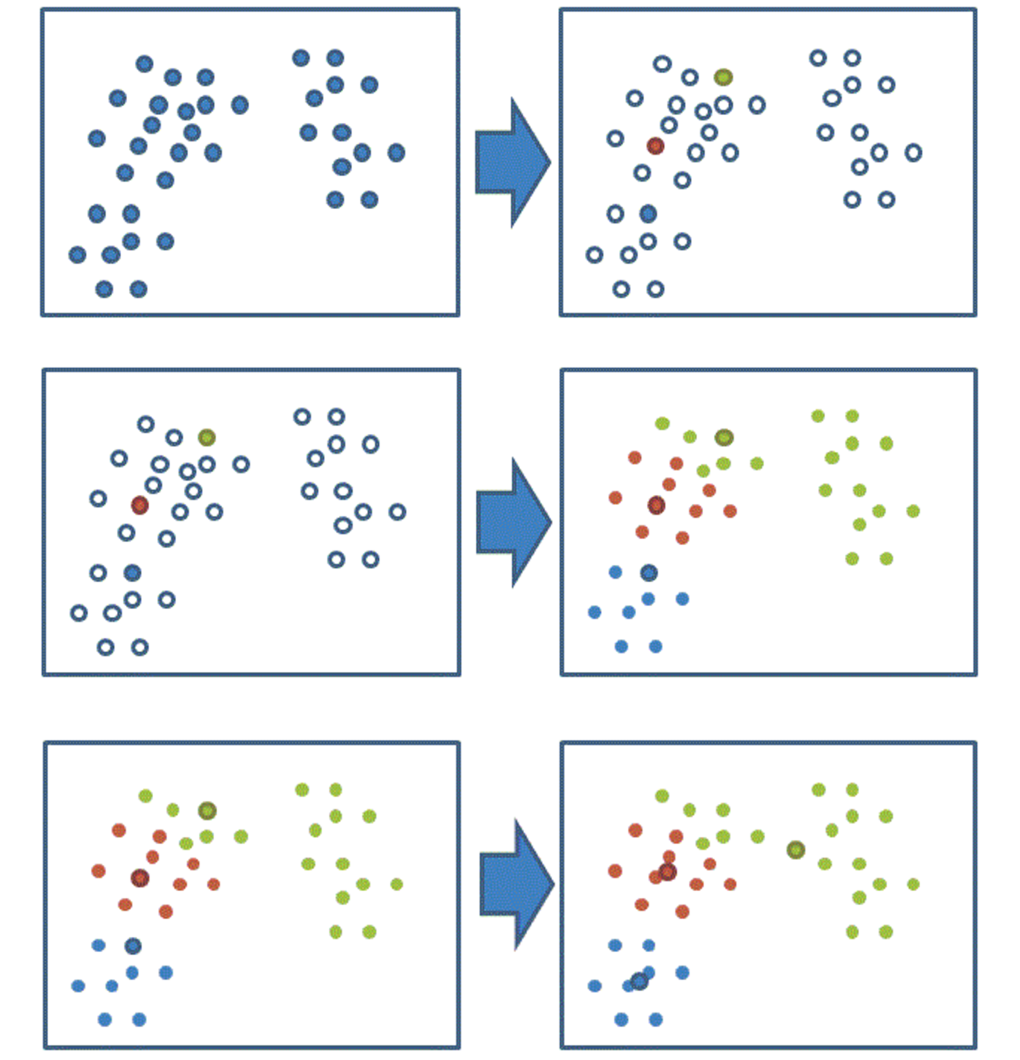
- 随机设置K个特征空间内的点作为初始的聚类中心
- 2、对于其他每个点计算到K个中心的距离,未知的点选择最近的一个聚类中心点作为标记类别
- 3、接着对着标记的聚类中心之后,重新计算出每个聚类的新中心点(平均值)
- 4、如果计算得出的新中心点与原中心点一样,那么结束,否则重新进行第二步过程
我们以一张图来解释效果
K-meansAPI
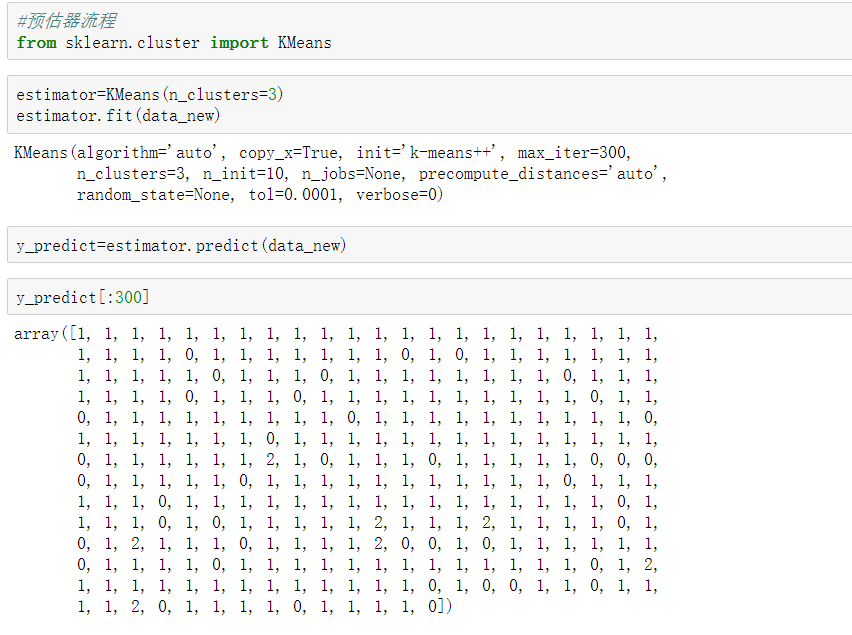
- sklearn.cluster.KMeans(n_clusters=8,init=‘k-means++’)
- k-means聚类
- n_clusters:开始的聚类中心数量
- init:初始化方法,默认为'k-means ++’
- labels_:默认标记的类型,可以和真实值比较(不是值比较)
案例:k-means对Instacart Market用户聚类
如何评估聚类的效果?
Kmeans性能评估指标
轮廓系数
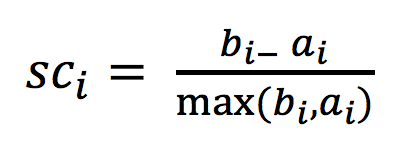
轮廓系数值分析
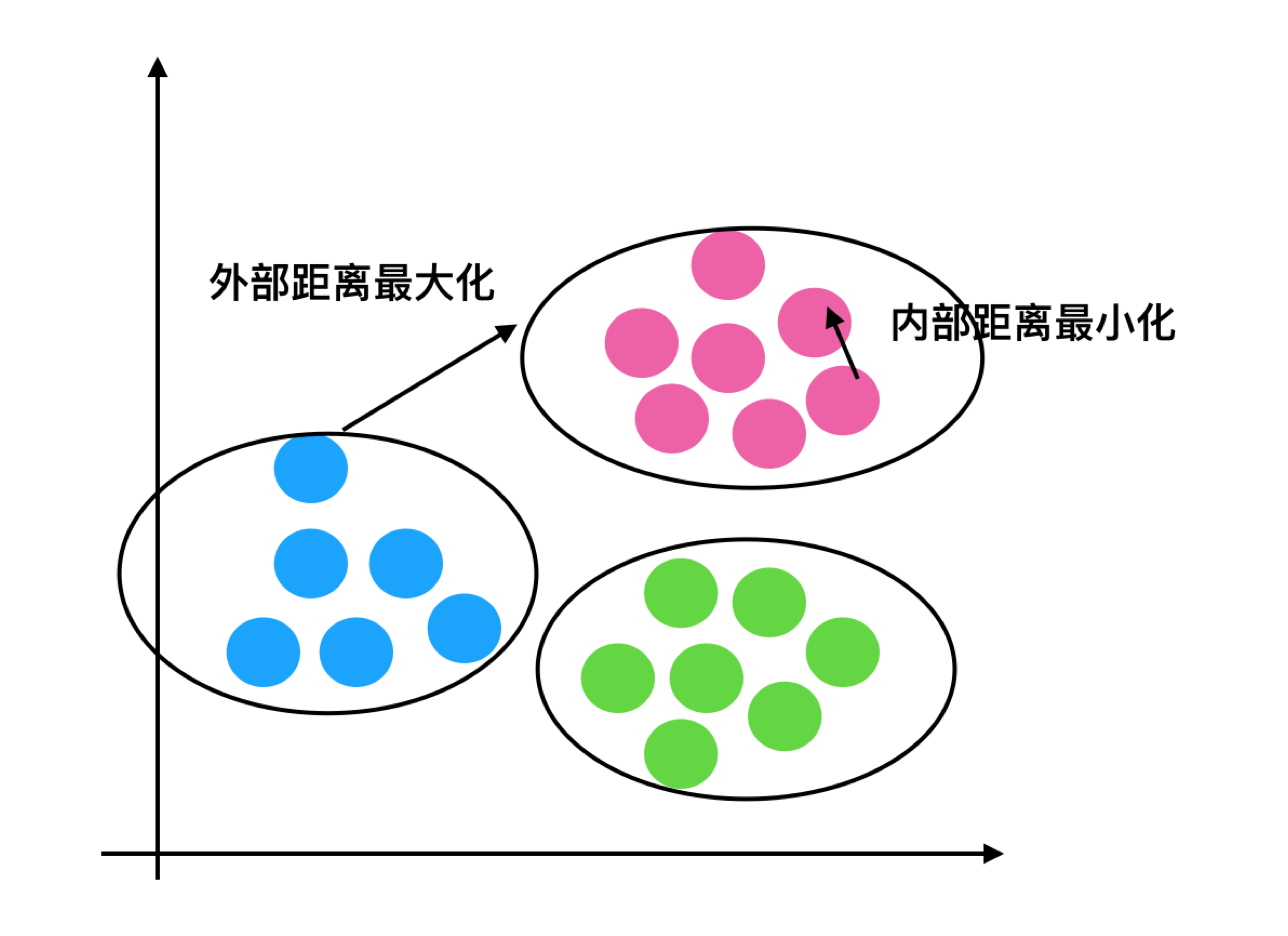
分析过程(我们以一个蓝1点为例)
1、计算出蓝1离本身族群所有点的距离的平均值a_i
2、蓝1到其它两个族群的距离计算出平均值红平均,绿平均,取最小的那个距离作为b_i
- 根据公式:极端值考虑:如果b_i >>a_i: 那么公式结果趋近于1;如果a_i>>>b_i: 那么公式结果趋近于-1
结论
如果b_i>>a_i:趋近于1效果越好, b_i<<a_i:趋近于-1,效果不好。轮廓系数的值是介于 [-1,1] ,越趋近于1代表内聚度和分离度都相对较优。
轮廓系数API
- sklearn.metrics.silhouette_score(X, labels)
- 计算所有样本的平均轮廓系数
- X:特征值
- labels:被聚类标记的目标值
案例-聚类评估

K-means总结
- 特点分析:采用迭代式算法,直观易懂并且非常实用
- 缺点:容易收敛到局部最优解(多次聚类)
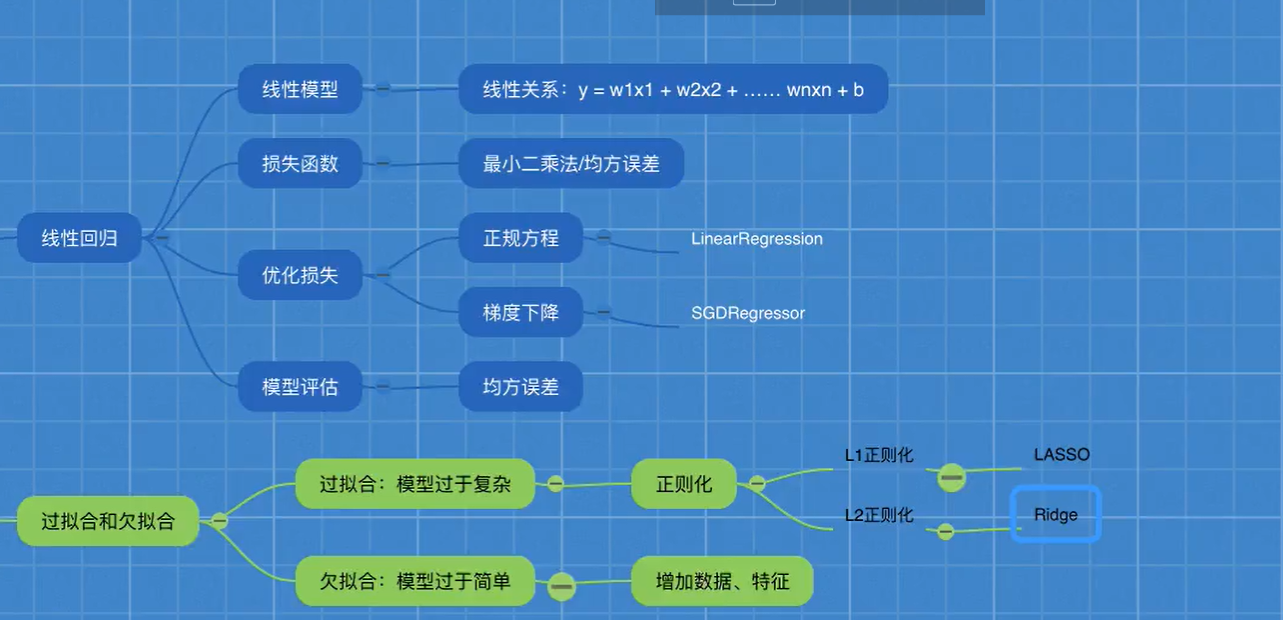
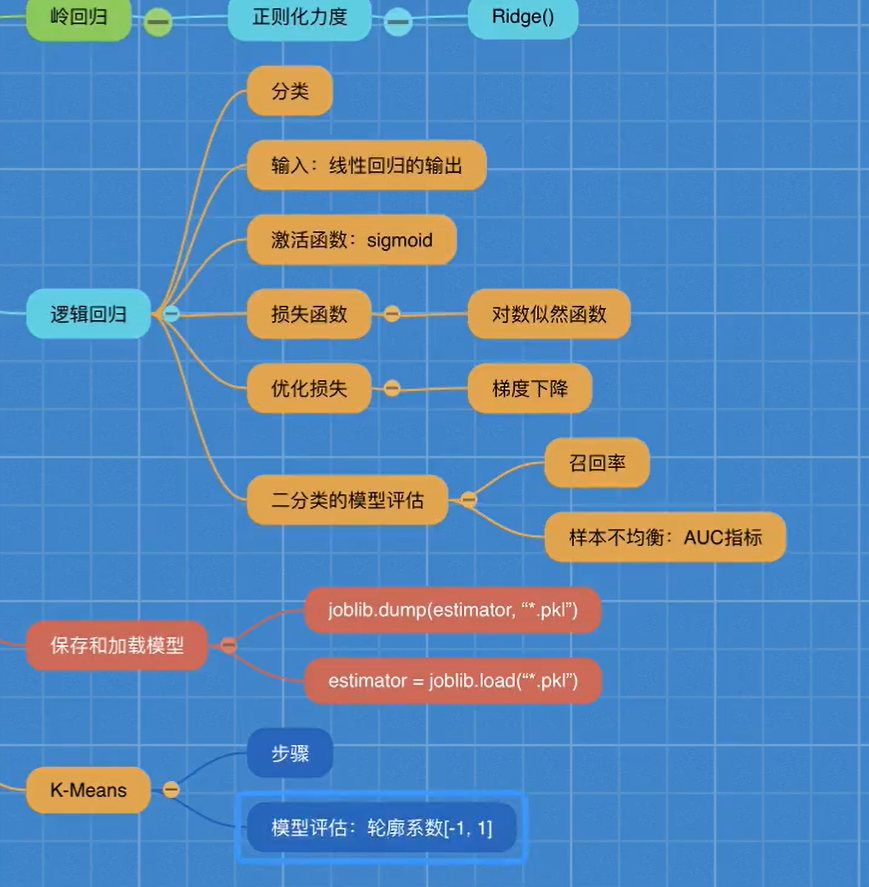
回归与聚类整体算法总结
机器学习7-模型保存&无监督学习的更多相关文章
- 斯坦福机器学习视频笔记 Week8 无监督学习:聚类与数据降维 Clusting & Dimensionality Reduction
监督学习算法需要标记的样本(x,y),但是无监督学习算法只需要input(x). 您将了解聚类 - 用于市场分割,文本摘要,以及许多其他应用程序. Principal Components Analy ...
- 深度|OpenAI 首批研究成果聚焦无监督学习,生成模型如何高效的理解世界(附论文)
本文经机器之心(微信公众号:almosthuman2014)授权转载,禁止二次转载,原文. 选自 Open AI 作者:ANDREJ KARPATHY, PIETER ABBEEL, GREG BRO ...
- Python 机器学习实战 —— 无监督学习(上)
前言 在上篇<Python 机器学习实战 -- 监督学习>介绍了 支持向量机.k近邻.朴素贝叶斯分类 .决策树.决策树集成等多种模型,这篇文章将为大家介绍一下无监督学习的使用.无监督学习顾 ...
- Python 机器学习实战 —— 无监督学习(下)
前言 在上篇< Python 机器学习实战 -- 无监督学习(上)>介绍了数据集变换中最常见的 PCA 主成分分析.NMF 非负矩阵分解等无监督模型,举例说明使用使用非监督模型对多维度特征 ...
- 【机器学习基础】无监督学习(1)——PCA
前面对半监督学习部分作了简单的介绍,这里开始了解有关无监督学习的部分,无监督学习内容稍微较多,本节主要介绍无监督学习中的PCA降维的基本原理和实现. PCA 0.无监督学习简介 相较于有监督学习和半监 ...
- 【机器学习】从分类问题区别机器学习类型 与 初步介绍无监督学习算法 PAC
如果要对硬币进行分类,我们对硬币根据不同的尺寸重量来告诉机器它是多少面值的硬币 这种对应的机器学习即使监督学习,那么如果我们不告诉机器这是多少面额的硬币,只有尺寸和重量,这时候让机器进行分类,希望机器 ...
- Python机器学习入门(1)之导学+无监督学习
Python Scikit-learn *一组简单有效的工具集 *依赖Python的NumPy,SciPy和matplotlib库 *开源 可复用 sklearn库的安装 DOS窗口中输入 pip i ...
- <机器学习>无监督学习算法总结
本文仅对常见的无监督学习算法进行了简单讲述,其他的如自动编码器,受限玻尔兹曼机用于无监督学习,神经网络用于无监督学习等未包括.同时虽然整体上分为了聚类和降维两大类,但实际上这两类并非完全正交,很多地方 ...
- Coursera机器学习笔记(一) - 监督学习vs无监督学习
转载 http://daniellaah.github.io/2016/Machine-Learning-Andrew-Ng-My-Notes-Week-1-Introduction.html 一. ...
随机推荐
- 图解Janusgraph系列-并发安全:锁机制(本地锁+分布式锁)分析
图解Janusgraph系列-并发安全:锁机制(本地锁+分布式锁)分析 大家好,我是洋仔,JanusGraph图解系列文章,实时更新~ 图数据库文章总目录: 整理所有图相关文章,请移步(超链):图数据 ...
- layui的登录页面设计
主要的结构 先导入layui的主要的js和css等 <html> <head> <meta charset="utf-8"> <title ...
- 基于excel实现接口自动化测试
本文档介绍如何使用excel管理接口测试用例并一键执行的实现方式,其中包括 python 读写excel, request库的基本操作,接口用例的设计 接口用例设计 用例字段描述 被依赖表达式: 示例 ...
- 短链接服务Octopus的实现与源码开放
前提 半年前(2020-06)左右,疫情触底反弹,公司的业务量不断提升,运营部门为了方便短信.模板消息推送等渠道的投放,提出了一个把长链接压缩为短链接的功能需求.当时为了快速推广,使用了一些比较知名的 ...
- Win10环境安装node.js和npm
Node.js和npm的关系 Node.js是一个基于Chrome V8引擎的JavaScript运行环境,使用了事件驱动非阻塞式I/O模型. npm(Node Package Manager)是一个 ...
- 手写一个简单的starter组件
spring-boot中有很多第三方包,都封装成starter组件,在maven中引用后,启动springBoot项目时会自动装配到spring ioc容器中. 思考: 为什么我们springBoot ...
- linux下eclipse
最近想学习C++,所以就重新安装了linux系统,虽然这两者没有什么联系,但是我还是比较喜欢linux系统,所以在linux下安装了Eclipse,想起了当初学习Red Hat 9.0时的痛苦场景,哎 ...
- 如何快速学会git
相信大多数入门者都对git的原理比较恍惚,今天我们来告诉大家如何快速学会git命令. 1.git init 这个命令会在当前目录里创建一个.git目录,也就是初始化本地仓库.git. 如图先创建文件夹 ...
- Docker安装系列教程
首先准备一台Centos7版本的虚拟机,它支持docker容器技术.本案例使用centos7虚拟机安装docker容器. 一.安装 1.启动虚拟机,配置虚拟机能够访问互联网 2. 安装支持软件包,提供 ...
- hive集群模式安装
hadoop3.2.0 完全分布式安装 hive-3.1.1 #解压缩tar -zxvf /usr/local/soft/apache-hive-3.1.1-bin.tar.gz -C /usr/lo ...