
Centos7安装Hive2.3
准备
1、hadoop已部署(若没有可以参考:Centos7安装Hadoop2.7),集群情况如下:
| hostname | IP地址 | 部署规划 |
| node1 | 172.20.0.4 | NameNode、DataNode |
| node2 | 172.20.0.5 | DataNode |
| node3 | 172.20.0.6 | DataNode |
2、官网下载安装包:apache-hive-2.3.6-bin.tar.gz(推荐去清华大学或中科大的开源镜像站)。
安装
hive只需要部署在主节点node1上,解压apache-hive-2.3.6-bin.tar.gz到/mydata;
然后将 /mydata/apache-hive-2.3.6-bin 重命名为 /mydata/hive-2.3.6。
配置环境变量:
export HIVE_HOME=/mydata/hive-2.3.6

export PATH=${HIVE_HOME}/bin:$PATH
hive是通过环境变量HADOOP_HOME寻找hadoop集群的。
$HIVE_HOME/conf/hive-default.xml.template 中包含了几乎所有hive的默认配置,修改时需要在同目录新建一个hive-site.xml,然后从default中将需要修改的配置项拷贝过来进行修改即可。
元数据
hive必须要一个关系型数据库来保存元数据(metastore),默认是使用自带的derby,但这个是单会话形式,性能非常有限,没有实用价值。
所以这里直接换成常用的mysql(若没有可以参考:Centos7安装使用Mysql),在mysql中增加数据库和用户:
MariaDB> create database hive_metastore;

MariaDB> create user 'hive'@'%' identified by 'hpwd';

MariaDB> grant all on hive_metastore.* to 'hive'@'%';
在 $HIVE_HOME/conf/hive-site.xml 中配置mysql连接:
<configuration>

  <property>

    <name>javax.jdo.option.ConnectionURL</name>

    <value>jdbc:mysql://node1:3306/hive_metastore</value>

  </property>

  <property>

    <name>javax.jdo.option.ConnectionDriverName</name>

    <value>com.mysql.jdbc.Driver</value>

  </property>

  <property>

    <name>javax.jdo.option.ConnectionUserName</name>

    <value>hive</value>

  </property>

  <property>

    <name>javax.jdo.option.ConnectionPassword</name>

    <value>hpwd</value>

  </property>

</configuration>
通过中科大的源下载连接myql的jar包(中科大源:http://mirrors.ustc.edu.cn/mysql-ftp/Downloads/Connector-J/mysql-connector-java-5.1.48.zip),解压后将其中的:
mysql-connector-java-5.1.48.jar 拷贝到 $HIVE_HOME/lib。
然后在命令行初始化元数据库(看到 schemaTool completed 表示成功,也可以通过mysql看到hive_metastore中出现许多表):
shell> schematool -dbType mysql -initSchema
存储
hive真正用来分析统计的数据是保存在hdfs上。
官方教程要求使用下面的命令创建对应目录并赋予权限,但由于这边的hadoop和hive都是用的root用户,所以可以省略:
shell> hdfs dfs -mkdir       /tmp

shell> hdfs dfs -mkdir       /user/hive/warehouse

shell> hdfs dfs -chmod g+w   /tmp

shell> hdfs dfs -chmod g+w   /user/hive/warehouse
这两个目录(强调:这是hdfs上的)可以在hive-site.xml中修改下面两项:
hive.exec.scratchdir
hive.metastore.warehouse.dir
不过,没啥特殊要求不建议修改,因为还有挺多其他数据会写到/tmp/hive或/user/hive,要改当然最好都改;于是还是选择都不改吧,默认的路径也没啥不好。
另外,有两个本地的目录配置可以考虑改掉:
<property>

  <name>hive.exec.local.scratchdir</name>

  <value>/mydata/tmp/hive</value>

</property>

<property>

  <name>hive.querylog.location</name>

  <value>/mydata/logs/hive</value>

</property>
hive shell
命令行直接运行hive即可进入hive shell:
shell> hive

hive> create database xyz;

hive> show databases;

hive> use xyz;

hive> create table x (id int, name string);

hive> show tables;

hive> insert into x values(1, 'hive');

hive> insert into x values(3, 'hbase');

hive> insert into x values(2, 'hadoop');

hive> select * from x;
这些命令都不需要解释,与mysql可以说一模一样,表xyz.x的数据存储在hdfs上的 /user/hive/warehouse/xyz.db/x :

命令虽一样,但肯定可以发现执行insert时明显是完成了一个mapreduce的job;
没错,这就是hive的作用所在,它可以将sql语句转换为mapreduce的job,一条sql就可以完成几十上百行mapreduce代码的工作。
hiveserver2
上面是通过hive的命令进行操作的,而实际中肯定是要通过程序连接,提供这个功能的是hiveserver2。
在hive-site.xml中添加下面的配置:
<property>
  <name>hive.server2.authentication</name>
  <value>NOSASL</value>
</property>
<property>
  <name>hive.server2.enable.doAs</name>
  <value>false</value>
</property>
<property>

  <name>hive.server2.logging.operation.log.location</name>

  <value>/mydata/logs/hive/hiveserver2</value>

</property>
配置项 |
说明 |
hive.server2.authentication |
设置为NOSASL表示不进行身份验证;实际中当然要用验证,常用的是LDAP和KERBEROS,那就需要另开篇总结了 |
hive.server2.enable.doAs |
关闭用户代理,这个代理需要hadoop那边也开启才行 |
hive.server2.logging.operation.log.location |
日志路径 |
命令行直接运行hiveserver2即可启动,但这样会阻塞在前端,所以要启动到后台(停止用:kill -9 [pid]):
shell> nohup hiveserver2 > /mydata/logs/hive/hiveserver2/std.out >& &
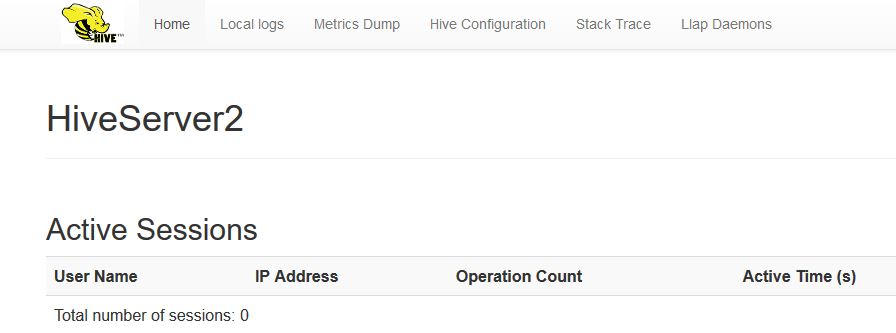
浏览器访问 http://node1:10002/ 可以看到一些hiveserver2服务的信息:
hive还自带了beeline工具作为客户端(通过jdbc)连接hiveserver2:
shell> beeline -u jdbc:hive2://node1:10000

beeline> show databaes;
下面是一段是根据官方示例进行了少许改动的Python代码:
shell> yum install gcc gcc-c++ make git python2-pip python-devel cyrus-sasl-devel -y  # 若缺少组件,无非是这里面的某个或某几个,根据报错信息判断,或直接全装
shell> pip install pyhs2  # Python操作hiveserver2的库
shell> vim t.py
    #!/bin/bash
    import pyhs2

    with pyhs2.connect(
        host='node1',
        port=10000,
        authMechanism="NOSASL",
        database='xyz') as conn:
        with conn.cursor() as cur:
            print cur.getDatabases()
            cur.execute("select * from x")
            print cur.getSchema()
            for i in cur.fetch():
                print i
shell> python t.py
    [['default', ''], ['xyz', '']]
    [{'comment': None, 'columnName': 'x.id', 'type': 'INT_TYPE'}, {'comment': None, 'columnName': 'x.name', 'type': 'STRING_TYPE'}]
    [1, 'hive']
    [2, 'hadoop']
    [3, 'hbase']
over
Centos7安装Hive2.3的更多相关文章
- CentOS7安装hive-2.1.0
环境: CentOS7 Hadoop-2.6.4,配置两个节点:master.slave1 mysql-server 过程: 下载.解压hive-2.1.0到/usr/hadoop-2.6.4/thi ...
- centos7安装Hive2.3.0
1.下载Hive2.3.0 wget http://mirror.bit.edu.cn/apache/hive/hive-2.3.0/apache-hive-2.3.0-bin.tar.gz 2.解压 ...
- HP服务器 hp 360g5 centos7安装问题
HP服务器 hp 360g5 centos7安装问题 一 :启动盘无法识别硬盘 1.进入安装光盘,用上下键选择安装centos--Install Centos7(注意不可按Enter键),如图: 2 ...
- CentOS7 安装Mono及Jexus
CentOS7安装Mono及Juxes 1 安装Mono 1.1 安装yum-utils 因为安装要用到yum-config-manager,默认是没有安装的,所以要先安装yum-utils包.命令如 ...
- CentOS7安装mysql提示“No package mysql-server available.”
针对centos7安装mysql,提示"No package mysql-server available."错误,解决方法如下: Centos 7 comes with Mari ...
- CentOS7安装Oracle 11gR2 安装
概述 Oracle 在Linux和window上的安装不太一样,公司又是Linux系统上的Oracle,实在没辙,研究下Linux下Oracle的使用,oracle默认不支持CentOS系统安装,所以 ...
- Centos7安装完毕后重启提示Initial setup of CentOS Linux 7 (core)的解决方法
问题: CentOS7安装完毕,重新开机启动后显示: Initial setup of CentOS Linux 7 (core) 1) [x] Creat user 2) [!] License i ...
- centos7安装eclipse
centos7安装eclipse Eclipse是一个集成开发环境(IDE),包含一个基工作区和定制环境的可扩展插件系统.大部分使用 Java 编写,Eclipse 可以用来开发应用程序.通过各种插件 ...
- CentOS7安装mongoDB数据库
CentOS7安装mongoDB数据库 时间:2015-03-03 16:45来源:blog.csdn.net 作者:进击的木偶 举报 点击:8795次 mongoDB是目前发展比较好的NOSQL数据 ...
随机推荐
- LeetCode 912. 排序数组(Sort an Array) 43
912. 排序数组 912. Sort an Array 题目描述 每日一算法2019/6/15Day 43LeetCode912. Sort an Array
- [转帖]美团在Redis上踩过的一些坑-1.客户端周期性出现connect timeout
美团在Redis上踩过的一些坑-1.客户端周期性出现connect timeout 博客分类: redis 运维 jedisconnect timeoutnosqltcp 转载请注明出处哈:http ...
- day49——圆形头像、定位、z-index、js
day49 今日内容 圆形头像 <!DOCTYPE html> <html lang="en"> <head> <meta charset ...
- Win10各个PC版本的差别
新的电脑有的已经不能够支持安装win7了,也就是说新电脑的硬件支持只能安装win10.那么win10有都有那些版本呢?这些版本之间又有什么样区别?我相信很多人并不是很了解.今天就来整理一下这些资料.据 ...
- ComPtr的介绍以及使用
ComPtr是为COM而设计的智能指针.它支持WindowsRT,也支持传统Win32.相比ATL里的CComPtr类,它有了一些提升. ComPtr包含在Windows 8.x SDK and Wi ...
- AspNetCore MVC页面数据提交验证
2019/05/14,AspNetCore 2.2.0 摘要:AspNetCore MVC使用数据注释配合jquery.validate提交页面进行前端加后端的数据验证 主要用到了jquery.val ...
- Python基础知识(三)
Python基础知识(三) 一丶整型 #二进制转成十进制的方法 # 128 64 32 16 8 4 2 1 1 1 1 1 1 1 例如数字5 : 101 #十进制转成二进制的方法 递归除取余数,从 ...
- Java中new和Class.forName的区别
首先:New = Class.forName("pacage.A").newInstance(); new是关键字,直接创建对象.Class.forName()是一个方法,要求JV ...
- 【Excel】【Salesforce】函数拓展
1.if 2.vlookup
- Kali软件库认识
对kali上的软件进行一个初步的认识 信息收集 dmitry -o 将输出保存到%host.txt或由-o文件指定的文件 -i 对主机的IP地址执行whois查找 -w 对主机的域名执行whois查找 ...