
论文解读(XR-Transformer)Fast Multi-Resolution Transformer Fine-tuning for Extreme Multi-label Text Classification
Paper Information
Title:Fast Multi-Resolution Transformer Fine-tuning for Extreme Multi-label Text Classification
Authors:Jiong Zhang, Wei-Cheng Chang, Hsiang-Fu Yu, I. Dhillon
Sources:2021, ArXiv
Other:3 Citations, 61 References
Paper:download
Code:download
1 背景知识
训练集 $\left\{\mathbf{x}_{i}, \mathbf{y}_{i}\right\}_{i=1}^{N} $,$\mathbf{x}_{i} \in \mathcal{D}$ 代表着第 $i$ 个文档,$\mathbf{y}_{i} \in\{0,1\}^{L}$ 是第$i$个样本的第 $\ell$ 个标签。
eXtreme Multi-label Text Classification (XMC) 目标是寻找一个这样的函数 $f: \mathcal{D} \times[L] \mapsto \mathbb{R}$,$f(x,\ell)$ 表示输入 $x$ 与标签 $\ell$ 之间的相关性。
实际上,得到 $top-k$ 个最大值的索引作为给定输入 $x$ 的预测相关标签。最直接的模型是一对全(OVA)模型:
$f(\mathbf{x}, \ell)=\mathbf{w}_{\ell}^{\top} \Phi(\mathbf{x}) ; \ell \in[L]\quad\quad\quad(1)$
其中
- $\mathbf{W}=\left[\mathbf{w}_{1}, \ldots, \mathbf{w}_{L}\right] \in \mathbb{R}^{d \times L}$ 是权重向量
- $\Phi(\cdot)$ 是一个文本向量转换器,$\Phi: \mathcal{D} \mapsto \mathbb{R}^{d}$用于将 $\mathbf{x}$转换为 $d$ 维特征向量
为了处理非常大的输出空间,最近的方法对标签空间进行了划分,以筛选在训练和推理过程中考虑的标签。特别是 [7, 12, 13, 34, 35, 39] 遵循三个阶段的框架:partitioning、shortlisting 和 ranking。
首先 partitioning 过程,将标签分成 $K$ 个簇 $\mathbf{C} \in\{0,1\}^{L \times K}$ ,$C_{\ell, k}=1$ 代表这标签 $\ell $ 在第 $k$ 个簇中。
然后 shortlisting 过程,将输入 $x$ 映射到相关的簇当中:
$g(\mathbf{x}, k)=\hat{\mathbf{w}}_{k}^{\top} \Phi_{g}(\mathbf{x}) ; k \in[K]\quad\quad\quad(2)$
最后 ranking 过程,在 shortlisted 上训练一个输出大小为 $L $ 的分类模型:
$f(\mathbf{x}, \ell)=\mathbf{w}_{\ell}^{\top} \Phi(\mathbf{x}) ; \ell \in S_{g}(\mathbf{x})\quad\quad\quad(3)$
其中 $S_{q}(\mathbf{x}) \subset[L]$ 是标签集的一个子集。
对于基于 transformer 的方法,主要花费的时间是 $\Phi(\mathbf{x})$ 的评价。但是 $K$ 值太大或太小仍然可能会有问题。实证结果表明,当 cluster 的大小 $B$ 太大时,模型的性能会下降。典型的 X-Transformer 和 LightXML ,他们的簇大小$B$ 通常 $B(\leq 100)$ ,聚类数 $K$ 通常为 $K \approx L / B$。
2 XR-Transformer 方法
在 XR-Transformer 中,我们递归地对 shortlisting 问题应用相同的三阶段框架,直到达到一个相当小的输出大小 $\frac{L}{B^{D}}$。
2.1 Hierarchical Label Tree (HLT)
递归生成标签簇 $D$ 次,相当于构建一个深度为 $D$ 的 HLT。我们首先构建标签特征 $\mathbf{Z} \in \mathbb{R}^{L \times \hat{d}}$。这可以通过在标签文本上应用文本向量量化器,或者从 Positive Instance Feature Aggregation(PIFA) 中实现:
$\mathbf{Z}_{\ell}=\frac{\mathbf{v}_{\ell}}{\left\|\mathbf{v}_{\ell}\right\|} ; \text { where } \mathbf{v}_{\ell}=\sum\limits _{i: y_{i, \ell}=1} \Phi\left(\mathbf{x}_{i}\right), \forall \ell \in[L]\quad\quad\quad(4)$
其中:$\Phi: \mathcal{D} \mapsto \mathbb{R}^{d}$是文本向量化转换器。
使用平衡的 k-means($k=B$) 递归地划分标签集,并以自上而下的方式生成 HLT。
$\left\{\mathbf{C}^{(t)}\right\}_{t=1}^{D}$
其中 $\mathbf{C}^{(t)} \in\{0,1\}^{K_{t} \times K_{t-1}}$ with $K_{0}=1$、$K_{D}=L$
2.2 Multi-resolution Output Space
粗粒度的标签向量可以通过对原始标签进行max-pooling得到(在标签空间中)。第 $t$ 层的真实标签(伪标签)为:
$\mathbf{Y}^{(t)}=\operatorname{binarize}\left(\mathbf{Y}^{(t+1)} \mathbf{C}^{(t+1)}\right)\quad\quad\quad(5)$
然而,直接用以上训练方式会造成信息损失。直接做max-pooling的方法无法区分:一个cluster中有多个真实标签和一个cluster中有一个真实标签。直观上,前者应该有更高的权重。
因而,通过一个非负的重要性权重指示每个样本对每个标签的重要程度:
$\mathbf{R}^{(t)} \in \mathbb{R}_{+}^{N \times K_{t}}$
该重要性权重矩阵通过递归方式构建,最底层的重要性权重为原始 标签归一化。之后递归地将上一层的结果传递到下一层。
$\mathbf{R}^{(t)}=\mathbf{R}^{(t+1)} \mathbf{C}^{(t+1)} \quad \quad (6)$
$\mathbf{R}^{(D)}=\mathbf{Y}^{(D)}$
其中:
$\hat{R}_{i, j}^{(t)}=\left\{\begin{array}{ll}\frac{R_{i, j}^{(t)}}{\left\|\mathbf{R}_{i}^{(t)}\right\|_{1}} & \text { if } Y_{i, j}^{(t)}=1 \\ \alpha & \text { otherwise } \end{array}\right.$
2.3 Label Shortlisting
在每一层,不能只关注于少量真实的标签,还需要关注于一些高置信度的非真实标签。(因为分类不是100%准确,要给算法一些容错度,之后用 beam search 矫正)
在每一层,将模型预测出的 top-k relevant clusters 作为父节点。因而,在第 $t$ 层我们需要考虑 $t-1$ 层的标签列表。
$\begin{aligned}&\mathbf{P}^{(t-1)} =\operatorname{Top}\left(\mathbf{W}^{(t-1) \top} \Phi\left(\mathbf{X}, \Theta^{(t-1)}\right), k\right)\quad\quad\quad(7)\\&\mathbf{M}^{(t)} =\operatorname{binarize}\left(\mathbf{P}^{(t-1)} \mathbf{C}^{(t) \top}\right)+\operatorname{binarize}\left(\mathbf{Y}^{(t-1)} \mathbf{C}^{(t) \top}\right)\quad\quad\quad(8)\end{aligned}$
2.4 Training with bootstrapping
我们利用递归学习结构,通过模型自举来解决这个问题。
$\mathbf{W}_{i n i t}^{(t)}:=\underset{\mathbf{W}^{(t)}}{\operatorname{argmin}} \sum\limits _{i=1}^{N} \sum\limits_{\ell: \mathbf{M}_{i, \ell}^{(t)} \neq 0} \hat{R}_{i, \ell}^{(t)} \mathcal{L}\left(Y_{i, \ell}^{(t)}, \mathbf{W}_{\ell}^{(t) \top} \Phi_{d n n}\left(\mathbf{x}_{i}, \boldsymbol{\theta}^{(t-1) *}\right)\right)+\lambda\left\|\mathbf{W}^{(t)}\right\|^{2}\quad\quad\quad(11)$
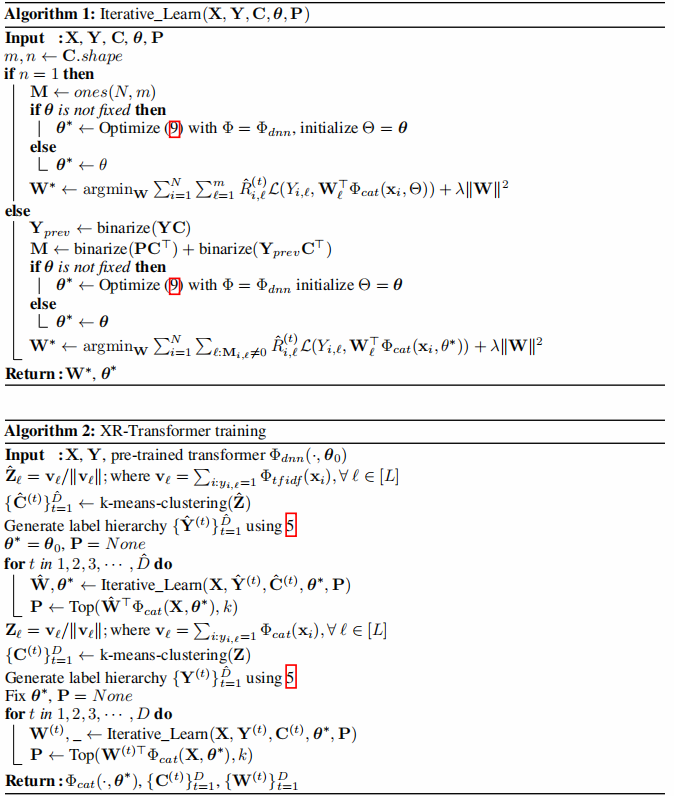
3 Algorithm
论文解读(XR-Transformer)Fast Multi-Resolution Transformer Fine-tuning for Extreme Multi-label Text Classification的更多相关文章
- Fauce:Fast and Accurate Deep Ensembles with Uncertainty for Cardinality Estimation 论文解读(VLDB 2021)
Fauce:Fast and Accurate Deep Ensembles with Uncertainty for Cardinality Estimation 论文解读(VLDB 2021) 本 ...
- 目标检测论文解读3——Fast R-CNN
背景 deep ConvNet兴起,VGG16应用在图像分类任务上表现良好,本文用VGG16来解决检测任务.SPP NET存在CNN层不能fine tuning的缺点,且之前的方法训练都是分为多个阶段 ...
- [论文解读] 阿里DIEN整体代码结构
[论文解读] 阿里DIEN整体代码结构 目录 [论文解读] 阿里DIEN整体代码结构 0x00 摘要 0x01 文件简介 0x02 总体架构 0x03 总体代码 0x04 模型基类 4.1 基本逻辑 ...
- 论文解读丨表格识别模型TableMaster
摘要:在此解决方案中把表格识别分成了四个部分:表格结构序列识别.文字检测.文字识别.单元格和文字框对齐.其中表格结构序列识别用到的模型是基于Master修改的,文字检测模型用到的是PSENet,文字识 ...
- NLP论文解读:无需模板且高效的语言微调模型(上)
原创作者 | 苏菲 论文题目: Prompt-free and Efficient Language Model Fine-Tuning 论文作者: Rabeeh Karimi Mahabadi 论文 ...
- AAAI2019 | 基于区域分解集成的目标检测 论文解读
Object Detection based on Region Decomposition and Assembly AAAI2019 | 基于区域分解集成的目标检测 论文解读 作者 | 文永亮 学 ...
- Gaussian field consensus论文解读及MATLAB实现
Gaussian field consensus论文解读及MATLAB实现 作者:凯鲁嘎吉 - 博客园 http://www.cnblogs.com/kailugaji/ 一.Introduction ...
- 论文解读第三代GCN《 Deep Embedding for CUnsupervisedlustering Analysis》
Paper Information Titlel:<Semi-Supervised Classification with Graph Convolutional Networks>Aut ...
- VLDB'22 HiEngine极致RTO论文解读
摘要:<Index Checkpoints for Instant Recovery in In-Memory Database Systems>是由华为云数据库创新Lab一作发表在数据库 ...
随机推荐
- LabVIEW,控件快捷菜单,温度转换
目前正在自学LabVIEW,深感困难重重,我将偶尔发表一些自己的收获,自认为算是干货了, 搜到这篇随笔的朋友们或多或少遇到了些许困难,希望这能帮助到你们. 内容:练习使用LabVIEW中的控件快捷菜单 ...
- think php 软删除
<a href="/admin/exam/delete/id/{$v.id}" onclick="if(confirm('确认删除?')) location.hre ...
- layui ajax删除
表单页面 //监听行工具事件 table.on('tool(test)', function(obj){ var data = obj.data; //console.log(obj) if(obj. ...
- 判断jQuery是否加载,如果未加载则加载
一般情况返回的js这么写history.go(-1) 但是如果是从别人分享过来的,就没有反应 所以就做个判断,没有上一页就返回首页 if (typeof jQuery == 'undefined') ...
- k-means聚类:擒贼先擒王,找到中心点,它附近的都是一类
属于无监督学习,聚类算法事先并不需要知道数据的类别标签,只是根据数据特征去学习,找到相似数据的特征,然后把已知的数据集划分成几个不同的类别 算法原理: 假设数据总共有m条,计划分成3个类别 先随机在这 ...
- linux下更改文件字符格式为uft-8
liunx下发布的.net Core 程序,发现短信签名不错误不能发出.后来检查发现配配文件中的字符为乱码才知道是因为字符格式问题. 因为服务器批较多,还是使用命令来解决比较快.使用iconv来更改. ...
- VS2010 显示TFS删除项
通过 TFS 是删除的工程显示出来, 操作步骤.Tools->Options-> Source Control ->Visual Studio Team Foundation Ser ...
- QFramework Pro 开发日志(七)v0.4 版本审核通过 与 对话编辑器功能预告
经过一周的工作,v0.4 版本总算完成了. 就在刚刚笔者在 AssetStore 提交了 v0.4 版本. v0.4 版本主要内容有两个 一键生成简单继承类图功能 底层兼容 QFramework v0 ...
- Python的安装教程与环境配置
安装环境:Windows7或者Windows10 Python版本:最新即可,这里选用 python 3.7.2: 一.下载:在python的官网下载python版本,需要下载对应版本(在计算机-属性 ...
- 关于linux下的open()write()read()close()函数
http://blog.sina.com.cn/s/blog_71d1a98701010s0v.html 1.read和write函数调用时,都会记录下当前写的位置,下次调用时就会从这个位置开始读或写 ...