
Spark基本知识
Spark基本知识
Spark 是一种基于内存的快速、通用、可扩展的大数据分析计算引擎。
spark与hadoop的区别
Hadoop
- Hadoop 是由 java 语言编写的,在分布式服务器集群上存储海量数据并运行分布式
分析应用的开源框架
- 作为 Hadoop 分布式文件系统,HDFS 处于 Hadoop 生态圈的最下层,存储着所有
的 数 据 , 支 持 着 Hadoop 的 所 有 服 务 。 它 的 理 论 基 础 源 于 Google 的
TheGoogleFileSystem 这篇论文,它是 GFS 的开源实现。
- MapReduce 是一种编程模型,Hadoop 根据 Google 的 MapReduce 论文将其实现,
作为 Hadoop 的分布式计算模型,是 Hadoop 的核心。基于这个框架,分布式并行
程序的编写变得异常简单。综合了 HDFS 的分布式存储和 MapReduce 的分布式计
算,Hadoop 在处理海量数据时,性能横向扩展变得非常容易。
- HBase 是对 Google 的 Bigtable 的开源实现,但又和 Bigtable 存在许多不同之处。
HBase 是一个基于 HDFS 的分布式数据库,擅长实时地随机读/写超大规模数据集。
它也是 Hadoop 非常重要的组件。
Spark
Spark 是一种由 Scala 语言开发的快速、通用、可扩展的大数据分析引擎
Spark Core 中提供了 Spark 最基础与最核心的功能
Spark SQL 是 Spark 用来操作结构化数据的组件。通过 Spark SQL,用户可以使用
SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。
- Spark Streaming 是 Spark 平台上针对实时数据进行流式计算的组件,提供了丰富的
处理数据流的 API。
Spark的四大特性
- Simple(易用性)
Spark 提供了丰富的高级运算操作,支持丰富的算子,并支持 Java、Python、Scala、R、SQL 等语言的 API,使用户可以快速构建不同的应用。
开发人员只需调用 Spark 封装好的 API 来实现即可,无需关注 Spark 的底层架构。
Fast(速度快)
Spark 将处理的每个任务都构造成一个DAG(Directed Acyclic Graph, 有向无环图)来执行,实现原理是基于RDD(Resilient Distributed Dataset, 弹性分布式数据集)在内存中对数据进行迭代计算,以实现批量和流式数据的高性能快速计算处理。Spark比MR速度快的原因
基于内存
mapreduce任务后期再计算的时候,每一个job的输出结果会落地到磁盘,后续有其他的job需要依赖于前面job的输出结果,这个时候就需要进行大量的磁盘io操作。性能就比较低。
spark任务后期再计算的时候,job的输出结果可以保存在内存中,后续有其他的job需要依赖于前面job的输出结果,这个时候就直接从内存中获取得到,避免了磁盘io操作,性能比较高
对于spark程序和mapreduce程序都会产生shuffle阶段,在shuffle阶段中它们产生的数据都会落地到磁盘。
进程与线程
mapreduce任务以进程的方式运行在yarn集群中,比如程序中有100个MapTask,一个task就需要一个进程,这些task要运行就需要开启100个进程。
spark任务以线程的方式运行在进程中,比如程序中有100个MapTask,后期一个task就对应一个线程,这里就不再是进程,这些task需要运行,这里可以极端一点:只需要开启1个进程,在这个进程中启动100个线程就可以了。
进程中可以启动很多个线程,而开启一个进程与开启一个线程需要的时间和调度代价是不一样。 开启一个进程需要的时间远远大于开启一个线程。## Scalable(可融合性)
Unified(通用性)
大数据处理的传统方案需要维护多个平台,比如,离线任务是放在 Hadoop MapRedue 上运行,实时流计算任务是放在 Storm 上运行。
而Spark 提供了一站式的统一解决方案,可用于批处理、交互式查询(Spark SQL)、实时流处理(Spark Streaming)、机器学习(Spark MLlib)和图计算(GraphX)等。这些不同类型的处理都可以在同一个应用中无缝组合使用。
- Scalable(兼容性)
Spark 可以非常方便地与其他的开源产品进行融合。比如:Spark 可以使用 Hadoop 的 YARN 和 Apache Mesos 作为它的资源管理和调度器;可以处理所有 Hadoop 支持的数据,包括 HDFS、HBase 和 Cassandra 等。
Spark运行模式
| 运行模式 | 运行类型 | 说明 |
|---|---|---|
| Local | 本地模式 | 常用于本地开发,分为Local单线程和Local-Cluster多线程模式 |
| Standalone | 集群模式 | 独立模式,在Spark自己的资源调度管理框架上运行,该框架采用master/salve结构 |
| ON YARN | 集群模式 | 用于生产环境,在YARN资源管理器框架上运行,由YARN负责资源管理,Spark负责任务调度和计算 |
| ON Mesos | 集群模式 | 用于生产环境,在Mesos资源管理器框架上运行,由Mesos责资源管理,Spark负责任务调度和计算 |
| ON Cloud | 集群模式 | 运行在AWS、阿里云等环境 |
Spark核心模块
Spark Core
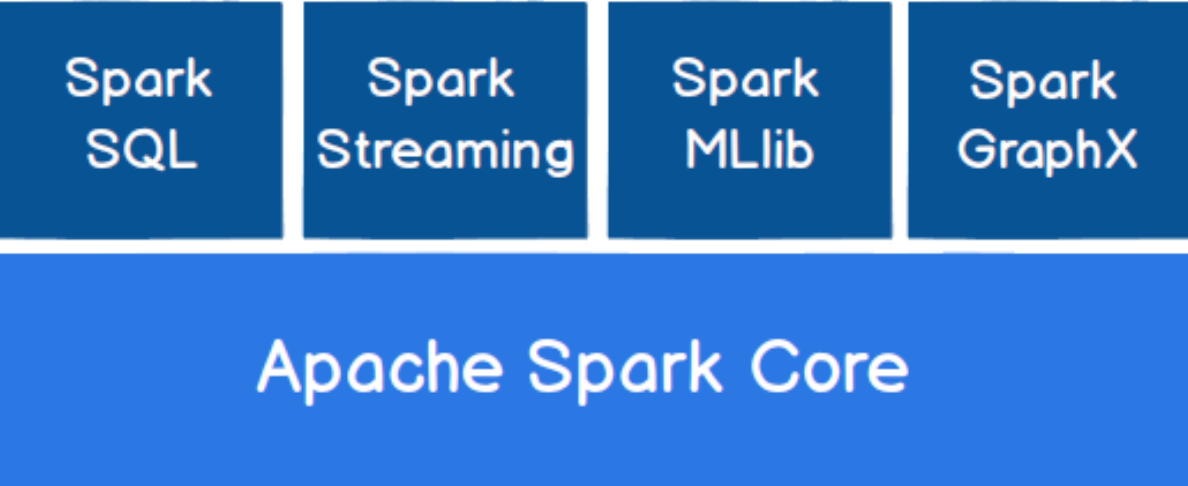
Spark Core 中提供了 Spark 最基础与最核心的功能,Spark 其他的功能如:Spark SQL,
Spark Streaming,GraphX, MLlib 都是在 Spark Core 的基础上进行扩展的
Spark SQL
Spark SQL 是 Spark 用来操作结构化数据的组件。通过 Spark SQL,用户可以使用 SQL
或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。
Spark Streaming
Spark Streaming 是 Spark 平台上针对实时数据进行流式计算的组件,提供了丰富的处理
数据流的 API。
Spark MLlib
MLlib 是 Spark 提供的一个机器学习算法库。MLlib 不仅提供了模型评估、数据导入等
额外的功能,还提供了一些更底层的机器学习原语。
Spark GraphX
GraphX 是 Spark 面向图计算提供的框架与算法库。
Spark基本知识的更多相关文章
- 最全的spark基础知识解答
原文:http://www.36dsj.com/archives/61155 一. Spark基础知识 1.Spark是什么? UCBerkeley AMPlab所开源的类HadoopMapReduc ...
- spark基础知识(1)
一.大数据架构 并发计算: 并行计算: 很少会说并发计算,一般都是说并行计算,但是并行计算用的是并发技术.并发更偏向于底层.并发通常指的是单机上的并发运行,通过多线程来实现.而并行计算的范围更广,他是 ...
- spark基础知识
1.Spark是什么? UCBerkeley AMPlab所开源的类HadoopMapReduce的通用的并行计算框架. dfsSpark基于mapreduce算法实现的分布式计算,拥有HadoopM ...
- spark基础知识介绍2
dataframe以RDD为基础的分布式数据集,与RDD的区别是,带有Schema元数据,即DF所表示的二维表数据集的每一列带有名称和类型,好处:精简代码:提升执行效率:减少数据读取; 如果不配置sp ...
- spark基础知识介绍(包含foreachPartition写入mysql)
数据本地性 数据计算尽可能在数据所在的节点上运行,这样可以减少数据在网络上的传输,毕竟移动计算比移动数据代价小很多.进一步看,数据如果在运行节点的内存中,就能够进一步减少磁盘的I/O的传输.在spar ...
- spark重点知识
1 scala 2 spark rdd 3 sprak core 4 性能优化 5 spark sql 6 spark streaming 掌握程度-精通的理解:
- spark基础知识四
围绕spark的其他特性和应用.主要包括以下几个方面 spark自定义分区 spark中的共享变量 spark程序的序列化问题 spark中的application/job/stage/task之间的 ...
- spark基础知识三
主要围绕spark的底层核心抽象RDD和原理进行理解.主要包括以下几个方面 RDD弹性分布式数据集的依赖关系 RDD弹性分布式数据集的lineage血统机制 RDD弹性分布式数据集的缓存机制 spar ...
- spark基础知识二
主要围绕spark的底层核心抽象RDD进行理解.主要包括以下几个方面 RDD弹性分布式数据集的概念 RDD弹性分布式数据集的五大属性 RDD弹性分布式数据集的算子操作分类 RDD弹性分布式数据集的算子 ...
随机推荐
- HCIA-datacom 4.3 实验三:网络地址转换配置实验
实验介绍: 网络地址转换NAT(Network Address Translation)是将IP数据报文头中的IP地址转换为另一个IP地址的过程.作为减缓IP地址枯竭的一种过渡方案,NAT通过地址重用 ...
- VM虚拟机安装和使用
作者:菘蓝 时间:2022/8/30 ================================================================================= ...
- 创建一个k8s私有仓库-harbor
〇.前言 这一步应该是在搭建k8s之前做好,注意了奥 一.安装docker和docker-compose 1.下载docker-compose的最新版本 # 建议那种网上冲浪下载!,下载下来记得命名成 ...
- MySQL建表语句生成Golang代码
1. 背景 对于后台开发新的需求时,一般会先进行各种表的设计,写各个表的建表语句 然后根据建立的表,写对应的model代码.基础的增删改查代码(基础的增删改查服务可以划入DAO(Data Access ...
- SpringBoot 配置文件使用详解
一.创建一个SpringBoot项目 创建 SprintBoot 项目的 2 种方式: 在 https://start.spring.io/ 上创建一个 SpringBoot 项目,然后导入到 IDE ...
- 详述ProxySQL的路由规则 --- 实践篇
转载自:https://blog.csdn.net/weixin_30911809/article/details/98601663 关于ProxySQL路由的简述 当ProxySQL收到前端app发 ...
- 深入探究 K8S ConfigMap 和 Secret
ConfigMap 1.什么是 ConfigMap? ConfigMap 是用来存储配置文件的 Kubernetes 资源对象,配置对象存储在 Etcd 中,配置的形式可以是完整的配置文件.key/v ...
- 通俗易懂理解 MySQL B+树、数据存储、索引等知识
文章转载自:https://mp.weixin.qq.com/s?__biz=MzI1MDgwNzQ1MQ==&mid=2247485630&idx=1&sn=681c9c0d ...
- Python(一)转义字符及操作符
转义字符 描述 \(在行尾时) 续航符 \\ 反斜杠符号 \' 单引号 \'' 双引号 \a 响铃 \b 退格(Backspace) \e 转义 \000 空 \n 转行 \v 纵向制表符 \t 横向 ...
- 欢迎来到ktq_cpp的cnblog
欢迎来到ktq_cpp的cnblog 初学html,可能排版有一些问题,望指教 我的洛谷博客 我的AtCoder账号