
加班?不存在的啦~Python处理Excel,学会这十四个方法,工作量减少大半
现在Python横行的年代,财务、人事、行政等等岗位多少得学点Python,省事又不费脑!
所有操作都用Python自动实现,
加班?不存在的!
excel和python其实都是工具,不要也不用拿去做对比,研究哪个好用,excel作为最为全球广泛的数据处理工具,垄断多年,肯定在数据处理方面有自己的优点,Python只是令 一些庞大的,费时间的操作加速处理,方便工作嘛。
当然也有很多excel的操作比用Python自动处理更加简单方便。
比如:对各列求和并在最下一行显示出来,excel就是对一列总一个sum()函数,然后往左一拉就解决,而python则要定义一个函数,python要判断格式,若非数值型数据会直接。我就不一一举例了!
好了,我们开始正题。
在网上找的销售数据,差不多长这样。
销售数据
1、数据透视表
需求
想知道每个地区的业务员分别赚取的利润总和与利润平均数
pd.pivot_table(sale,index="地区名称",columns="业务员名称",values="利润",aggfunc=[np.sum,np.mean])
兄弟们学习python,有时候不知道怎么学,从哪里开始学。掌握了基本的一些语法或者做了两个案例后,不知道下一步怎么走,不知道如何去学习更加高深的知识。
那么对于这些大兄弟们,我准备了大量的免费视频教程,PDF电子书籍,以及视频源的源代码!
还会有大佬解答!
都在这个裙里了
点我快速进入
欢迎加入,一起讨论 一起学习!
2、去除重复值
需求
去除业务员编码的重复值
sale.drop_duplicates("业务员编码",inplace=True)
3、分类汇总
需求
北京区域各业务员的利润总额
sale.groupby(["地区名称","业务员名称"])["利润"].sum()
4、关联公式:Vlookup
vlookup是excel几乎最常用的公式,一般用于两个表的关联查询等。
所以我先把这张表分为两个表。
df1=sale[['订单明细号','单据日期','地区名称', '业务员名称','客户分类', '存货编码', '客户名称', '业务员编码', '存货名称', '订单号',

       '客户编码', '部门名称', '部门编码']]

df2=sale[['订单明细号','存货分类', '税费', '不含税金额', '订单金额', '利润', '单价','数量']]
需求
想知道df1的每一个订单对应的利润是多少
利润一列存在于df2的表格中,所以想知道df1的每一个订单对应的利润是多少。
用excel的话首先确认订单明细号是唯一值,然后在df1新增一列写:=vlookup(a2,df2!a:h,6,0) ,然后往下拉就ok了。
那用python是如何实现的呢?
#查看订单明细号是否重复,结果是没。

df1["订单明细号"].duplicated().value_counts()

df2["订单明细号"].duplicated().value_counts()

df_c=pd.merge(df1,df2,on="订单明细号",how="left")
5、条件计算
需求
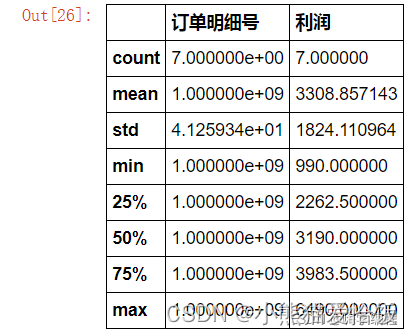
存货名称含“三星字眼”并且税费高于1000的订单有几个?
这些订单的利润总和和平均利润是多少?(或者最小值,最大值,四分位数,标注差)
sale.loc[sale["存货名称"].str.contains("三星")&(sale["税费"]>=1000)][["订单明细号","利润"]].describe()
6、分组
需求
根据利润数据分布把地区分组为:“较差”,“中等”,“较好”,“非常好”
首先,当然是查看利润的数据分布呀,这里我们采用四分位数去判断。
sale.groupby("地区名称")["利润"].sum().describe()
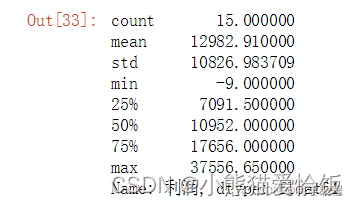
根据四分位数把地区总利润为[-9,7091]区间的分组为“较差”,(7091,10952]区间的分组为"中等"
(10952,17656]分组为较好,(17656,37556]分组为非常好。
#先建立一个Dataframe

sale_area=pd.DataFrame(sale.groupby("地区名称")["利润"].sum()).reset_index()

#设置bins,和分组名称

bins=[-10,7091,10952,17656,37556]

groups=["较差","中等","较好","非常好"]

#使用cut分组

#sale_area["分组"]=pd.cut(sale_area["利润"],bins,labels=groups)
7、对比两列差异
因为这表每列数据维度都不一样,比较起来没啥意义,所以我先做了个订单明细号的差异再进行比较。
需求:比较订单明细号与订单明细号2的差异并显示出来。
sale["订单明细号2"]=sale["订单明细号"]

#在订单明细号2里前10个都+1.

sale["订单明细号2"][1:10]=sale["订单明细号2"][1:10]+1

#差异输出

result=sale.loc[sale["订单明细号"].isin(sale["订单明细号2"])==False]
8、异常值替换
首先用describe()函数简单查看一下数据有无异常值。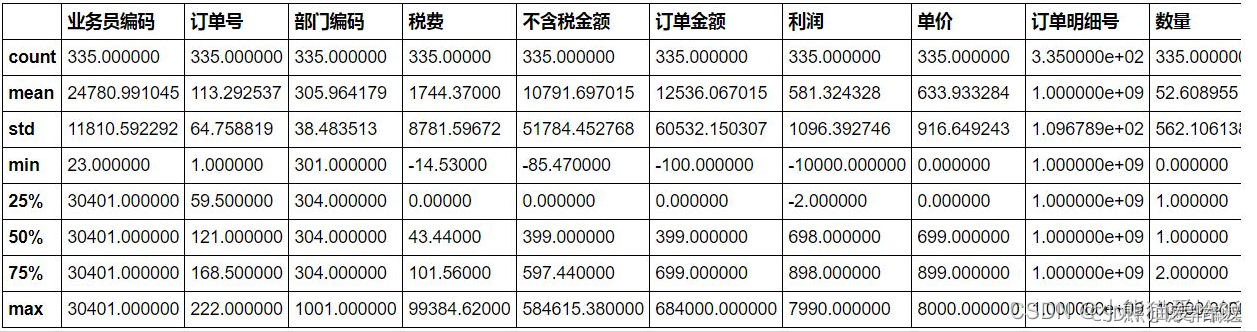
需求
用0代替异常值。
sale["订单金额"]=sale["订单金额"].replace(min(sale["订单金额"]),0)
9、缺失值处理
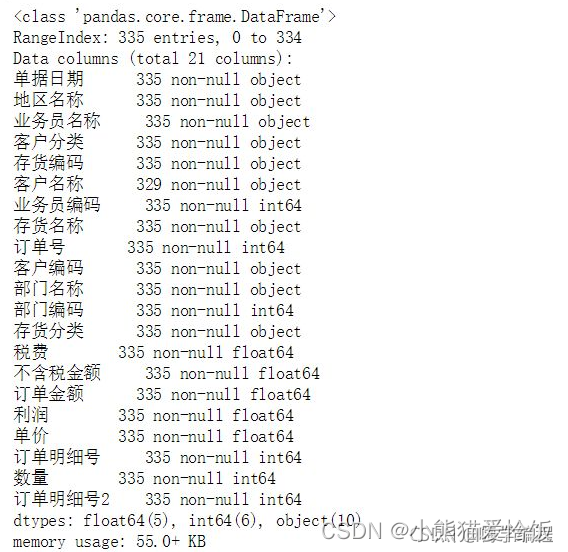
先查看销售数据哪几列有缺失值
#列的行数小于index的行数的说明有缺失值,这里客户名称329<335,说明有缺失值

sale.info()
需求
用0填充缺失值或则删除有客户编码缺失值的行
实际上缺失值处理的办法是很复杂的,这里只介绍简单的处理方法,若是数值变量,最常用平均数或中位数或众数处理,比较复杂的可以用随机森林模型根据其他维度去预测结果填充。
若是分类变量,根据业务逻辑去填充准确性比较高。
比如这里的需求填充客户名称缺失值:就可以根据存货分类出现频率最大的存货所对应的客户名称去填充。
这里我们用简单的处理办法:用0填充缺失值或则删除有客户编码缺失值的行。
#用0填充缺失值

sale["客户名称"]=sale["客户名称"].fillna(0)

#删除有客户编码缺失值的行

sale.dropna(subset=["客户编码"])
10、数据分列

需求
将日期与时间分列
sale=pd.merge(sale,pd.DataFrame(sale["单据日期"].str.split(" ",expand=True)),how="inner",left_index=True,right_index=True)
11、 模糊筛选数据
需求
筛选存货名称含有"三星"或则含有"索尼"的信息
sale.loc[sale["存货名称"].str.contains("三星|索尼")]
12、删除数据间的空格
需求
删除存货名称两边的空格
sale["存货名称"].map(lambda s :s.strip(""))
13、根据业务逻辑定义标签
需求
销售利润率(即利润/订单金额)大于30%的商品信息并标记它为优质商品,小于5%为一般商品。
sale.loc[(sale["利润"]/sale["订单金额"])>0.3,"label"]="优质商品"

sale.loc[(sale["利润"]/sale["订单金额"])<0.05,"label"]="一般商品"
14、多条件筛选
需求
想知道业务员张爱,在北京区域卖的商品订单金额大于6000的信息。
sale.loc[(sale["地区名称"]=="北京")&(sale["业务员名称"]=="张爱")&(sale["订单金额"]>5000)]
这里只是列举了一些比较常用的,但是excel常用的操作还有很多,如果还想实现哪些操作,大家可以在评论区一起交流。大家如果对这这些操作有更好的写法,也可以在评论区一起交流!感谢!
加班?不存在的啦~Python处理Excel,学会这十四个方法,工作量减少大半的更多相关文章
- Python之路【第十四篇】:AngularJS --暂无内容-待更新
Python之路[第十四篇]:AngularJS --暂无内容-待更新
- Python 3标准库 第十四章 应用构建模块
Python 3标准库 The Python3 Standard Library by Example -----------------------------------------第十四章 ...
- python学习笔记:(十四)面向对象
1.类(class): 用来描述具有相同的属性和方法的对象的集合.它定义了该集合中每个对象所共有的属性和方法 2.类变量: 类变量在整个实例化的对象中是公用的.类变量定义在类中且在函数体之外.类变量通 ...
- Python之路,第十四篇:Python入门与基础14
python3 模块2 标准模块 随机模块random 假设导入 import random as R 函数: R.random() 返回一个[0 ,1) 之间的随机数 R.getr ...
- Python之路【第二十四篇】Python算法排序一
什么是算法 1.什么是算法 算法(algorithm):就是定义良好的计算过程,他取一个或一组的值为输入,并产生出一个或一组值作为输出.简单来说算法就是一系列的计算步骤,用来将输入数据转化成输出结果. ...
- Python之路【第二十四篇】:Python学习路径及练手项目合集
Python学习路径及练手项目合集 Wayne Shi· 2 个月前 参照:https://zhuanlan.zhihu.com/p/23561159 更多文章欢迎关注专栏:学习编程. 本系列Py ...
- python运维开发(二十四)----crm权限管理系统
内容目录: 数据库设计 easyUI的使用 数据库设计 权限表Perssion 角色表Role 权限和角色关系表RoleToPermission 用户表UserInfo 用户和角色关系表UserInf ...
- Python学习笔记【第十四篇】:Python网络编程二黏包问题、socketserver、验证合法性
TCP/IP网络通讯粘包问题 案例:模拟执行shell命令,服务器返回相应的类容.发送指令的客户端容错率暂无考虑,按照正确的指令发送即可. 服务端代码 # -*- coding: utf- -*- # ...
- Python学习之旅(十四)
Python基础知识(13):函数(Ⅳ) Python内置函数 1.abs:取绝对值 abs(-1) 1 2.all:把序列中的每一个元素拿出来做布尔运算,都为真则返回True,如果序列中有None. ...
随机推荐
- CVPR 2022数据集汇总|包含目标检测、多模态等方向
前言 本文收集汇总了目前CVPR 2022已放出的一些数据集资源. 转载自极市平台 欢迎关注公众号CV技术指南,专注于计算机视觉的技术总结.最新技术跟踪.经典论文解读.CV招聘信息. M5Produc ...
- 【PostgreSQL】入门学习笔记
前言: 以下内容为前几天在备考PostgreSQL入门考试时候做的笔记,经过了全职的两天的奋战与实验,并最终顺利通过了PCA初级认证考试.现在把我学习的笔记分享给大家,文中有对应的思维导图图片可供 ...
- Python 爬取1688货源重量,自动发邮件到指定邮箱(qq),设置定时运行程序
1 # -*- coding: utf-8 -*- 2 # @Time : 2020/7/6 13:46 3 # @Author : Chunfang 4 # @Email : 3470959534@ ...
- 【笔记】排查CPU占用过高
本文是该教程视频的笔记 https://www.bilibili.com/video/BV15T4y1y7eH 1. 问题演示 将演示项目打包放到服务器运行 执行 curl http://localh ...
- XCTF练习题---MISC---pdf
XCTF练习题---CRYPTO---混合编码解析 flag:flag{security_through_obscurity} 解题步骤: 1.观察题目,下载附件 2.根据题目提示,下载文件,发现是一 ...
- 2003031121-浦娟-python数据分析第三周作业-第一次作业
项目 内容 课程班级博客链接 https://edu.cnblogs.com/campus/pexy/20sj 作业链接 https://edu.cnblogs.com/campus/pexy/20s ...
- 如何在 pyqt 中解决启用 DPI 缩放后 QIcon 模糊的问题
问题描述 如今显示器的分辨率越来越高,如果不启用 DPI 缩放,软件的字体和图标在高分屏下就会显得非常小,看得很累人.从 5.6 版本开始,Qt 便能支持 DPI 缩放功能,Qt6 开始这个功能是默认 ...
- 一、深入学习c++先要练好的内功
掌握进程虚拟地址空间区域的划分 课程讲的内容建立在x86 32位的Linux系统下. 任何的编程语言会产生两种东西:指令和数据.磁盘上的可执行文件在启动时都会加载到内存当中,但是不会加载到物理内存中, ...
- 使用VPLS跨地域多站点建立二层交换网络
VLL解决方案 https://www.cnblogs.com/darkchen/p/14652540.html 接上篇文档引出VPLS VLL可以跨地域建立二层交换网络,但有个缺陷是只支持两个sit ...
- Python技法:浮点数取整、格式化和NaN处理
1. 取整的三种方法 1.1 强转int类型 这种方法会直接对浮点数的小数部分进行截断(无论是正还是负). print(int(2.7)) # 2 print(int(-2.7)) # -2 1.2 ...