
Storm 第三章 Storm编程案例及Stream Grouping详解
1 功能说明
设计一个topology,来实现对文档里面的单词出现的频率进行统计。整个topology分为三个部分:
SentenceSpout:数据源,在已知的英文句子中,随机发送一条句子出去。
SplitBolt:负责将单行文本记录(句子)切分成单词
CountBolt:负责对单词的频率进行累加
2 代码实现
 package com.ntjr.bigdata;

 import org.apache.storm.Config;

 import org.apache.storm.LocalCluster;

 import org.apache.storm.StormSubmitter;

 import org.apache.storm.generated.AlreadyAliveException;

 import org.apache.storm.generated.AuthorizationException;

 import org.apache.storm.generated.InvalidTopologyException;

 import org.apache.storm.topology.TopologyBuilder;

 import org.apache.storm.tuple.Fields;

 public class WrodCountTopolog {

     public static void main(String[] args) throws AlreadyAliveException, InvalidTopologyException, AuthorizationException {

         //使用TopologyBuilder 构建一个topology

         TopologyBuilder topologyBuilder = new TopologyBuilder();

         //发送英文句子

         topologyBuilder.setSpout("sentenceSpout", new SentenceSpout(), 2);

         //将一行行的文本切分成单词

         topologyBuilder.setBolt("splitBolt", new SplitBolt(), 2).shuffleGrouping("sentenceSpout");

         //将单词的频率进行累加

         topologyBuilder.setBolt("countBolt", new CountBolt(), 2).fieldsGrouping("splitBolt", new Fields("word"));

         //启动topology的配置信息

         Config config = new Config();

         //定义集群分配多少个工作进程来执行这个topology

         config.setNumWorkers(3);

         //本地模式提交topology

         LocalCluster localCluster = new LocalCluster();

         localCluster.submitTopology("mywordCount", config, topologyBuilder.createTopology());

         //集群模式提交topology

         StormSubmitter.submitTopologyWithProgressBar("mywordCount", config, topologyBuilder.createTopology());

     }

 }
WrodCountTopolog.java
 package com.ntjr.bigdata;

 import java.util.Map;

 import org.apache.storm.spout.SpoutOutputCollector;

 import org.apache.storm.task.TopologyContext;

 import org.apache.storm.topology.OutputFieldsDeclarer;

 import org.apache.storm.topology.base.BaseRichSpout;

 import org.apache.storm.tuple.Fields;

 import org.apache.storm.tuple.Values;

 public class SentenceSpout extends BaseRichSpout {

     private static final long serialVersionUID = 1L;

     // 用来收集Spout输出的tuple

     private SpoutOutputCollector collector;

     @Override

     public void open(Map conf, TopologyContext context, SpoutOutputCollector collector) {

         this.collector = collector;

     }

     // 该方法会循环调用

     @Override

     public void nextTuple() {

         collector.emit(new Values("i am lilei love hanmeimei"));

     }

     // 消息源可以发送多条消息流,该方法定义输出的消息类型的字段

     @Override

     public void declareOutputFields(OutputFieldsDeclarer declarer) {

         declarer.declare(new Fields("love"));

     }

 }
SentenceSpout.java
 package com.ntjr.bigdata;

 import java.util.Map;

 import org.apache.storm.task.OutputCollector;

 import org.apache.storm.task.TopologyContext;

 import org.apache.storm.topology.OutputFieldsDeclarer;

 import org.apache.storm.topology.base.BaseRichBolt;

 import org.apache.storm.tuple.Fields;

 import org.apache.storm.tuple.Tuple;

 import org.apache.storm.tuple.Values;

 public class SplitBolt extends BaseRichBolt {

     private static final long serialVersionUID = 1L;

     private OutputCollector collector;

     // 该方法只会调用一次用来执行初始化

     @Override

     public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) {

         this.collector = collector;

     }

     // 接收的参数时spout发出来的句子,一个句子就是一个tuple

     @Override

     public void execute(Tuple input) {

         String line = input.getString(0);

         String[] words = line.split(" ");

         for (String word : words) {

             collector.emit(new Values(word, 1));

         }

     }

     // 定义输出类型,输出类型为单词和单词的数目和collector.emit(new Values(word, 1));对应

     @Override

     public void declareOutputFields(OutputFieldsDeclarer declarer) {

         declarer.declare(new Fields("word", "num"));

     }

 }
SplitBolt.java
 package com.ntjr.bigdata;

 import java.util.HashMap;

 import java.util.Map;

 import org.apache.storm.task.OutputCollector;

 import org.apache.storm.task.TopologyContext;

 import org.apache.storm.topology.OutputFieldsDeclarer;

 import org.apache.storm.topology.base.BaseRichBolt;

 import org.apache.storm.tuple.Tuple;

 public class CountBolt extends BaseRichBolt {

     private static final long serialVersionUID = 1L;

     private OutputCollector collector;

     // 用来保存最后的计算结果 key:单词,value:单词的个数

     Map<String, Integer> map = new HashMap<String, Integer>();

     // 该方法调用一次用来执行初始化

     @Override

     public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) {

         this.collector = collector;

     }

     @Override

     public void execute(Tuple input) {

         String word = input.getString(0);

         Integer num = input.getInteger(1);

         if (map.containsKey(word)) {

             Integer count = map.get(word);

             map.put(word, count + num);

         } else {

             map.put(word, num);

         }

         System.out.println("count:" + map);

     }

     @Override

     public void declareOutputFields(OutputFieldsDeclarer declarer) {

     }

 }
CountBolt.java
3 执行流程图
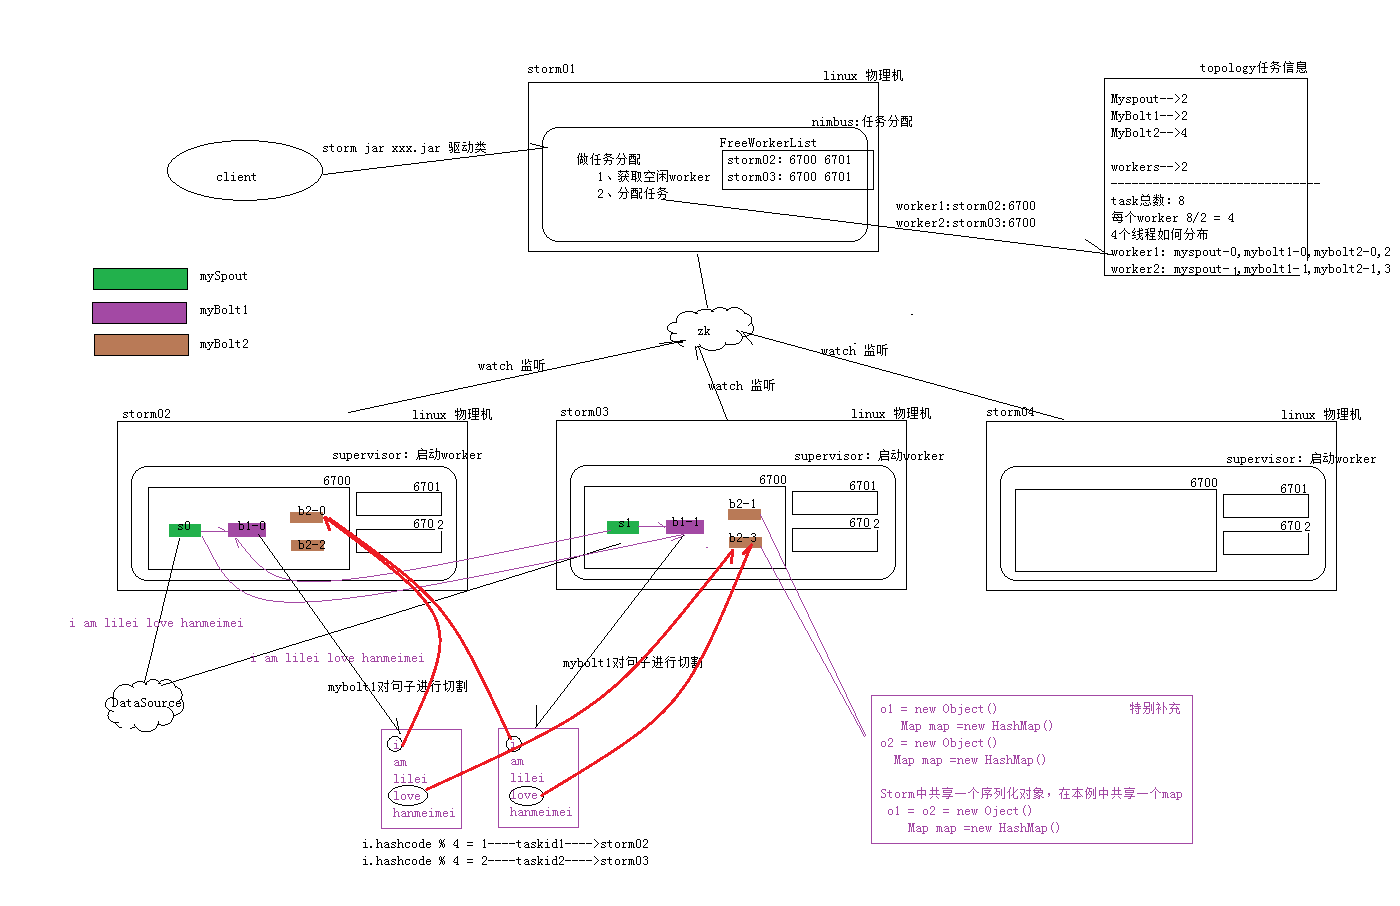
3 Stream Grouping详解
3.1 Shuffle Grouping: 随机分组, 随机派发stream里面的tuple,保证每个bolt接收到的tuple数目大致相同。
3.2 Fields Grouping:按字段分组,比如按userid来分组,具有同样userid的tuple会被分到相同的Bolts里的一个task,而不同的userid则会被分配到不同的bolts里的task。
3.3 All Grouping:广播发送,对于每一个tuple,所有的bolts都会收到。
3.4 Global Grouping:全局分组, 这个tuple被分配到storm中的一个bolt的其中一个task。再具体一点就是分配给id值最低的那个task。
3.5 Non Grouping:不分组,这stream grouping个分组的意思是说stream不关心到底谁会收到它的tuple。目前这种分组和Shuffle grouping是一样的效果, 有一点不同的是storm会把这个bolt放到这个bolt的订阅者同一个线程里面去执行。
3.6 Direct Grouping: 直接分组, 这是一种比较特别的分组方法,用这种分组意味着消息的发送者指定由消息接收者的哪个task处理这个消息。只有被声明为Direct Stream的消息流可以声明这种分组方法。而且这种消息tuple必须使用emitDirect方法来发射。
消息处理者可以通过TopologyContext来获取处理它的消息的task的id (OutputCollector.emit方法也会返回task的id)。
3.7 Local or shuffle grouping:如果目标bolt有一个或者多个task在同一个工作进程中,tuple将会被随机发生给这些tasks。否则,和普通的Shuffle Grouping行为一致。
Storm 第三章 Storm编程案例及Stream Grouping详解的更多相关文章
- Storm系列三: Storm消息可靠性保障
Storm系列三: Storm消息可靠性保障 在上一篇 Storm系列二: Storm拓扑设计 中我们已经设计了一个稍微复杂一点的拓扑. 而本篇就是在上一篇的基础上再做出一定的调整. 在这里先大概提一 ...
- Objective-C 基础教程第三章,面向对象编程基础知
目录 Objective-C 基础教程第三章,面向对象编程基础知 0x00 前言 0x01 间接(indirection) 0x02 面向对象编程中使用间接 面向过程编程 面向对象编程 0x03 OC ...
- Java程序设计(2021春)——第一章课后题(选择题+编程题)答案与详解
Java程序设计(2021春)--第一章课后题(选择题+编程题)答案与详解 目录 Java程序设计(2021春)--第一章课后题(选择题+编程题)答案与详解 第一章选择题 1.1 Java与面向对象程 ...
- Java程序设计(2021春)——第二章课后题(选择题+编程题)答案与详解
Java程序设计(2021春)--第二章课后题(选择题+编程题)答案与详解 目录 Java程序设计(2021春)--第二章课后题(选择题+编程题)答案与详解 第二章选择题 2.1 面向对象方法的特性 ...
- Java程序设计(2021春)——第四章接口与多态课后题(选择题+编程题)答案与详解
Java程序设计(2021春)--第四章接口与多态课后题(选择题+编程题)答案与详解 目录 Java程序设计(2021春)--第四章接口与多态课后题(选择题+编程题)答案与详解 第四章选择题 4.0 ...
- “全栈2019”Java多线程第三十章:尝试获取锁tryLock()方法详解
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java多 ...
- Java多线程编程中Future模式的详解
Java多线程编程中,常用的多线程设计模式包括:Future模式.Master-Worker模式.Guarded Suspeionsion模式.不变模式和生产者-消费者模式等.这篇文章主要讲述Futu ...
- Java多线程编程中Future模式的详解<转>
Java多线程编程中,常用的多线程设计模式包括:Future模式.Master-Worker模式.Guarded Suspeionsion模式.不变模式和生产者-消费者模式等.这篇文章主要讲述Futu ...
- “全栈2019”Java多线程第二十二章:饥饿线程(Starvation)详解
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java多 ...
随机推荐
- Celery学习---Celery 与django结合实现计划任务功能
项目的目录结构: 项目前提: 安装并启动Redis 安装Django和Celery的定时任务插件 安装方法一: pip直接安装[安装了pip的前提下] omc@omc-virtual-machine: ...
- JS BOM简列
JS BOM BOM 也叫浏览器对象模型,它提供了很多对象,用于访问浏览器的功能.BOM 缺少规范,每个浏览器提供商又按照自己想法去扩展它,那么浏览器共有对象就成了事实的标准.所以,BOM 本身是没有 ...
- 关于前端惰性加载(jquery_lazyload)的使用和原理分析
1.前言 有时我们会有这样的需求,当网页有很多张图片的时候,我们不希望一次性就把图片加载完,而是希望当浏览器滑动到指定位置的时候再加载,这样可以节省带宽,它也能帮助减轻服务器负载.那么这种需求就需要利 ...
- CentOS部署Kubernetes1.13集群-1(使用kubeadm安装K8S)
参考:https://www.kubernetes.org.cn/4956.html 1.准备 说明:准备工作需要在集群所有的主机上执行 1.1系统配置 在安装之前,需要先做如下准备.三台CentOS ...
- 模糊控制——(4)Sugeno模糊模型
1.Sugeno模糊模型 传统的模糊系统为Mamdani模糊模型,输出为模糊量. Sugeno模糊模型输出隶属函数为constant或linear,其函数形式为: 它与Mamdani模型的区别在于: ...
- webStorm常用设置之过滤文件夹
webStorm是一款很好用的前端IDE,但是不能否认的是webStorm很重,没有sublime轻便 尤其是项目cnpm后,加载node_modules时的状态,简直想那块豆腐自杀有莫有,就算你耐心 ...
- 通过条件注解@Conditional细粒度的选择bean实例
在进行spring进行开发时,当某个接口有多种实现方式并且我们只想让一种生效时,比如声明如下一个接口和两个实现: public interface LanggageService { String s ...
- 【gulp】Gulp的安装和配置 及 系列插件
注意:要安装俩次gulp(全局和本地):全局安装gulp是为了执行gulp任务,本地安装gulp则是为了调用gulp插件的功能. 之前由大牛帮忙配置的gulp来用.今天时间充裕,就和小伙伴一起动手配置 ...
- 清除浮动元素的margin-top失效原因(更改之前的错误)
//样式代码body,div{ margin:; padding:; } .box1{ background:#900; width:200px; height:200px; margin:20px ...
- block本质探寻七之内存管理
说明: <1>阅读本问,请参照block前述文章加以理解: <2>环境:ARC: <3>变量类型:基本数据类型或者对象类型的auto局部变量: 一.三种情形 //代 ...