
darknet-yolov3模型预测框size不正确的原因
问题描述:预测框的中心位置正常,但是预测的框的width和height不正常。
解决方法:使得训练的配置cfg和测试中cfg的输入width, height, anchorbox保持一致!
问题是我在修改anchorbox时遇到的,当时训练和测试不在同一环境下,测试端没有及时更新cfg文件造成的,如下图所示:
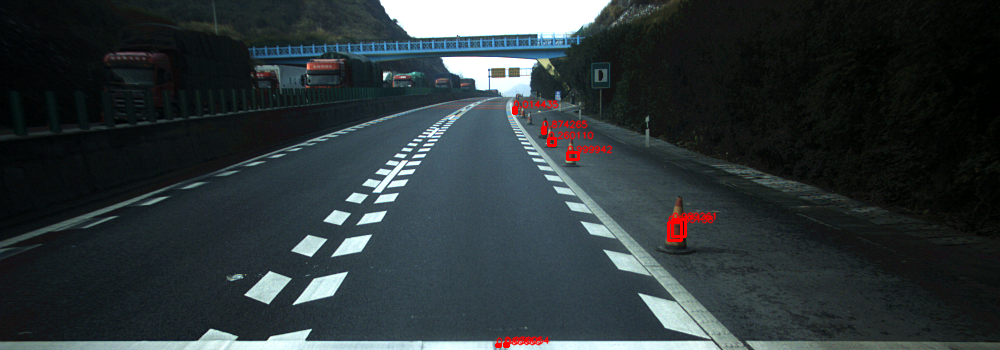
mAP也是极低的。
修改后,检测框正常,如下图所示:

下面做下boundingbox来源分析:
首先是yolo(you only look once)中是这样定义的:

算法中明确告诉我们:boundingbox只和cell(featuremap中的)位置(Cx,Cy)以及anchorbox的(Pw,Ph)直接相关。所以我们可以重点关注这两个量。
对应到源代码中的实现主要是以下两个函数:
yolo_layer.c

...
box get_yolo_box(float *x, float *biases, int n, int index, int i, int j, int lw, int lh, int w, int h, int stride)

/*

输入参数解析:(*x 预测数据),(*biases 存放anchor数据),

(i、j 对应在feature map上的坐标),

(n 表示anchor数组的mask,为了让三个yolo_layer能取到自己对应的三组anchor, 小尺寸feature map对应大size anchor,比较好理解小尺寸特征图负责检查大尺寸目标),

(index,当前bbox对应的数据的起始下标),

(lw lh,特征图的w h),

(w h, 网络输入的w h),

(同一个bbox数据之间的stride lw*lh)

*/

{

    box b; // 网络为了每一个bbox都给出了4个坐标预测值: tx ty tw ty

    /*

    其中tx 和 ty是相对于当前feature map坐标的偏移

    除以lw&&lh 是计算出bbox坐标在图像中的比例

    */

    b.x = (i + x[index + 0*stride]) / lw;

    b.y = (j + x[index + 1*stride]) / lh;

    /*

    e^tw * biases[2*n] 表示学习到的w回归值和对应prior bbox(anchor) w的乘积得到

    bbox在网络输入size基础上的w size, 除以 net_w得到相对于网络输入图像的比例

    h的计算同理, 这部分的内容涉及到yolov3论文中的图二

    */

    b.w = exp(x[index + 2*stride]) * biases[2*n]   / w;

    b.h = exp(x[index + 3*stride]) * biases[2*n+1] / h;

    return b;

    /*补充一下,这里算出的x,y,w,h都是相对于net input size的比例*/

}
此不分为转载:
https://blog.csdn.net/wwwhp/article/details/84718089
...

int get_yolo_detections(layer l, int w, int h, int netw, int neth, float thresh, int *map, int relative, detection *dets)

{

    int i,j,n;

    float *predictions = l.output;

    if (l.batch == 2) avg_flipped_yolo(l);

    int count = 0;

    for (i = 0; i < l.w*l.h; ++i){

        int row = i / l.w;

        int col = i % l.w;

    //printf("get_yolo_detections:i =%d,row = i / l.w=%d, col = i % l.w;\n",i, row, col);

        for(n = 0; n < l.n; ++n){

            int obj_index  = entry_index(l, 0, n*l.w*l.h + i, 4);

            float objectness = predictions[obj_index];//objectness:有框的

        //printf("objectness:%f\n",objectness);

            if(objectness <= thresh) continue;

        printf("obj_index = %d,objectness:%f, thresh:%f\n",obj_index,objectness,thresh);

            int box_index  = entry_index(l, 0, n*l.w*l.h + i, 0);

            dets[count].bbox = get_yolo_box(predictions, l.biases, l.mask[n], box_index, col, row, l.w, l.h, netw, neth, l.w*l.h);//模型推理出偏移量

            dets[count].objectness = objectness;

            dets[count].classes = l.classes;

            for(j = 0; j < l.classes; ++j){

                int class_index = entry_index(l, 0, n*l.w*l.h + i, 4 + 1 + j);

                float prob = objectness*predictions[class_index];//predictions[class_index]:框中物体是class的概率,prob:置信度

        printf("get_yolo_detections1:prob=objectness*predictions[class_index] = %f * predictions[%d] = %f * %f = %f;\n",objectness,class_index,objectness,predictions[class_index],prob);

                dets[count].prob[j] = (prob > thresh) ? prob : 0;

        printf("get_yolo_detections2:[dets[count].prob[j] = (prob > thresh) ? prob : 0] = [ %f = (%f > %f) ? %f : 0];\n",dets[count].prob[j],prob,thresh,prob);

            }

            ++count;

        }

    }

    correct_yolo_boxes(dets, count, w, h, netw, neth, relative);

    return count;

}

...
如有疑问可以留言。
希望可以帮到困惑的你!
darknet-yolov3模型预测框size不正确的原因的更多相关文章
- AlexeyAB DarkNet YOLOv3框架解析与应用实践(二)
AlexeyAB DarkNet YOLOv3框架解析与应用实践(二) 版本3有什么新功能? YOLOv3使用了一些技巧来改进训练和提高性能,包括:多尺度预测.更好的主干分类器等等.全部细节都在我们的 ...
- AlexeyAB DarkNet YOLOv3框架解析与应用实践(一)
AlexeyAB DarkNet YOLOv3框架解析与应用实践(一) Darknet: C语言中的开源神经网络 Darknet是一个用C和CUDA编写的开源神经网络框架.它速度快,易于安装,支持C ...
- 时间序列深度学习:seq2seq 模型预测太阳黑子
目录 时间序列深度学习:seq2seq 模型预测太阳黑子 学习路线 商业中的时间序列深度学习 商业中应用时间序列深度学习 深度学习时间序列预测:使用 keras 预测太阳黑子 递归神经网络 设置.预处 ...
- AlexeyAB DarkNet YOLOv3框架解析与应用实践(六)
AlexeyAB DarkNet YOLOv3框架解析与应用实践(六) 1. Tiny Darknet 听过很多人谈论SqueezeNet. SqueezeNet很酷,但它只是优化参数计数.当大多数高 ...
- AlexeyAB DarkNet YOLOv3框架解析与应用实践(三)
AlexeyAB DarkNet YOLOv3框架解析与应用实践(三) ImageNet分类 您可以使用Darknet为1000级ImageNet挑战赛分类图像.如果你还没有安装Darknet,你应该 ...
- 时间序列深度学习:状态 LSTM 模型预测太阳黑子
目录 时间序列深度学习:状态 LSTM 模型预测太阳黑子 教程概览 商业应用 长短期记忆(LSTM)模型 太阳黑子数据集 构建 LSTM 模型预测太阳黑子 1 若干相关包 2 数据 3 探索性数据分析 ...
- tensorflow学习笔记——模型持久化的原理,将CKPT转为pb文件,使用pb模型预测
由题目就可以看出,本节内容分为三部分,第一部分就是如何将训练好的模型持久化,并学习模型持久化的原理,第二部分就是如何将CKPT转化为pb文件,第三部分就是如何使用pb模型进行预测. 一,模型持久化 为 ...
- AlexeyAB DarkNet YOLOv3框架解析与应用实践(五)
AlexeyAB DarkNet YOLOv3框架解析与应用实践(五) RNNs in Darknet 递归神经网络是表示随时间变化的数据的强大模型.为了更好地介绍RNNs,我强烈推荐Andrej K ...
- NLP(十八)利用ALBERT提升模型预测速度的一次尝试
前沿 在文章NLP(十七)利用tensorflow-serving部署kashgari模型中,笔者介绍了如何利用tensorflow-serving部署来部署深度模型模型,在那篇文章中,笔者利用k ...
随机推荐
- 测开之路一百二十八:flask之重定向和404
a.b两个视图,分别返回a的页面和b的页面 重定向:redirect 重定向到路由:请求/a/时,重定向到/b/ 重定向到视图函数:url_for(“函数名“),访问/a/时,重定向到函数b() 主动 ...
- 关于OPC连接读写下位机PLC(转)
原文转自:http://blog.csdn.net/u012252959/article/details/49736285?locationNum=11 开发OPC客户端程序时,首先应该生成OPC服务 ...
- 【ABAP系列】SAP ABAP 开发中的SMARTFORMS 参数
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[ABAP系列]SAP ABAP 开发中的SMA ...
- 应用安全 - 无文件式攻击 - 潜伏型攻击 - MBR - 汇总 (2019-11-29 15:57)
Petya勒索病毒 Date
- 使用powershell管理Docker Toolbox
打开PowerShell,输入: docker-machine ls 我们可以看到我们当前的Docker虚拟机的状态.如果什么都没有的话,那么我们可以使用以下命令创建一个Docker虚拟机. dock ...
- 简述Vue的路由与视图
1.vue-router 安装方式 npm/cnpm:(个人偏向于cnpm) npm/cnpm install vue-router --save-dev bower: bower install v ...
- 七、Zabbix-模板,应用集,监控项,触发器
本篇内容,将模板,应用集,监控项,触发器放在一起,因为我们建立使用的监控项和触发器,大多数都是对多台机器使用的,很少有一个监控项对应一个主机的情况. 一.模板 1.什么是模板? 个人理解,模板就是模板 ...
- CentOS7编译安装sshpass过程
环境说明:centos 7 cat /etc/redhat-release CentOS Linux release 7.6.1810 (Core) 我的sshpass版本 sshpass-1.06. ...
- JS跨域--window.name
JS跨域--window.name:https://www.jianshu.com/p/43ff69d076e3
- html5动画之等待加载动画
<div class="loading"> <p>100<span></span></p> </div> ; ...