
使用libcurl,根据url下载对应html页面
1. [图片] Capture.JPG
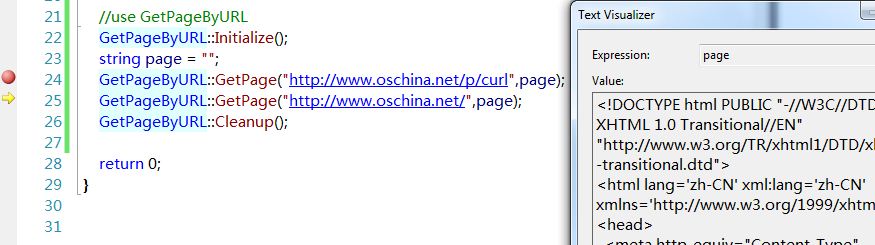
2. [代码]GetPageByURL
//static member variable define
string GetPageByURL::m_curPage = "";//当前保存的网页源码
CURL* GetPageByURL::m_curl = NULL;
/************************************************************************/
/* 函数名:Initialize
/* 功 能: 初始化libcurl库
/* 返回值:成功,返回true;失败,返回false
/************************************************************************/
bool GetPageByURL::Initialize()
{
curl_global_init(CURL_GLOBAL_ALL);
m_curl = curl_easy_init();
if (m_curl)
{
curl_easy_setopt(m_curl, CURLOPT_FOLLOWLOCATION, 1L);
curl_easy_setopt(m_curl, CURLOPT_WRITEFUNCTION, WriteFunc);
curl_easy_setopt(m_curl, CURLOPT_WRITEDATA, &m_curPage);
}
else
{
MessageBoxA(NULL,"GetPageByURL::Initialize Failed!", "GetPageByURL::Initialize", MB_ICONERROR);
return false;
}
return true;
}
/************************************************************************/
/* 函数名:WriteFunc
/* 功 能: libcurl会调用这个标准的函数,
/* size_t function( void *ptr, size_t size, size_t nmemb, void *userdata);
/* 以提供格式化网页数据的机会
/* curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteFunc);
/* 返回值:返回buffer的大小
/************************************************************************/
size_t GetPageByURL::WriteFunc(char *data, size_t size, size_t nmemb, string *writerData)
{
if (writerData == NULL)
return 0;
size_t len = size*nmemb;
writerData->append(data, len);
return len;
}
/************************************************************************/
/* 函数名:GetPage
/* 功 能: 根据url,抓取对应的网页源码;使用了libcurl库
/* 返回值:成功,返回包含网页源码的字符串;失败,返回空字符串
/************************************************************************/
bool GetPageByURL::GetPage(
const string& urlStr, //url字符串
string& page //输出参数,返回对应页面源码
)
{
_ASSERT("" != urlStr);
if(!m_curl)
{
MessageBoxA(NULL,"You must initialize curl first!", "GetPageByURL", MB_ICONERROR);
return false;
}
m_curPage.clear();
curl_easy_setopt(m_curl, CURLOPT_URL, urlStr.c_str());
CURLcode res = curl_easy_perform(m_curl);
if(res != CURLE_OK)
{
Utility::MessageBox(NULL, "GetPageByURL::GetPage", MB_ICONERROR, "Get the page of %s failed!", urlStr.c_str());
return false;
}
else
{
page = m_curPage;
return true;
}
}
/************************************************************************/
/* 函数名:Cleanup
/* 功 能: 清理内存
/* 返回值:无
/************************************************************************/
void GetPageByURL::Cleanup()
{
if(m_curl)
{
/* always cleanup */
curl_easy_cleanup(m_curl);
m_curl = NULL;
}
}
3. [代码]use it
//use GetPageByURL
GetPageByURL::Initialize();
string page = "";
GetPageByURL::GetPage("http://www.oschina.net/p/curl",page);
GetPageByURL::GetPage("http://www.oschina.net/",page);
GetPageByURL::Cleanup();
4. [文件] GetPageByURL.h
#pragma once
#include <curl/curl.h>
class GetPageByURL
{
public:
GetPageByURL(void);
public:
~GetPageByURL(void);
private:
static string m_curPage;
static CURL *m_curl;
private:
static size_t WriteFunc(char *data, size_t size, size_t nmemb, string *writerData);
public:
static bool Initialize();
static bool GetPage(const string& urlStr, string& page);
static void Cleanup();
};
5. [文件] GetPageByURL.cpp
#include "StdAfx.h"
#include "GetPageByURL.h"
//static member variable define
string GetPageByURL::m_curPage = "";//当前保存的网页源码
CURL* GetPageByURL::m_curl = NULL;
GetPageByURL::GetPageByURL(void)
{http://www.enterdesk.com/special/shouhui/
}手绘图片
GetPageByURL::~GetPageByURL(void)
{
}
/************************************************************************/
/* 函数名:Initialize
/* 功 能: 初始化libcurl库
/* 返回值:成功,返回true;失败,返回false
/************************************************************************/
bool GetPageByURL::Initialize()
{
curl_global_init(CURL_GLOBAL_ALL);
m_curl = curl_easy_init();
if (m_curl)
{
curl_easy_setopt(m_curl, CURLOPT_FOLLOWLOCATION, 1L);
curl_easy_setopt(m_curl, CURLOPT_WRITEFUNCTION, WriteFunc);
curl_easy_setopt(m_curl, CURLOPT_WRITEDATA, &m_curPage);
}
else
{
MessageBoxA(NULL,"GetPageByURL::Initialize Failed!", "GetPageByURL::Initialize", MB_ICONERROR);
return false;
}
return true;
}
/************************************************************************/
/* 函数名:WriteFunc
/* 功 能: libcurl会调用这个标准的函数,
/* size_t function( void *ptr, size_t size, size_t nmemb, void *userdata);
/* 以提供格式化网页数据的机会
/* curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteFunc);
/* 返回值:返回buffer的大小
/************************************************************************/
size_t GetPageByURL::WriteFunc(char *data, size_t size, size_t nmemb, string *writerData)
{
if (writerData == NULL)
return 0;
size_t len = size*nmemb;
writerData->append(data, len);
return len;
}
/************************************************************************/
/* 函数名:GetPage
/* 功 能: 根据url,抓取对应的网页源码;使用了libcurl库
/* 返回值:成功,返回包含网页源码的字符串;失败,返回空字符串
/************************************************************************/
bool GetPageByURL::GetPage(
const string& urlStr, //url字符串
string& page //输出参数,返回对应页面源码
)
{
_ASSERT("" != urlStr);
if(!m_curl)
{
MessageBoxA(NULL,"You must initialize curl first!", "GetPageByURL", MB_ICONERROR);
return false;
}
m_curPage.clear();
curl_easy_setopt(m_curl, CURLOPT_URL, urlStr.c_str());
CURLcode res = curl_easy_perform(m_curl);
if(res != CURLE_OK)
{
Utility::MessageBox(NULL, "GetPageByURL::GetPage", MB_ICONERROR, "Get the page of %s failed!", urlStr.c_str());
return false;
}
else
{
page = m_curPage;
return true;
}
}
/************************************************************************/
/* 函数名:Cleanup
/* 功 能: 清理内存
/* 返回值:无
/************************************************************************/
void GetPageByURL::Cleanup()
{
if(m_curl)
{
/* always cleanup */
curl_easy_cleanup(m_curl);
m_curl = NULL;
}
}
使用libcurl,根据url下载对应html页面的更多相关文章
- 根据url下载图片和页面
需要将&tp=webp&wxfrom=5去掉,既可以在任何地方显示,也可以下载了 http://mmbiz.qpic.cn/mmbiz_jpg/bf8pC39RBhGFOH1ib9Ac ...
- js通过 URL下载文件
页面上一个button,点击之后触发一个function去请求数据,返回 pdf/epub 的URL,然后下载这个文件. 本来是直接用 a 写的,href里放资源地址,target设为'_blank' ...
- wget---从指定的URL下载文件
wget命令用来从指定的URL下载文件.wget非常稳定,它在带宽很窄的情况下和不稳定网络中有很强的适应性,如果是由于网络的原因下载失败,wget会不断的尝试,直到整个文件下载完毕.如果是服务器打断下 ...
- node.js入门学习(二)MIME模块,request和response对象,demo之不同url请求不同html页面,页面包含图片、样式css等静态资源
一.构建http服务程序-根据不同请求做出不同响应 // 加载http模块 var http = require("http"); // 创建一个http服务对象 http.cre ...
- C++根据图片url下载图片
需要使用到URLDownloadToFile()函数,该函数在头文件<urlmon.h>中声明. URLDownloadToFile()函数的定义如下: HRESULT URLDownlo ...
- 从指定的URL下载文件
通过使用URLDownLoadToFile函数,我们能从指定的URL下载文件,保存到本地,并且下载的文件类型可以是可执行文件 实例如下,http://www.xuexic.com 的根目录下存在一个l ...
- Java和Android Http连接程序:使用java.net.URL 下载服务器图片到客户端
Java和Android Http连接程序:使用java.net.URL 下载服务器图片到客户端 本博客前面博文中利用org.apache.http包中API进行Android客户端HTTP连接的例子 ...
- 使用url下载网络图片以及流介绍
使用url下载网络图片的时候,首先需要建立一个URL对象,然后使用一个输入流获取该URL中的内容.之后使用读取该输入流的内容,使用一个输出流写到本地文件中.最后关闭输入和输出流.下面是一个简单的下载代 ...
- QT实现,通过URL下载文件的接口实现
今天来把坑填上. 具体就是提供一个URL,并通过这个URL下载文件. MyDownloader.h: #ifndef MYDOWNLOADER_H #define MYDOWNLOADER_H cla ...
随机推荐
- awstats的安装和配置
一.Awstats简介Awstats是一个免费非常简洁而且强大有个性的网站日志分析工具.它可以统计您站点的如下信息:一:访问量,访问次数,页面浏览量,点击数,数据流量等二:精确到每月.每日.每小时的数 ...
- Java集合框架GS Collections具体解释
Java集合框架GS Collections具体解释 作者:chszs.未经博主同意不得转载.经许可的转载需注明作者和博客主页:http://blog.csdn.net/chszs GS Collec ...
- cocos2d-x 3.0 内存管理机制
***************************************转载请注明出处:http://blog.csdn.net/lttree************************** ...
- Windows Thin PC体验 & 语言包更改(win 7 included)
本作品由Man_华创作,采用知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议进行许可.基于http://www.cnblogs.com/manhua/上的作品创作. 简介: Window ...
- python中给程序加锁之fcntl模块的使用
python 中给文件加锁——fcntl模块import fcntl 打开一个文件##当前目录下test文件要先存在,如果不存在会报错.或者以写的方式打开f = open('./test')对该文件加 ...
- [Java] 实验4參考代码
题目.提示.代码.解释都已公布. 提供这些的目的不是要求大家要写得像我写得这样,而是希望大家在实验后看看别人写的代码: 1. 提升理解代码的能力. 2. 不要自满于完毕题目.要明确你的 ...
- HandlerMethodArgumentResolver 参数解析器
关于springMvc中的参数解析器 springMvc中的HandlerAdapter会检测所有的 HandlerMethodArgumentResolver(对参数的解析器) HandlerMet ...
- java利用爬虫技术抓取(省、市(区号\邮编)、县)数据
近期项目须要用到 城市的地址信息,但从网上下载的xml数据没有几个是最新的地址信息.....数据太老,导致有些地区不全.所以才想到天气预报官网特定有最新最全的数据.贴出代码,希望能给有相同困惑的朋友. ...
- uboot之run_command简单分析
本文档简单分析了uboot中命令的实现.run_command函数的实现以及从uboot命令行接收并处理命令的过程. 作者: 彭东林 邮箱: pengdonglin137@163.com http:/ ...
- 常用string函数分析
string函数分析string函数包含在string.c文件中,经常被C文件使用.1. strcpy函数原型: char* strcpy(char* str1,char* str2);函数功能: 把 ...