
Java集合框架(二)—— HashSet、LinkedHashSet、TreeSet和EnumSet
Set接口
前面已经简绍过Set集合,它类似于一个罐子,一旦把对象'丢进'Set集合,集合里多个对象之间没有明显的顺序。Set集合与Collection基本上完全一样,它没有提供任何额外的方法。
Set集合不容许包含相同的元素,如果试图把两个相同元素加入到同一个Set集合中,则添加操作失败,add方法返回false,且新元素不会被加入。
Set判断两个对象是否相同不是使用==运算符,而是根据equals方法。也就是说,只要两个对象用equals方法比较返回true,Set就不会接受这两个对象,反之,只要两个对象用equals方法比较返回false,Set就会接受这两个对象(甚至这两个对象是同一个对象,Set也可把他们当成俩个对象处理),下面是Set的使用案例。
public class Test {

    public static void main(String[] args){

        Set set = new HashSet();

        boolean a = set.add(new String("语文"));

        boolean b = set.add(new String("语文"));

        //打印结果为true

        System.out.println(a);

        //打印结果为false

        System.out.println(b);

        /*

         * 打印结果为[语文];

         * 因为两个字符串通过equals方法比较返回为true(String类默认重写了Object中equals方法),所以第二次添加失败

         */

        System.out.println(set);

    }

}
从上面程序中可以看出,books集合两次添加的字符串对象明显不是同一个对象(因为两次都调用了new关键字来创造字符串对象),这两个字符串对象使用==运算符判断肯定返回false,但它们通过equals方法比较将返回true,所以添加失败。最后输出set集合时,将看到输出结果只有一个元素。
上面介绍的是Set集合的通用知识,完全适合HashSet、TreeSet和EnumSet三个实现类。
HashSet类
HashSet具有以下特点:
- HashSet具有很好的对象检索性能,当从HashSet中查找某个对象时,Java系统首先调用对象的hashCode方法获得该对象的哈希码,然后根据哈希码找到对应的存储区域,最后取出该存储区域的每个元素与该对象进行equals方法的比较,这样不用遍历集合中的所有元素就可以得到结论。
- HashSet存储对象的效率相对要低些,因为向HashSet集合中添加对象的时候,首先要计算出来对象的哈希码和根据这个哈希码来确定对象在集合中的存放位置。
- 不能保证排列的顺序,顺序有可能发生改变。
- HashSet不是同步的(非同步,非线程安全),如果多个线程同时访问一个HashSet集合,如果有2条或者2条以上线程同时修改了HashSet集合时,必须通过代码来保证其同步。
- HashSet集合元素可以是null。
HashSet还有一个子类LinkedHashSet,LinkedHashSet集合也是根据元素hashCode值来决定元素存储位置,但它同时使用链表维护元素的次序,这样使的元素看起来是以插入的顺序保存的。也就是说当遍历LinkedHashSet集合里的元素时,HashSet将会按元素的添加顺序来访问集合里的元素。
LinkedHashSet需要维护元素的插入顺序,因此性能略低于HashSet的性能,但是在迭代访问Set里的全部元素时,将有很好的性能,因为它以列表来维护内部顺序。
public class Test {

    public static void main(String[] args){

        LinkedHashSet books = new LinkedHashSet();

            books.add("语文");

            books.add("数学");

            books.add("英语");

            //删除语文

            books.remove("语文");

            //重新添加

            books.add("语文");

            //打印结果为[数学, 英语, 语文]

            System.out.println(books);

    }

}
上面的集合里,元素的顺序正好与添加顺序一致。
TreeSet类
TreeSet是SortedSet接口的唯一实现(SortedSet接口继承Set接口),正如SortedSet名字所暗示的,TreeSet可以确保集合元素处于排序状态。与前面的HashSet集合相比,TreeSet还提供了如下几个额外方法:
- Comparator comparator(); //返回当前Set使用的Comparator,或者返回null,表示以自然方式排序。
- Object first(); //第一个;返回集合中的第一个元素。
- Object last(); //最后一个;返回集合中的最后一个元素。
- Object lower(Object o); //前一个;返回集合中位于指定元素之前的元素(即小于指定元素的最大元素,参考元素不需要是TreeSet的元素)。
- Object higher(Object o); //后一个;返回集合中位于指定元素之后的元素(即大于指定元素的最小元素,参考元素不需要是TreeSet的元素)。
- SortedSet subSet(fromElement, toElement); //返回此Set的子集合,范围从fromElement(包含)到toElement(不包含)。
- SortedSet headSet(toElement); //返回此set的子集,由小于toElement的元素组成。
- SortedSet tailSet(fromElement); //返回此set的子集,由大于或等于fromElement的元素组成。
public class Test {

    public static void main(String[] args){

        TreeSet<Integer> nums = new TreeSet<Integer>();

            nums.add(3);

            nums.add(1);

            nums.add(5);

            nums.add(-9);

            //1.返回第一个元素

            Integer first = nums.first();

            //打印结果为-9

            System.out.println(first);

            //2.返回最后一个元素

            Integer last = nums.last();

            //打印结果为5

            System.out.println(last);

            //3.返回上一个

            Integer lower = nums.lower(2);

            //打印结果为1

            System.out.println(lower);

            //4.返回下一个

            Integer higher = nums.higher(2);

            //打印结果为3

            System.out.println(higher);

            //5.返回小于3的子集,不包含3

            SortedSet<Integer> headSet = nums.headSet(3);

            //打印结果[-9, 1]

            System.out.println(headSet);

            //6.返回大于等于3的子集,包含3

            SortedSet<Integer> tailSet = nums.tailSet(3);

            //打印结果[3, 5]

            System.out.println(tailSet);

            //7.打印整个集合结果为[-9, 1, 3, 5]

            System.out.println(nums);

    }

}
根据上面程序的运行结果可看出,TreeSet并不是根据元素的插入顺序进行排序,而是根据元素实际值来进行排序的。
与HashSet集合采用的hash算法来决定元素的存储位置不同,TreeSet采用红黑树的数据结构对元素进行排序。那么TreeSet进行排序是怎么样的呢?TreeSet支持两种排序方法:自然排序和定制排序。默认情况下,TreeSet采用自然排序。
自然排序
Java提供了一个Comparable接口,该接口里定义了一个compareTo(Object obj)方法,该方法返回一个整数值,实现该接口的类必须实现该方法,实现了该接口的类的对象就可以比较大小了。当一个对象调用该方法与另一个对象进行比较,例如obj1.compareTo(obj2); 如果该方法返回0,则表明这两个对象相等;如果该方法返回一个正整数,则表明obj1大于obj2;如果该方法返回一个负整数,则表明obj1小于obj2。
Java的一些常用类已经实现了Comparable接口,并提供了比较大小的标准, 下面是实现了Comparable接口的常用类:
- BigDecimal、BigInteger以及所有数值型对应包装类:按它们对象的数值大小进行比较。
- Character :按字符的Unicode值进行比较。
- Boolean : true对应的包装类实例大于false对应的包装类实例。
- String : 按字符串中字符的Unicode值进行比较。
- Date、Time : 后面的时间、日期比前面的日期时间大。
如图所示:Integer类实现了Comparable接口:
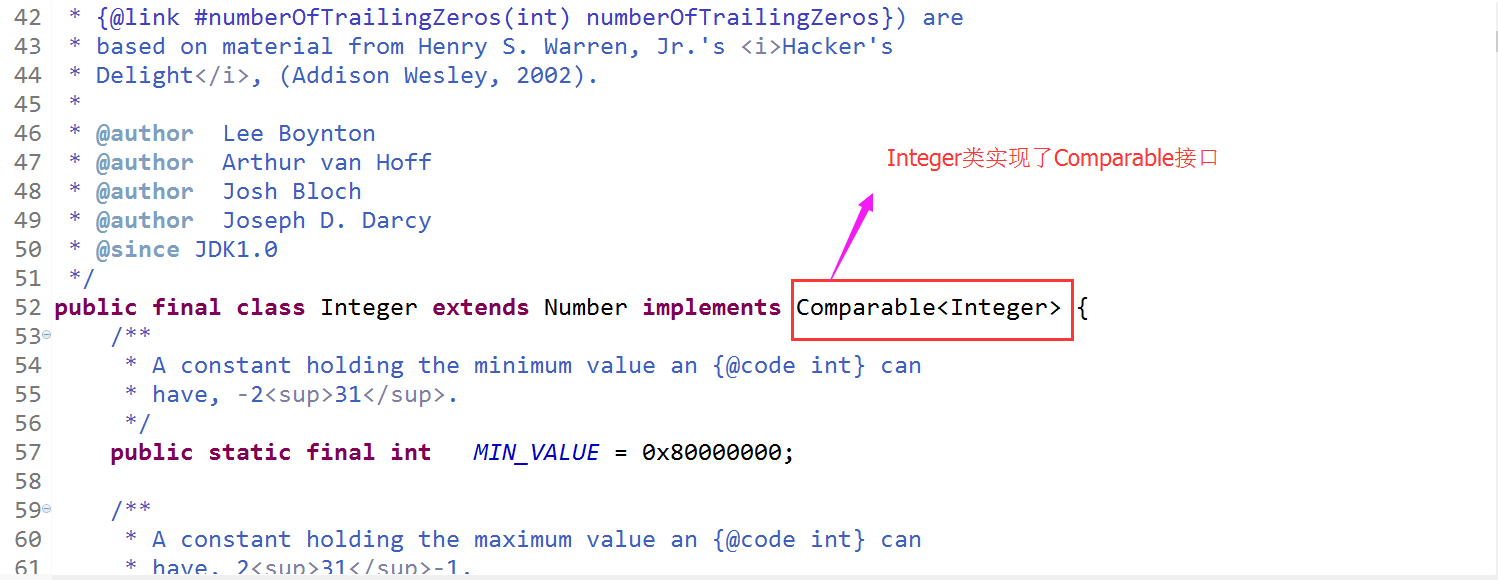
由于上边的Integer类实现了Comparable接口,故TreeSet会调用集合元素的compareTo(Object o)方法来比较元素之间的大小关系,然后将集合元素按升序排列(数据从低到高排列),这种方式就是自然排序。如果试图把一个对象添加进TreeSet时,则该对象的类必须实现Comparable接口,否则程序将会抛出ClassCastException异常。代码如下:
class Person{

}

public class Test {

    public static void main(String[] args){

        TreeSet<Person> persons = new TreeSet<Person>();

        persons.add(new Person());

        System.out.println(persons);

    }

}
以上代码将会抛出:
定制排序
TreeSet的自然排序是根据集合元素的大小,TreeSet将它们以升序排列。如果需要完成定制排序,例如以降序排列,则可以使用Comparator接口的帮助。该接口里包含了一个int compare(T o1, T o2)方法,该方法用于比较o1、o2的大小:如果该方法返回正整数,则表明o1大于o2;如果该方法返回0,则表明o1等于o2;如果该方法返回负整数,则表明o1小于o2。
如下所示:如果需要实现定制排序(我们这实现倒序),则需要在创建TreeSet集合对象时,并提供一个Comparator对象与该TreeSet集合关联,由该Comparator对象负责集合元素的排序逻辑。
class Person{

    Integer age;

    public Person(int age){

        this.age = age;

    }

    @Override

    public String toString() {

        return "Person [age=" + age + "]";

    }

}

public class Test {

    public static void main(String[] args){

        TreeSet<Person> persons = new TreeSet<Person>(new Comparator<Person>(){

            @Override

            public int compare(Person o1, Person o2) {

                if(o1.age > o2.age){

                    return -1;

                }else if(o1.age == o2.age){

                    return 0;

                }else{

                    return 1;

                }

            }

        });

        persons.add(new Person(2));

        persons.add(new Person(5));

        persons.add(new Person(6));

        //打印结果为[Person [age=6], Person [age=5], Person [age=2]]倒序

        System.out.println(persons);

    }

}
上面程序创建了一个Compartor接口的匿名内部类对象,该对象负责persons集合的排序。所以当我们把Person对象添加到persons集合中时,无须Person类实现Comparable接口,因为此时TreeSet无须通过Person对象来比较大小,而是由与TreeSet关联的Compartor对象来负责集合元素的排序。
EnumSet类
EnumSet是一个专为枚举设计的集合类,EnumSet中所有值都必须是指定枚举类型的枚举值,该枚举类型在创建EnumSet时显式或隐性的指定。EnumSet的集合元素也是有序的,EnumSet以枚举值在Enum类内的定义顺序来决定集合元素的排序。
EnumSet在内部以位向量的形式存储,这种存储形式非常紧凑、高效,因此EnumSet对象占用内存很小,而且运行效率很好。尤其是当进行批量操作(如调用containsAll和retainAll方法)时,如其参数也是EnumSet集合,则该批量操作的执行速度也非常快。
EnumSet集合不容许加入null元素。如果试图插入null元素,EnumSet将会抛出NullPointerException异常。
EnumSet类没有暴露任何构造器来创建该类的实例,程序应该通过它提供的static方法来创建EnumSet对象。它提供了如下常用static方法来创建EnumSet对象:
- static EnumSet allOf(Class elementType); 创建一个包含指定枚举类里所有枚举值的EnumSet集合。
- static EnumSet complementOf(EnumSet s); 创建一个其元素类型与指定EnumSet里元素类型相同的EnumSet,新EnumSet集合包含原EnumSet所不包含的、此枚举类剩下的枚举值(有点绕,看下面的例子,一看就懂)。
- static EnumSet copyOf(Collection c); 使用一个普通集合来创建EnumSet集合。
- static EnumSet copyOf(EnumSet s); 创建一个与指定EnumSet具有相同元素集合类型、相同集合元素的EnumSet。
- static EnumSet noneOf(Class elementType); 创建一个集合类型为指定枚举类型的空EnumSet。
- static EnumSet of(E first, E...rest); 创建一个包含一个或多个枚举值的EnumSet,传入的多个枚举值必须属于同一个枚举类。
- static EnumSet range(E first, E to); 创建包含从from枚举值,到to枚举值范围内所有枚举值的EnumSet集合。
enum Season{

    SPRING,SUMMER,AUTUMN,WINTER

}

public class Test {

    public static void main(String[] args){

        //1.0创建一个EnumSet集合,集合元素就是Season枚举类的全部枚举值

        EnumSet<Season> es = EnumSet.allOf(Season.class);

        System.out.println(es);//输出[SPRING, SUMMER, AUTUMN, WINTER]

        //2.0创建一个EnumSet空集合,指定其集合元素时Season类的枚举值。

        EnumSet<Season> es2 = EnumSet.noneOf(Season.class);

        System.out.println(es2);//输出[]

        //2.1手动添加两个元素

        es2.add(Season.AUTUMN);

        es2.add(Season.WINTER);

        System.out.println(es2);//输出[AUTUMN, WINTER]

        //3.0以指定枚举值创建EnumSet集合

        EnumSet<Season> es3 = EnumSet.of(Season.SPRING, Season.SUMMER);

        System.out.println(es3);//输出[SPRING, SUMMER]

        //4.0创建包含从Season.SPRING枚举值,到Season.AUTUMN枚举值范围内所有枚举值的EnumSet集合。

        EnumSet<Season> es4 = EnumSet.range(Season.SPRING, Season.AUTUMN);

        System.out.println(es4); //输出[SPRING, SUMMER, AUTUMN]

        //5.0新创建的EnumSet集合元素和es4集合的元素有相同类型,es5的集合元素 + es4的集合元素 = Season 的所有枚举值

        EnumSet<Season> es5 = EnumSet.complementOf(es4);

        System.out.println(es5); //输出[WINNER]

        //6.0复制Collection集合中所有元素来创建EnumSet集合。

        Collection<Season> c = new HashSet<Season>();

            c.add(Season.AUTUMN);

            c.add(Season.WINTER);

        EnumSet<Season> es6 = EnumSet.copyOf(c);

        System.out.println(es6); //输出[AUTUMN, WINTER]

    }

}
总结
- HashSet和TreeSet是Set的两个典型实现,HashSet的性能总是比TreeSet好(特别是比较常用的添加、查询元素等操作),因为TreeSet需要额外的红黑树算法来维护集合元素的次序。只有当需要一个保持排序的Set时,才应该使用TreeSet,否则都应该使用HashSet。
- HashSet还有一个子类:LinkedHashSet,对于普通插入、删除操作,LinkedHashSet比HashSet要略微慢一点;这是由维护链表所带来的额外开销所造成的,不过,因为有了链表,遍历LinkedHashSet会更快。
- EnumSet是所有Set实现类中性能最好的,但它只能保存同一个枚举类的枚举值做为集合元素。
- Set的三个实现类HashSet(包括LinkedHashSet)、TreeSet和EnumSet都是线程不安全的。如果有多个线程同时访问一个Set集合,并且有超过一条线程修改了该Set集合,则必须手动保证该Set集合的同步性。通常可以通过Collections工具类的synchronizedSet方法来"包装"该Set集合。此操作最好在创建时进行,以防止对Set集合的意外非同步访问。例如:Set hs = Collections.synchronizedSet(new HashSet());
Java集合框架(二)—— HashSet、LinkedHashSet、TreeSet和EnumSet的更多相关文章
- Java集合框架之HashSet浅析
Java集合框架之HashSet浅析 一.HashSet综述: 1.1HashSet简介 位于java.util包下的HashSet是Java集合框架的重要成员,它在jdk1.8中定义如下: publ ...
- (Set, Map, Collections工具类)JAVA集合框架二
Java集合框架部分细节总结二 Set 实现类:HashSet,TreeSet HashSet 基于HashCode计算元素存放位置,当计算得出哈希码相同时,会调用equals判断是否相同,相同则拒绝 ...
- java 集合框架(二)Iterable接口
Iterable接口是java 集合框架的顶级接口,实现此接口使集合对象可以通过迭代器遍历自身元素,我们可以看下它的成员方法 修饰符和返回值 方法名 描述 Iterator<T> iter ...
- Java容器深入浅出之HashSet、TreeSet和EnumSet
Java集合中的Set接口,定义的是一类无顺序的.不可重复的对象集合.如果尝试添加相同的元素,add()方法会返回false,同时添加失败.Set接口包括3个主要的实现类:HashSet.TreeSe ...
- Java集合框架(二)
Set Set:无序,不可以重复元素. |--------HashSet:数据结构是哈希表. 线程是非同步的.保证元素唯一性的原理是:判断元素的hashCode值是否相同,如果相同,还会继续判断元素的 ...
- java集合框架(hashSet自定义元素是否相同,重写hashCode和equals方法)
/*HashSet 基本操作 * --set:元素是无序的,存入和取出顺序不一致,元素不可以重复 * (通过哈希值来判断是否是同一个对象) * ----HashSet:底层数据结构是哈希表, * 保证 ...
- java集合框架之HashSet
参考http://how2j.cn/k/collection/collection-hashset/364.html#nowhere 元素不能重复 Set中的元素,不能重复重复判断标准是: 首先看ha ...
- Java集合框架系列大纲
###Java集合框架之简述 Java集合框架之Collection Java集合框架之Iterator Java集合框架之HashSet Java集合框架之TreeSet Java集合框架之Link ...
- java集合框架之几种set(HashSet LinkedHashSet TreeSet )
参考http://how2j.cn/k/collection/collection-sets/691.html#nowhere HashSet LinkedHashSet TreeSet HashSe ...
随机推荐
- 基于esp8266的智能台灯DIY
研究esp8266已经很久了,特制作了一个智能灯, 代码如下,总结几点 一.关于arduino pro mini 的烧写方法 一定要在编译成功之后的下载提示出现的瞬间,单击复位按钮.才可进入烧写 二. ...
- node.js核心模块
全局对象 global 是全局变量的宿主 全局变量 在最外层定义的 全局对象的属性 隐士定义的变量(未定义直接赋值的变量) 当定义一个全局变量时 这个变量同时也会成为全局对象的属性 反之亦然 注意: ...
- 爬取知名社区技术文章_setting_5
# -*- coding: utf-8 -*- # Scrapy settings for JobBole project # # For simplicity, this file contains ...
- awk的sub函数和gsub函数的用法
1. sub函数 [root@nhserver1 10]# echo "a b c 2011-11-22 a:d" | awk 'sub(/-/,"",$4)' ...
- 【转】How to append current date and timestamp to filename in shell script
$ date +"FORMAT" now=$(date +"%Y-%m-%d-%S") filename="my_program.$now.log&q ...
- oracle pl/sql如何定义变量
目的:如何在pl/sql中定义基本类型,引用类型,记录型变量? 以下plsql程序用的scott用户的dept,emp表. 定义基本类型的变量 set serveroutput on ; --使用基本 ...
- 理解SSL/TLS协议
理解SSL/TLS协议 背景 早期我们在访问web时使用HTTP协议,该协议在传输数据时使用明文传输,明文传输带来了以下风险: 1.信息窃听风险,第三方可以获取通信内容 2.信息篡改风险,第三方可以篡 ...
- Spring MVC的DispatcherServlet
Spring MVC提供了一个名为org.springframework.web.servlet.DispatcherServlet的Selvet充当前端控制器,所有的请求驱动都围绕这个Dispatc ...
- spring之setter注入
setter注入分为2种 第一:普通属性注入 <bean id="userAction" class="com.xx.action.UserAction" ...
- 使用Django实现分页器功能
要使用Django实现分页器,必须从Django中导入Paginator模块 from django.core.paginator import Paginator 假如现在有150条记录要显示,每页 ...