
mysql用limit时offset越大时间越长
首先说明一下MySQL的版本:
mysql> select version();
+-----------+
| version() |
+-----------+
| 5.7.17 |
+-----------+
1 row in set (0.00 sec)
表结构:
mysql> desc test;
+--------+---------------------+------+-----+---------+----------------+
| Field | Type | Null | Key | Default | Extra |
+--------+---------------------+------+-----+---------+----------------+
| id | bigint(20) unsigned | NO | PRI | NULL | auto_increment |
| val | int(10) unsigned | NO | MUL | 0 | |
| source | int(10) unsigned | NO | | 0 | |
+--------+---------------------+------+-----+---------+----------------+
3 rows in set (0.00 sec)
id为自增主键,val为非唯一索引。
灌入大量数据,共500万:
mysql> select count(*) from test;
+----------+
| count(*) |
+----------+
| 5242882 |
+----------+
1 row in set (4.25 sec)
我们知道,当limit offset rows中的offset很大时,会出现效率问题:
mysql> select * from test where val=4 limit 300000,5;
+---------+-----+--------+
| id | val | source |
+---------+-----+--------+
| 3327622 | 4 | 4 |
| 3327632 | 4 | 4 |
| 3327642 | 4 | 4 |
| 3327652 | 4 | 4 |
| 3327662 | 4 | 4 |
+---------+-----+--------+
5 rows in set (15.98 sec)
为了达到相同的目的,我们一般会改写成如下语句:
mysql> select * from test a inner join (select id from test where val=4 limit 300000,5) b on a.id=b.id;
+---------+-----+--------+---------+
| id | val | source | id |
+---------+-----+--------+---------+
| 3327622 | 4 | 4 | 3327622 |
| 3327632 | 4 | 4 | 3327632 |
| 3327642 | 4 | 4 | 3327642 |
| 3327652 | 4 | 4 | 3327652 |
| 3327662 | 4 | 4 | 3327662 |
+---------+-----+--------+---------+
5 rows in set (0.38 sec)
时间相差很明显。
为什么会出现上面的结果?我们看一下select * from test where val=4 limit 300000,5;的查询过程:
查询到索引叶子节点数据。
根据叶子节点上的主键值去聚簇索引上查询需要的全部字段值。
类似于下面这张图: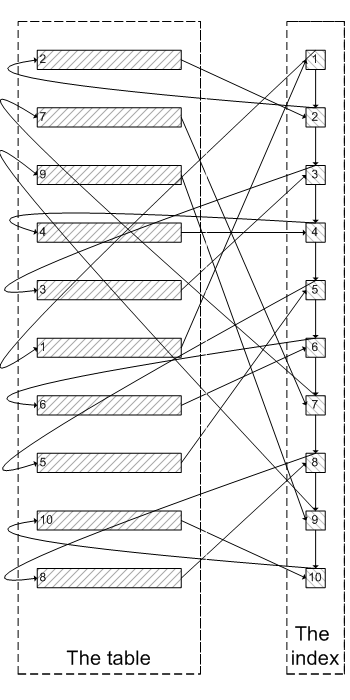
像上面这样,需要查询300005次索引节点,查询300005次聚簇索引的数据,最后再将结果过滤掉前300000条,取出最后5条。MySQL耗费了大量随机I/O在查询聚簇索引的数据上,而有300000次随机I/O查询到的数据是不会出现在结果集当中的。
肯定会有人问:既然一开始是利用索引的,为什么不先沿着索引叶子节点查询到最后需要的5个节点,然后再去聚簇索引中查询实际数据。这样只需要5次随机I/O,类似于下面图片的过程:
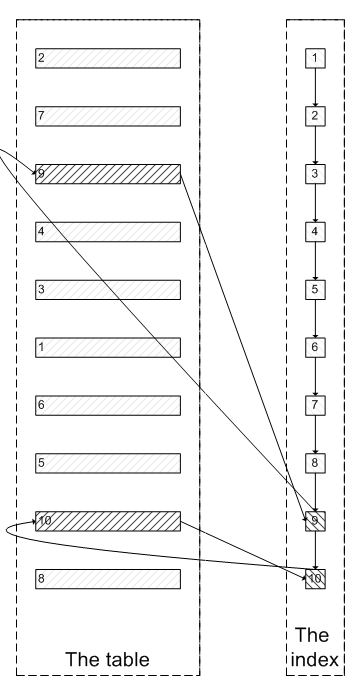
其实我也想问这个问题。
证实
下面我们实际操作一下来证实上述的推论:
为了证实select * from test where val=4 limit 300000,5是扫描300005个索引节点和300005个聚簇索引上的数据节点,我们需要知道MySQL有没有办法统计在一个sql中通过索引节点查询数据节点的次数。我先试了Handler_read_*系列,很遗憾没有一个变量能满足条件。
我只能通过间接的方式来证实:
InnoDB中有buffer pool。里面存有最近访问过的数据页,包括数据页和索引页。所以我们需要运行两个sql,来比较buffer pool中的数据页的数量。预测结果是运行select * from test a inner join (select id from test where val=4 limit 300000,5) b on a.id=b.id;之后,buffer pool中的数据页的数量远远少于select * from test where val=4 limit 300000,5;对应的数量,因为前一个sql只访问5次数据页,而后一个sql访问300005次数据页。
select * from test where val=4 limit 300000,5
mysql> select index_name,count(*) from information_schema.INNODB_BUFFER_PAGE where INDEX_NAME in('val','primary') and TABLE_NAME like '%test%' group by index_name;
Empty set (0.04 sec)
可以看出,目前buffer pool中没有关于test表的数据页。
mysql> select * from test where val=4 limit 300000,5;
+---------+-----+--------+
| id | val | source |
+---------+-----+--------+
| 3327622 | 4 | 4 |
| 3327632 | 4 | 4 |
| 3327642 | 4 | 4 |
| 3327652 | 4 | 4 |
| 3327662 | 4 | 4 |
+---------+-----+--------+
5 rows in set (26.19 sec)
mysql> select index_name,count(*) from information_schema.INNODB_BUFFER_PAGE where INDEX_NAME in('val','primary') and TABLE_NAME like '%test%' group by index_name;
+------------+----------+
| index_name | count(*) |
+------------+----------+
| PRIMARY | 4098 |
| val | 208 |
+------------+----------+
2 rows in set (0.04 sec)
可以看出,此时buffer pool中关于test表有4098个数据页,208个索引页。
select * from test a inner join (select id from test where val=4 limit 300000,5) b on a.id=b.id
为了防止上次试验的影响,我们需要清空buffer pool,重启mysql。
mysqladmin shutdown
/usr/local/bin/mysqld_safe &
mysql> select index_name,count(*) from information_schema.INNODB_BUFFER_PAGE where INDEX_NAME in('val','primary') and TABLE_NAME like '%test%' group by index_name;
Empty set (0.03 sec)
运行sql:
mysql> select * from test a inner join (select id from test where val=4 limit 300000,5) b on a.id=b.id;
+---------+-----+--------+---------+
| id | val | source | id |
+---------+-----+--------+---------+
| 3327622 | 4 | 4 | 3327622 |
| 3327632 | 4 | 4 | 3327632 |
| 3327642 | 4 | 4 | 3327642 |
| 3327652 | 4 | 4 | 3327652 |
| 3327662 | 4 | 4 | 3327662 |
+---------+-----+--------+---------+
5 rows in set (0.09 sec)
mysql> select index_name,count(*) from information_schema.INNODB_BUFFER_PAGE where INDEX_NAME in('val','primary') and TABLE_NAME like '%test%' group by index_name;
+------------+----------+
| index_name | count(*) |
+------------+----------+
| PRIMARY | 5 |
| val | 390 |
+------------+----------+
2 rows in set (0.03 sec)
我们可以看明显的看出两者的差别:第一个sql加载了4098个数据页到buffer pool,而第二个sql只加载了5个数据页到buffer pool。符合我们的预测。也证实了为什么第一个sql会慢:读取大量的无用数据行(300000),最后却抛弃掉。
而且这会造成一个问题:加载了很多热点不是很高的数据页到buffer pool,会造成buffer pool的污染,占用buffer pool的空间。
遇到的问题
为了在每次重启时确保清空buffer pool,我们需要关闭innodb_buffer_pool_dump_at_shutdown和innodb_buffer_pool_load_at_startup,这两个选项能够控制数据库关闭时dump出buffer pool中的数据和在数据库开启时载入在磁盘上备份buffer pool的数据。
mysql用limit时offset越大时间越长的更多相关文章
- 越大优先级越高,优先级越高被OS选中的可能性就越大
进程的休眠:Thread sleep(1000);//括号中以毫秒为单位 当main()运行完毕,即使在结束时时间片还没有用完,CPU也放弃此时间片,继续运行其他程序. Try{Thread.slee ...
- 权力越大职责越大——C#中的职责链模式
大家好,欢迎来到老胡的博客,今天我们继续了解设计模式中的职责链模式,这是一个比较简单的模式.跟往常一样,我们还是从一个真实世界的例子入手,这样大家也对这个模式的应用场景有更深刻的理解. 一个真实的 ...
- android:layout_weight越大所占比例越大和越大所占比例越小的两个例子
摘要: 我的技术博客经常被流氓网站恶意爬取转载.请移步原文:http://www.cnblogs.com/hamhog/p/3907146.html,享受整齐的排版.有效的链接.正确的代码缩进.更好的 ...
- idea svn提交时,performing vcs refresh时间很长的解决办法
解决方法:version control -> local changes -> local changelist 列表中无用的文件或文件夹右键选择svn忽略 ps:原因是文件太多,导致对 ...
- C市现在要转移一批罪犯到D市,C市有n名罪犯,按照入狱时间有顺序,另外每个罪犯有一个罪行值,值越大罪越重。现在为了方便管理,市长决定转移入狱时间连续的c名犯人,同时要求转移犯人的罪行值之和不超过t,问有多少种选择的方式?
// ConsoleApplication12.cpp : 定义控制台应用程序的入口点. // #include "stdafx.h" // ConsoleApplication1 ...
- From 易水寒 格局越大 人生越宽
有这么一则故事:三个泥瓦匠在砌墙,一个人走过来,问他们在干什么. 第一个泥瓦匠没好气地说,你没看见吗?我在辛苦地砌墙呢.第二个回答,我们正在建一座高楼.第三个则洋溢着喜悦说,我们正在创造美好生活. 1 ...
- 7kyu (难度系数kyu阶段数值越大难度越低) 数组分组及求和
几个人排成一排,分成两队.第一个人进入一队,第二个人进入第二队,第三个人进入第一队,以此类推. 给定一个正整数的数组(人的权重),返回两个整数的新数组/元组,其中第一个是第1组的总重量,第二个是第2组 ...
- MYSQL分页 limit 太慢优化
limit分页原理 当我们翻到最后几页时,查询的sql通常是:select * from table where column=xxx order by xxx limit 1000000,20.查询 ...
- 你们一般都是怎么进行SQL调优的?MySQL在执行时是如何选择索引的?
前言 过年回来的第二周了,终于有时间继续总结知识了.这次来看一下SQL调优的知识,这类问题基本上面试的时候都会被问到,无论你的岗位是后端,运维,测试等等. 像本文标题中的两个问题,就是我在实际面试过程 ...
随机推荐
- shior笔记
Shiro 是一个强大而灵活的开源安全框架,能够非常清晰的处理认证.授权.管理会话以及密码加密.如下是它所具有的特点: 易于理解的 Java Security API: 简单的身份认证(登录),支持多 ...
- [poj3107]Godfather_树形dp_树的重心
Godfather poj-3107 题目大意:求树的重心裸题. 注释:n<=50000. 想法:我们尝试用树形dp求树的重心,关于树的重心的定义在题目中给的很明确.关于这道题,我们邻接矩阵存不 ...
- 关于JQuery的绑定方法
从jQuery1.7开始,jQuery引入了全新的事件绑定机制,on()和off()两个函数统一处理事件绑定.因为在此之前有bind(), live(), delegate()等方法来处理事件绑定,j ...
- [BZOJ 1079][SCOI 2008]着色方案
1079: [SCOI2008]着色方案 Time Limit: 10 Sec Memory Limit: 162 MBSubmit: 2237 Solved: 1361[Submit][Stat ...
- 用Python满足满足自己的“小虚荣”
首先声明,学习这个只是为了好玩,只是为了好玩,并不是想用这个弄虚作假,做一些不好的事情!一心想做技术人,自制自治! 我们有时候发布一篇日志,或者是一篇博文,总希望自己的浏览量能高点,这样看起来也倍有面 ...
- 201621123062《java程序设计》第六周作业总结
1. 本周学习总结 1.1 面向对象学习暂告一段落,请使用思维导图,以封装.继承.多态为核心概念画一张思维导图或相关笔记,对面向对象思想进行一个总结. 注1:关键词与内容不求多,但概念之间的联系要清晰 ...
- 201621123057 《Java程序设计》第2周学习总结
一.本周学习总结 基本数据类型 char实质属于整型.boolean类型取值只有true和false两种. 引用数据类型 包装类:自动装箱 与 自动拆箱 数组:一维数组遍历数组用foreach循环:多 ...
- nyoj 仿射密码
仿射密码 时间限制:1000 ms | 内存限制:65535 KB 难度:1 描述 仿射密码是替换密码的另一个特例,可以看做是移位密码和乘数密码的结合.其加密变换如下: E(m)=(k1*m+k2) ...
- Java排序算法之快速排序
Java排序算法之快速排序 快速排序(Quicksort)是对冒泡排序的一种改进. 快速排序由C. A. R. Hoare在1962年提出.它的基本思想是:通过一趟排序将要排序的数据分割成独立的两部分 ...
- sublimeText3 中配置sass环境,并将编译后文件保存到指定文件夹
sass基于ruby引擎,所以安装时ass.compass之前需要安装ruby.具体的链接应该是(http://rubyinstaller.org/downloads).下载并安装相应的版本,勾选第二 ...