
微服务—分布式服务追踪sleuth和zipkin
随着业务的发展,系统规模也会越来越大,各微服务间的调用关系也越来越错综复杂。
通常一个客户端发起的请求在后端系统中会经过多个不同的微服务调用来协同产生最后的请求结果,
在复杂的微服务架构系统中,几乎每一个前端请求都会形成一条复杂的分布式服务调用链路,在每条链路中任何一个依赖服务出现延迟过高或错误的时候都会引起请求最后的失败。
这时候,对于每一个请求,全链路调用的跟踪就变得越来越重要,通过实现对请求调用的跟踪可以帮助我们快速发现错误根烟以及监控分析每条链路上的性能瓶颈。
现今业界分布式服务跟踪的理论基础主要来自于 Google 的一篇论文《Dapper, a Large-Scale Distributed Systems Tracing Infrastructure》,
使用最为广泛的开源实现是 Twitter 的 Zipkin,为了实现平台无关、厂商无关的分布式服务跟踪,CNCF 发布了布式服务跟踪标准 Open Tracing。
国内,淘宝的“鹰眼”、京东的“Hydra”、大众点评的“CAT”、新浪的“Watchman”、唯品会的“Microscope”、窝窝网的“Tracing”都是这样的系统。
Spring Cloud Sleuth

服务跟踪原理
分布式系统的服务跟踪主要包括下面两个关键点:
1.为了实现请求跟踪,当请求发送到分布式系统的入口端点时,只需要服务跟踪框架为该请求创建一个唯一的跟踪标识Trace ID,
同时在分布式系统内部流转的时候,框架失踪保持该唯一标识,直到返回给请求方位置。
服务追踪的追踪单元是从客户发起请求(request)抵达被追踪系统的边界开始,到被追踪系统向客户返回响应(response)为止的过程,称为一个“trace”。
2.为了统计各处理单元的时间延迟,当请求到达各个服务组件时,也是通过一个唯一标识Span ID来标记它的开始,具体过程以及结束。对每一个Span来说,它必须有开始和结束两个节点,通过记录开始Span和结束Span的时间戳,就能统计出该Span的时间延迟,除了时间戳记录之外,它还可以包含一些其他元数据,比如时间名称、请求信息等。
这样,若干个有序的 span 就组成了一个 trace。在系统向外界提供服务的过程中,会不断地有请求和响应发生,也就会不断生成 trace,把这些带有span 的 trace 记录下来,就可以描绘出一幅系统的服务拓扑图。附带上 span 中的响应时间,以及请求成功与否等信息,就可以在发生问题的时候,找到异常的服务;根据历史数据,还可以从系统整体层面分析出哪里性能差,定位性能优化的目标。
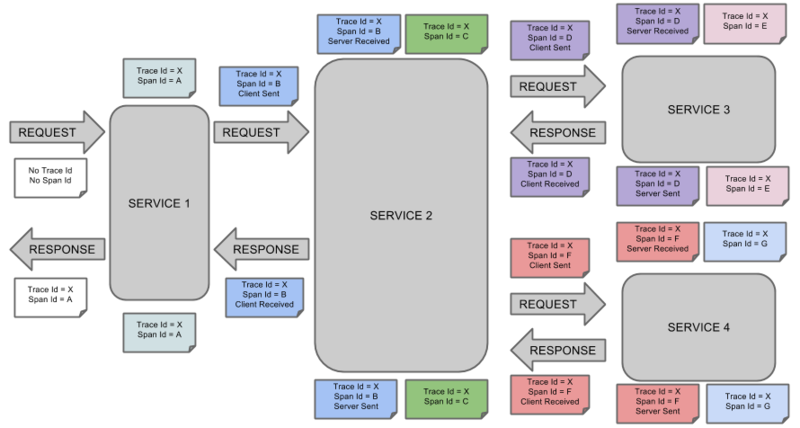
Spring Cloud Sleuth为服务之间调用提供链路追踪。通过Sleuth可以很清楚的了解到一个服务请求经过了哪些服务,每个服务处理花费了多长。从而让我们可以很方便的理清各微服务间的调用关系。此外Sleuth可以帮助我们:
- 耗时分析: 通过Sleuth可以很方便的了解到每个采样请求的耗时,从而分析出哪些服务调用比较耗时;
- 可视化错误: 对于程序未捕捉的异常,可以通过集成Zipkin服务界面上看到;
- 链路优化: 对于调用比较频繁的服务,可以针对这些服务实施一些优化措施。
spring cloud sleuth可以结合zipkin,将信息发送到zipkin,利用zipkin的存储来存储信息,利用zipkin ui来展示数据。
ZipKin
Zipkin 是一个开放源代码分布式的跟踪系统,由Twitter公司开源,它致力于收集服务的定时数据,以解决微服务架构中的延迟问题,包括数据的收集、存储、查找和展现。
每个服务向zipkin报告计时数据,例如用户每次请求服务的处理时间等,可方便的监测系统中存在的瓶颈。
zipkin会根据调用关系通过Zipkin UI生成依赖关系图。
搭建方法:
1.建立一个Zipkin server,只需要在pom中添加依赖、在properties文件中配置端口服务名等、在启动类中添加@EnableZipkinServer注解。
<dependency>

        <groupId>io.zipkin.java</groupId>

        <artifactId>zipkin-server</artifactId>

</dependency>
<dependency>

        <groupId>io.zipkin.java</groupId>

        <artifactId>zipkin-autoconfigure-ui</artifactId>

</dependency>
2.在每个服务提供项目中添加zipkin支持
<dependency>

      <groupId>org.springframework.cloud</groupId>

      <artifactId>spring-cloud-starter-sleuth</artifactId>

</dependency>

<dependency>

      <groupId>org.springframework.cloud</groupId>

      <artifactId>spring-cloud-starter-zipkin</artifactId>

</dependency>
Spring应用在监测到Java依赖包中有sleuth和zipkin后,会自动在RestTemplate的调用过程中向HTTP请求注入追踪信息,并向Zipkin Server发送这些信息。
在配置文件中添加代码:
spring:

  zipkin:

    base-url: http://localhost:9000

  sleuth:

    sampler:

      percentage: 1.0
spring.zipkin.base-url指定了Zipkin服务器的地址,spring.sleuth.sampler.percentage将采样比例设置为1.0,也就是全部都需要。
微服务—分布式服务追踪sleuth和zipkin的更多相关文章
- Spring Cloud 微服务分布式链路跟踪 Sleuth 与 Zipkin
Zipkin 是一个开放源代码分布式的跟踪系统,由 Twitter 公司开源,它致力于收集服务的定时数据,以解决微服务架构中的延迟问题,包括数据的收集.存储.查找和展现.它的理论模型来自于Google ...
- Spring Cloud(十二):分布式链路跟踪 Sleuth 与 Zipkin【Finchley 版】
Spring Cloud(十二):分布式链路跟踪 Sleuth 与 Zipkin[Finchley 版] 发表于 2018-04-24 | 随着业务发展,系统拆分导致系统调用链路愈发复杂一个前端请 ...
- 分布式链路跟踪 Sleuth 与 Zipkin【Finchley 版】
原创: dqqzj SpringForAll社区 今天 Spring Cloud Sleuth Span是基本的工作单位. 例如,发送 RPC是一个新的跨度,就像向RPC发送响应一样. 跨度由跨度唯一 ...
- 基于Dapper的分布式链路追踪入门——Opencensus+Zipkin+Jaeger
微信搜索公众号 「程序员白泽」,进入白泽的编程知识分享星球 最近做了一些分布式链路追踪有关的东西,写篇文章来梳理一下思路,或许可以帮到想入门的同学.下面我将从原理到demo为大家一一进行讲解,欢迎评论 ...
- 带入gRPC:分布式链路追踪 gRPC + Opentracing + Zipkin
在实际应用中,你做了那么多 Server 端,写了 N 个 RPC 方法.想看看方法的指标,却无处下手? 本文将通过 gRPC + Opentracing + Zipkin 搭建一个分布式链路追踪系统 ...
- SpringCloud初体验:六、利用 Sleuth 和 Zipkin 给微服务加上链路监控追踪查看功能
首先:装上 Zipkin 服务,收集调用链跟踪数据,体验时装在了本机docker上, 方便快捷 docker run -d -p : openzipkin/zipkin 安装后访问地址也是 9411端 ...
- 学习一下 SpringCloud (五)-- 配置中心 Config、消息总线 Bus、链路追踪 Sleuth、配置中心 Nacos
(1) 相关博文地址: 学习一下 SpringCloud (一)-- 从单体架构到微服务架构.代码拆分(maven 聚合): https://www.cnblogs.com/l-y-h/p/14105 ...
- Spring Boot + Spring Cloud 构建微服务系统(八):分布式链路追踪(Sleuth、Zipkin)
技术背景 在微服务架构中,随着业务发展,系统拆分导致系统调用链路愈发复杂,一个看似简单的前端请求可能最终需要调用很多次后端服务才能完成,那么当整个请求出现问题时,我们很难得知到底是哪个服务出了问题导致 ...
- spring cloud 入门系列八:使用spring cloud sleuth整合zipkin进行服务链路追踪
好久没有写博客了,主要是最近有些忙,今天忙里偷闲来一篇. =======我是华丽的分割线========== 微服务架构是一种分布式架构,微服务系统按照业务划分服务单元,一个微服务往往会有很多个服务单 ...
随机推荐
- jsp导出到Excel
jsp模板文件 <%@ page isELIgnored="false" contentType="application/x-msdownload; charse ...
- python 绘制3D散点图
import scipy.io as sio from mpl_toolkits.mplot3d import Axes3D import matplotlib.pyplot as plt a = [ ...
- vue 添加过滤器-以格式化日期为例
vue的filter和angular的pipe管道类似,是过滤器 官网:https://cn.vuejs.org/v2/guide/filters.html 添加格式化日期的全局过滤器 在main.j ...
- UVALive 6933 Virus synthesis(回文树)
Viruses are usually bad for your health. How about ghting them with... other viruses? In this proble ...
- Tilera--100核cpu
市场对多核的需求越来越多,主要是因为单核处理能力不可能像以往那样不断地提升.从上世纪90 年代开始,整个产业遵循摩尔定律,即芯片上可容纳的晶体管数目每隔18个月便会增加一倍,性能也提升一倍.随着时间的 ...
- 解决kindeidtor与struts2框架交互WARN OgnlValueStack:68 - Error setting value [[Ljava.lang.String;@10da4df]的bug
当用使用ssh框架,前端用到kindeitor富文本编辑器时候,上传文件后有一个图片管理.当点击图片管理的时候,在后台会报一个异常: WARN OgnlValueStack:68 - Error se ...
- openresty跑定时任务配置、ngx.timer.every接口使用
openresty的定时任务是要跟worker绑定的.如果不绑定特定的worker,那么所有启动的woker都会去执行定时任务. 一般情况下默认绑定worker_id=0的,这样在nginx整个进程里 ...
- geo实现方案
1.数据库内在支持GIS(地理信息系统) MySQL: 目前只有MyISAM引擎是支持GIS的,Innodb在5.7版本中才支持空间索引.MyISAM这个引擎不支持事务.外键,而且是表锁.适合读为主, ...
- java-mybaits-00503-延迟加载
1.什么是延迟加载 resultMap可以实现高级映射(使用association.collection实现一对一及一对多映射),association.collection具备延迟加载功能. 需求: ...
- Spark 2.2 DataFrame的一些算子操作
Spark Session中的DataFrame类似于一张关系型数据表.在关系型数据库中对单表或进行的查询操作,在DataFrame中都可以通过调用其API接口来实现. 可以参考,Scala提供的Da ...