
分布式文件管理系统_FastDFS集群
简单介绍
1,client storage tracker的关系
先用一幅图来解释用户如何访问一个通过DFS管理的文件
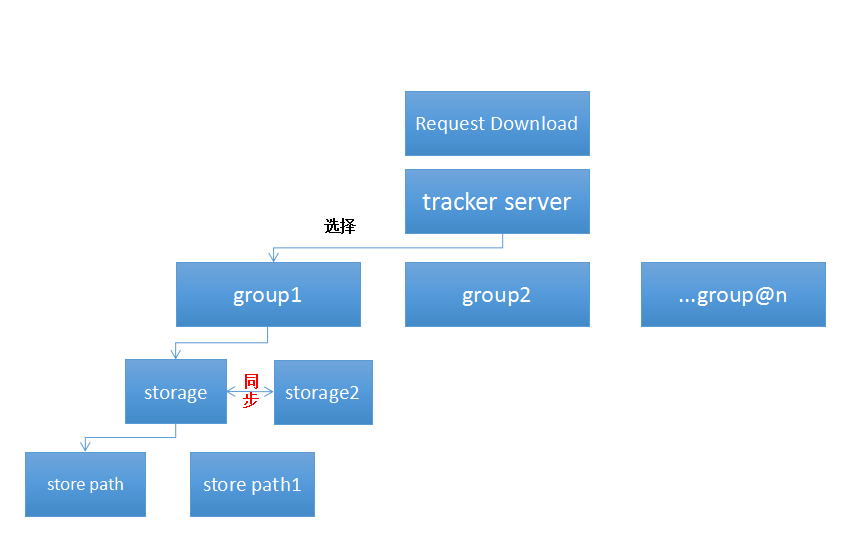
一般来说,一台服务器只有一个storage server,多个storage server可以组成一个group,同一group间storage server的数据自动同步(备份与恢复)。
不同group数据互相隔离,一个tracker可以管理多个group,也可以多对多。
client用于管理 tracker server 和storage server。
FAST_DFS安装
下载并解压DFS压缩包,可以看到附带的 INSTALL 文本文件,以下安装步骤基于此。
#step . 从下面的链接下载libfastcommon压缩包,并按默认配置安装
   https://github.com/happyfish100/libfastcommon.git

#step . 下载好DFS压缩包并解压,
tar xzf FastDFS_v5.x.tar.gz
#for example:
tar xzf FastDFS_v5..tar.gz

#step . 进入FastDFS文件夹
cd FastDFS

#step . 执行命令:
./make.sh

#step . 执行安装命令:
./make.sh install
tip:在没有指定安装路径的默认情况下,安装完成后启动脚本在目录/usr/bin/下,相关的配置文件在/etc/fdfs/下。

#step . edit/modify the config file of tracker and storage(修改配置文件,暂时可以跳过)

#step . 启动DFS服务
#首先 start the tracker server:
/usr/bin/fdfs_trackerd /etc/fdfs/tracker.conf restart

#然后start the storage server:
/usr/bin/fdfs_storaged /etc/fdfs/storage.conf restart

#step . 用测试程序测试服务可用性。
#for example, upload a file:
/usr/bin/fdfs_test /etc/fdfs/client.conf.sample upload /etc/fdfs/client.conf.sample
打印如下信息即认为测试通过

This is FastDFS client test program v5.08

Copyright (C) 2008, Happy Fish / YuQing

FastDFS may be copied only under the terms of the GNU General
Public License V3, which may be found in the FastDFS source kit.
Please visit the FastDFS Home Page http://www.csource.org/
for more detail.

[2017-03-21 21:03:35] DEBUG - base_path=/home/yuqing/fastdfs, connect_timeout=30, network_timeout=60, tracker_server_count=1, anti_steal_token=0, anti_steal_secret_key length=0, use_connection_pool=0, g_connection_pool_max_idle_time=3600s, use_storage_id=0, storage server id count: 0

tracker_query_storage_store_list_without_group:
        server 1. group_name=, ip_addr=YOUR_TRACKER_IP, port=23000

group_name=group1, ip_addr=YOUR_TRACKER_IP, port=23000
storage_upload_by_filename
group_name=group1, remote_filename=M00/00/00/rBFUJljRJKeAYwsjAAAFtJDWG_U.sample
source ip address: YOUR_TRACKER_IP
file timestamp=2017-03-21 21:03:35
file size=1460
file crc32=2429950965
example file url: http://YOUR_TRACKER_IP/group1/M00/00/00/rBFUJljRJKeAYwsjAAAFtJDWG_U.sample
storage_upload_slave_by_filename
group_name=group1, remote_filename=M00/00/00/rBFUJljRJKeAYwsjAAAFtJDWG_U_big.sample
source ip address: YOUR_TRACKER_IP
file timestamp=2017-03-21 21:03:35
file size=1460
file crc32=2429950965
example file url: http://YOUR_TRACKER_IP/group1/M00/00/00/rBFUJljRJKeAYwsjAAAFtJDWG_U_big.sample

#step . 通过控制台查看服务运行的详细信息
/usr/bin/fdfs_monitor <client_conf_filename>
集成Nginx以支持外部网络访问
Nginx的安装不在此赘述。
安装好Nginx后修改配置文件部分内容:
server {
        listen       ;
        server_name  YOUR_HOST_NAME;
        location /M00 {
        #设置主机头和客户端真实地址,以便服务器获取客户端真实IP
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_buffering off;
        root /home/yuqing/fastdfs/data;
      }
    }
root路径为storage.conf中指定的base_path
成功启动Nginx后,尝试使用 URL:YOUR_IP/M00/00/00/rBFUJljRLMmAI7ZOAAAFtJDWG_U_big.sample 从外网访问已经成功上传的测试文本,发现RESPONSE 404,无法访问。
查看Nginx日志error.log
// :: [error] #: * open() "/home/yuqing/fastdfs/data/M00/00/00/rBFUJljRLMmAI7ZOAAAFtJDWG_U_big.sample" failed (2: No such file or directory), client: ......
分析原因:
通过URL打开的文件目录是/home/yuqing/fastdfs/data/M00/00/00,而实际的存放目录是/home/yuqing/fastdfs/data/00/00。
发现多了一层不存在的目录M00:FastDFS支持多个磁盘(base path),所以要通过Mxx来区分,其中xx为磁盘的序号,基于0。
解决办法为/home/yuqing/fastdfs/data/M00/00/00创建软连接
ln -s /home/yuqing/fastdfs/data /home/yuqing/fastdfs/data/M00
storage节点增加硬盘
目的有两个扩容和提升部分性能。
修改storage.conf部分属性
#存储路径的数量 count(store_path)
store_path_count=
#指定存储路径
store_path0=/home/yuqing/fastdfs
#增加的另一块硬盘路径
store_path1=/usr/local/dfsdata
修改tracker.conf部分属性
#选择storage server储存路径的方式
#:轮询
#:负载均衡
store_path=
重启两个服务
./fdfs_trackerd /etc/fdfs/tracker.conf restart
./fdfs_storaged /etc/fdfs/storage.conf restart
略微延迟后,可以在store_path1目录下看到有生成文件的存放目录。
再次使用相同的测试方法上传文件,会生成以M01开头的文件路径。
/M01/00/04/rBFUJljR4zOAaxHOAAAAVJyyfIA543.txt
验证发现这是保存在store_path1路径下的,正好和前面解释M00的含义呼应。
为支持新磁盘外网访问
方式一
修改nginx.conf 部分属性。
location /M01 {
             #设置主机头和客户端真实地址,以便服务器获取客户端真实IP
             proxy_set_header Host $host;
             proxy_set_header X-Real-IP $remote_addr;
             proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
             #禁用缓存
             proxy_buffering off;
             root store_path1/data;
      }
添加软连接
ln -s /usr/local/dfsdata/data /usr/local/dfsdata/data/M01
重启Nginx服务
推荐-方式二
给Nginx安装fastdfs-nginx-module插件
解压后按附带的INTALL文件安装。
注意:需要把FastDFS安装包内的配置文件http.conf mime.types和fastdfs-nginx-module压缩包内的mod_fastdfs.conf复制一份到/etc/fdfs/目录下。
修改nginx.conf 部分属性:
删除匹配 /M00和/M01
增加后缀名匹配(按需增加)
location ~* .(gif|jpg|jpeg|txt)$ {
             proxy_set_header Host $host;
             proxy_set_header X-Real-IP $remote_addr;
             proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
             #禁用缓存
             proxy_buffering off;
             ngx_fastdfs_module;
      }
修改mod_fastdfs.conf部分属性:
store_path_count=
store_path0=/home/yuqing/fastdfs
store_path1=/usr/local/dfsdata
以上值必须和storage.conf配置对应值保持一致。
重启Nginx服务
同一个group之间storage server数据同步
当 storage server 定义有相同的group_name时,认为它们是同一group,同一个group之间文件相互更新同步。所以常用做备份数据,提高系统的可靠性。
(测试时注意,在同一台服务器上通过修改端口的方式运行多个storage server是不可行的,会导致其中一个server无法正常使用。)
为group增加storage节点不用修改tracker server配置,是独立进行的。
增加节点时,系统会立即进行数据同步,所以会增加系统负荷,推荐在系统运行空闲时再操作。
增加节点时修改group_name为storage server指定group。
增加的节点配置储存路径数量需要和同一个group的其它节点数量保持一致。即store_path_count参数值相等。具体的路径可以不同。
否则tracker server有如下报错信息:
[-- ::] ERROR - file: tracker_mem.c, line: , client ip: less than that of the group "group1", the group store_path_count is 2
启动storage server 2
查看日志(省略部分信息)
data path: /home/yuqing/fastdfs2/data, mkdir sub dir done.
[-- ::] DEBUG - file: tracker_client_thread.c, line: , report thread to tracker server *: started
[-- ::] INFO - file: tracker_client_thread.c, line: , successfully connect to tracker server *:, as a tracker client, my ip is *
[-- ::] INFO - file: tracker_client_thread.c, line: , tracker server *:, set tracker leader:
[-- ::] DEBUG - file: storage_sync.c, line: , sync thread to storage server *: started
[-- ::] INFO - file: storage_sync.c, line: , successfully connect to storage server *:
[-- ::] DEBUG - file: storage_service.c, line: , client ip: 172.17.84.38, storage server id: *
可以读出,当组内增加新节点时,它们的工作流程大致是:
INIT
!--1 在指定的store_path生成存放目录
!--2 开启tracker_client_thread通知tracker server :有新的节点加入。
!--3 成功与tracker server连接
SYCNING
!-------1 开启sync thread,准备数据同步
!-------2 进行数据同步(耗时)
!-------3 所有数据同步成功
ACTIVE
!----------1 成为组内一员
测试可靠性
!--s 1
组内其中一台storage server被执行rm命令或者磁盘坏道导致数据丢失时,组内其它storage server不会执行同步命令。
storage server重启后,会从组内选择一个数据完整的storage server进行增量更新。
!--s 2
组内其中一台storage server down掉,系统仍然正常运行。(每一台storage server都需要安装fastdfs-nginx-module插件并正确配置)
查看Nginx日志:
/Mar/::: +] "GET /M01/00/00/rBFUJ1jSOaCAMPUNAAAAVJyyfIA114.txt?redirect=1 HTTP/1.0" 200 84 "-" "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.104 Safari/537.36 Core/1.53.2372.400 QQBrowser/9.5.10548.400"
通过控制台查看集群运行情况
#运行命令
 ./fdfs_monitor /etc/fdfs/client.conf.sample
#查看信息(省略部分信息)
tracker server
group count:
Group :
group name = group1
storage server count =
active server count =
disk total space =  MB
disk free space =  MB
        Storage :
                ip_addr = 172.17.84.38  ACTIVE
                join time = -- ::
                up time = -- ::
                last_heart_beat_time = -- ::
                last_source_update = -- ::
                last_sync_update = -- ::
                last_synced_timestamp = -- :: (never synced)
        Storage :
                ip_addr = 172.17.84.39  ACTIVE
                join time = -- ::
                up time = -- ::
                last_heart_beat_time = -- ::
                last_source_update = -- ::
                last_sync_update = -- ::
                last_synced_timestamp = -- :: (0s delay)
分布式文件管理系统_FastDFS集群的更多相关文章
- JDFS:一款分布式文件管理系统,第四篇(流式云存储续篇)
一 前言 本篇博客是JDFS系列博客的第四篇,从最初简单的上传.下载,到后来加入分布式功能,背后经历了大量的调试,尤其当实验的虚拟计算结点数目增加后,一些潜在的隐藏很深的bug就陆续爆发.在此之前笔者 ...
- JDFS:一款分布式文件管理系统,第五篇(整体架构描述)
一 前言 截止到目前为止,虽然并不完美,但是JDFS已经初步具备了完整的分布式文件管理功能了,包括:文件的冗余存储.文件元信息的查询.文件的下载.文件的删除等.本文将对JDFS做一个总体的介绍,主要是 ...
- 分布式文件管理系统HDFS
Hadoop 分布式文件管理系统HDFS可以部署在廉价硬件之上,能够高容错. 可靠地存储海量数据(可以达到TB甚至PB级),它还可以和Yam中的MapReduce 编程模型很好地结合,为应用程序提供高 ...
- 手把手教你用 FastDFS 构建分布式文件管理系统
说起分布式文件管理系统,大家可能很容易想到 HDFS.GFS 等系统,前者是 Hadoop 的一部分,后者则是 Google 提供的分布式文件管理系统.除了这些之外,国内淘宝和腾讯也有自己的分布式文件 ...
- 分布式搜索ElasticSearch构建集群与简单搜索实例应用
分布式搜索ElasticSearch构建集群与简单搜索实例应用 关于ElasticSearch不介绍了,直接说应用. 分布式ElasticSearch集群构建的方法. 1.通过在程序中创建一个嵌入es ...
- 分布式协调服务Zookeeper集群之ACL篇
分布式协调服务Zookeeper集群之ACL篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.zookeeper ACL相关知识概览 1>.zookeeper官方文档(h ...
- 分布式协调服务Zookeeper集群监控JMX和ZkWeb应用对比
分布式协调服务Zookeeper集群监控JMX和ZkWeb应用对比 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. JMX是用来远程监控Java应用的框架,这个也可以用来监控其他的J ...
- 分布式协调服务Zookeeper集群搭建
分布式协调服务Zookeeper集群搭建 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.安装jdk环境 1>.操作环境 [root@node101.yinzhengjie ...
- 分布式存储系统之Ceph集群RBD基础使用
前文我们了解了Ceph集群cephx认证和授权相关话题,回顾请参考https://www.cnblogs.com/qiuhom-1874/p/16748149.html:今天我们来聊一聊ceph集群的 ...
随机推荐
- Javascript的简单测试环境
在<JavaScript忍者秘籍>2.4测试条件基础知识中,作者给出了一个精简版的assert和assert组的实现,对于初学者而言,这无疑是一个很好的例子,既让我们得到了一个好用的小工具 ...
- 决策树和基于决策树的集成方法(DT,RF,GBDT,XGB)复习总结
摘要: 1.算法概述 2.算法推导 3.算法特性及优缺点 4.注意事项 5.实现和具体例子 内容: 1.算法概述 1.1 决策树(DT)是一种基本的分类和回归方法.在分类问题中它可以认为是if-the ...
- js加载XML文件
// XML文件 <?xml version="1.0" encoding="gb2312"?> <root> <father n ...
- POJ 2914 Minimum Cut Stoer Wagner 算法 无向图最小割
POJ 2914 题意:给定一个无向图 小于500节点,和边的权值,求最小的代价将图拆为两个联通分量. Stoer Wagner算法: (1)用类似prim算法的方法求"最大生成树" ...
- BZOJ 3432: [Usaco2014 Jan]Cross Country Skiing (二分+染色法)
还是搜索~~可以看出随着D值的增大能到达的点越多,就2分d值+染色法遍历就行啦~~~ CODE: #include<cstdio>#include<iostream>#incl ...
- 简单说说Markdown语法
# 简单说说 MarkDown 语法 html,body,div,span,applet,object,iframe,h1,h2,h3,h4,h5,h6,p,blockquote,pre,a,abbr ...
- BOM元素之location对象
location对象提供了与当前窗口中加载的文档有关的信息,还提供了一些导航功能,它既是window对象的属性,也是document对象的属性:换句话说,window.location和documen ...
- List实现行转列的通用方案
最近在做报表统计方面的需求,涉及到行转列报表.根据以往经验使用SQL可以比较容易完成,这次决定挑战一下直接通过代码方式完成行转列.期间遇到几个问题和用到的新知识这里整理记录一下. 阅读目录 问题介绍 ...
- C#如何获取指定周的日期范围
1. 不允许跨年 1) 第一周的第一天从每年的第一天开始,最后一周的最后一天为每年的最后一天. static void Main(string[] args) { DateTime first, la ...
- 【RecyclerView与Glide】实现一个Android电子书阅读APP
http://www.cnblogs.com/xfangs/ 欢迎在本文下方评论,小方很需要鼓励支持!!! 本系列教程仅供学习交流 小说阅读器最终实现效果见 第一篇博文 前言 在上一篇文章中,我们实现 ...