
【现学现卖】python小爬虫
1.给小表弟汇总一个院校列表,想来想去可以写一个小爬虫爬下来方便些,所以就看了看怎么用python写,到了基本能用的程度,没有什么特别的技巧,大多都是百度搜的,遇事不决问百度啦
2.基本流程就是:
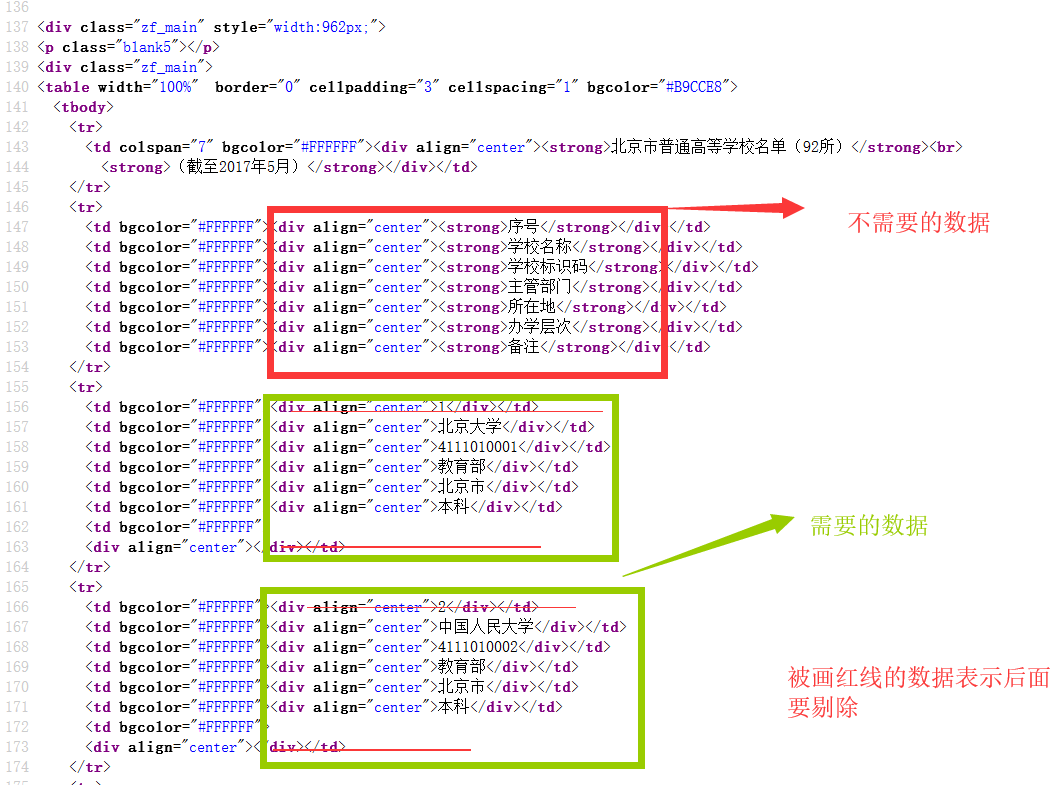
用request爬取一个页面之后用BeautifulSoup4对爬到的页面进行处理,
然后需要的东西进行预处理之后存到桌面上的.txt文件里,
之后再对.txt文件里的字符串进行分割,
最后把数据存到excel表里
3.准备:需要下载安装requests库,以及BeautifulSoup4的库,还有xlsxwriter库,相关安装方法网上一大堆
4.爬取页面的网页源代码:
5.将爬取的数据存到.txt文件中:
from bs4 import BeautifulSoup

import requests

import os

def get_soup():

    r = requests.get("http://www.eol.cn/html/g/gxmd/bj/", timeout=30)

    # 判断网络链接的状态,连接错误将产生一个异常

    #print(r.status_code)

    r.encoding = r.apparent_encoding

    soup = BeautifulSoup(r.text,features="html.parser")

    return soup;

#删除前几个元素

def del_previous_ele(full_list):

    for i in range(8):

        full_list.remove(full_list[0])

    return full_list;

#获取学校名称,学校编号,主管部门,办学层次

def select_school_ele(full_list):

    school_list = []

    for i in range(full_list.__len__()):

        //这里是对获取的所有学校列表进行遍历,取出需要的数据

        if (i % 7) == 1 or (i % 7) == 2 or (i % 7) == 3 or (i%7) == 5 :

            school_list.append(full_list[i].string+"\t")

            //获取到一个学校完整的信息之后就在后面换行

            if (i%7) == 5:

                school_list.append(" \n")

        else:

            pass

    return school_list;


#将数据写入文件

def createFile(txt):

    file = open('C:\\Users\\XXXXXXXXXXXXXXX\\Desktop\\school.txt', 'w')

    file.writelines(txt)

    file.close();

    print("写入成功")

if __name__ == "__main__":

    soup = get_soup()

    full_list = del_previous_ele(soup.find_all(align="center"))

    school_list = select_school_ele(full_list)

    createFile(school_list)
6.对school.txt文件进行处理,处理完了存到excel文件里
import os

import xlsxwriter

def get_file(path,mode_):

    list = "";

    file = open(path,mode_)

    list = file.read()

    file.close()

    return list

def write_excel(list):

    workbook = xlsxwriter.Workbook("C:\\Users\\XXXXXXXXXXXXXXXXX\\Desktop\\school.xlsx")

    worksheet = workbook.add_worksheet("school")

    #5个属性为一组

    list_5_item = list.split("\n")

   # print(len(list_5_item))

    for i in range(len(list_5_item)):

        specific_school = list_5_item[i].split("\t")

        print(len(specific_school))

        for j in range(len(specific_school)):

            worksheet.write( i , j , specific_school[j])

if __name__ == "__main__":

    list = get_file('C:\\Users\\XXXXXXXXXXXXXXXXXXXXXXXXXXXx\\Desktop\\new.txt', 'r')

    write_excel(list)
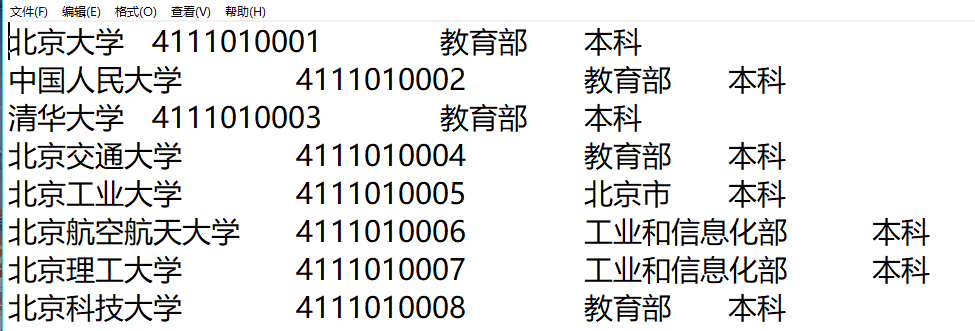
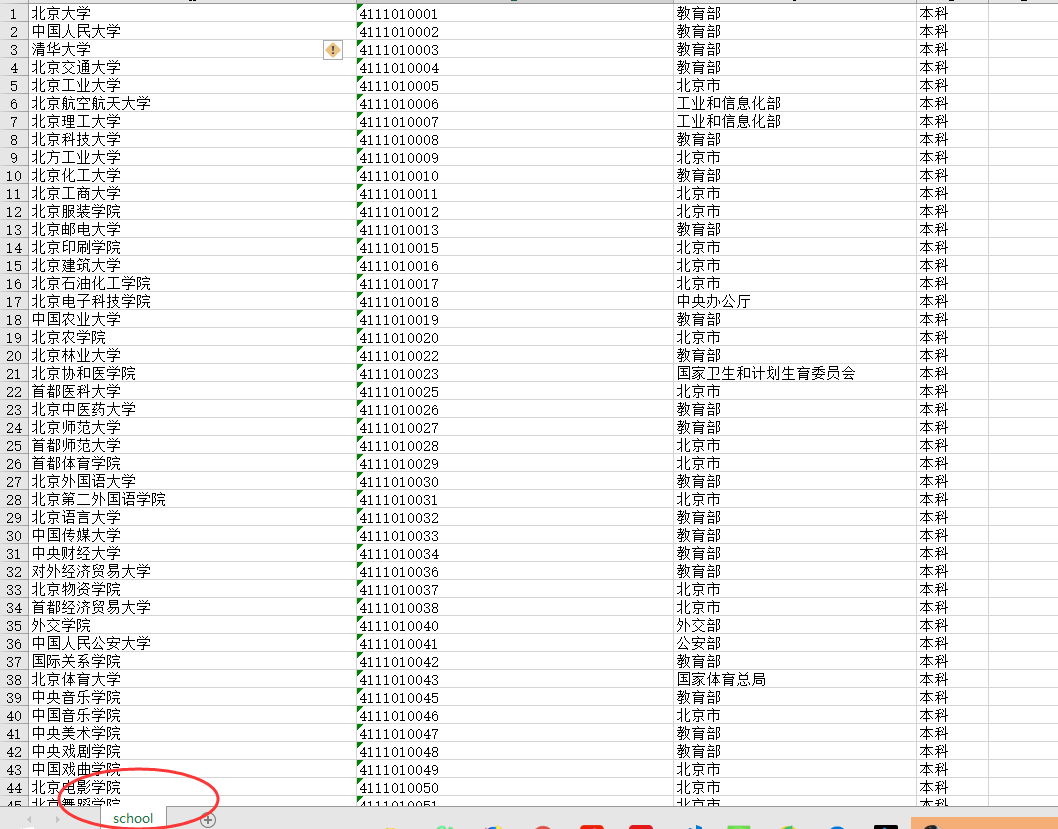
7.完成结果:
文本文件:
school.xlsx文件:
8.到这里就结束啦,因为刚接触写爬虫,所以有些地方难免写的不好,不喜勿喷啦
【现学现卖】python小爬虫的更多相关文章
- python小爬虫练手
一个人无聊,写了个小爬虫爬取不可描述图片.... 代码太短,就暂时先往这里贴一下做备份吧. 注:这是很严肃的技术研究,当然爬下来的图片我会带着批判性的眼光审查一遍的.... :) #! /usr/ ...
- Python爬虫:现学现用xpath爬取豆瓣音乐
爬虫的抓取方式有好几种,正则表达式,Lxml(xpath)与BeautifulSoup,我在网上查了一下资料,了解到三者之间的使用难度与性能 三种爬虫方式的对比. 这样一比较我我选择了Lxml(xpa ...
- 现学现卖】IntelliJ+EmmyLua 开发调试Unity中Xlua
http://blog.csdn.net/u010019717/article/details/77510066?ref=myread http://blog.csdn.NET/u010019717 ...
- 现学现卖——VS2013 C#测试
VS2013 C#测试 首先安装Unit Test Generator.方法为:工具->扩展和更新->联机->搜索“Unit Test Generator”,图标为装有蓝色液体的小试 ...
- 程序猿的日常——Mybatis现学现卖
最近有一个小项目需求,需要用spring mvc + mybatis实现一个复杂的配置系统.其中遇到了很多不太常见的问题,在这里特意记录下: 主要涉及的内容有 事务 多表删除 插入并返回主键 1 sp ...
- 现学现卖——Keil uVision 使用教程
Keil uVision 使用教程 1.如果有旧的工程在,先关闭旧工程.Project -> Close Project2.新建工程.Project -> New uVision Proj ...
- 【现学现卖】th:href标签动态路径设置,thymeleaf获取session中的属性值
update:2020-02-28:按道理来说这个功能在前后端分离的时候应该不怎么用的上,基本到现在我还是没遇到过有这样的需求,不过也是一种方法就是.th:href="@{/{role}/l ...
- Python 小爬虫流程总结
接触Python3一个月了,在此分享一下知识点,也算是温故而知新了. 接触python之前是做前端的.一直希望接触面能深一点.因工作需求开始学python,几乎做的都是爬虫..第一个demo就是爬取X ...
- Python小爬虫-自动下载三亿文库文档
新手学python,写了一个抓取网页后自动下载文档的脚本,和大家分享. 首先我们打开三亿文库下载栏目的网址,比如专业资料(IT/计算机/互联网)http://3y.uu456.com/bl-197?o ...
随机推荐
- Redis数据库 常用的基本操作
一.redis数据库操作 redis数据库默认有16个数据库[0-15],默认进入的是0库. select 数据库名 :切换数据库. keys * :查看所有的键. expire 键 秒数:设置过 ...
- java03类与对象相关问题
1.使用类的静态字段和构造函数,可以跟踪某个类所创建对象的个数.请写一个类,在任何时候都可以向他查询"你已经创建了几个对象" 1 package 第四五周; 2 3 public ...
- Spring总结之SpringMvc上
一.简介 Spring Web MVC是一种基于Java的实现了Web MVC设计模式的请求驱动类型的轻量级Web框架. 二.流程架构 1.用户发送请求至 前端控制器DispatcherServlet ...
- Kettle——简介
Kettle是一款国外开源的ETL工具,纯java编写,可以在Window.Linux.Unix上运行,数据抽取高效稳定 Kettle 的主作者是 Matt ,他在 2003 年就开始了这个项目,在 ...
- 技术期刊 · 天光台高未百尺 | Uber 工程师的 JS 算法课;大数据时代的个人隐私;设计师的 Github;告别 PPT 工程师;从零开始实现的像素画
蒲公英 · JELLY技术期刊 Vol.42 这是一个最好的时代,多样化的平台给了所有人成长发展的机会,各种需求和解决需求的人让人大开眼界:但这也并不是完美的时代,"前端还需要懂什么算法?& ...
- 【搜索】单词方阵 luogu-1101
题目描述 给一n×n的字母方阵,内可能蕴含多个"yizhong"单词.单词在方阵中是沿着同一方向连续摆放的.摆放可沿着8个方向的任一方向,同一单词摆放时不再改变方向,单词与单词之间 ...
- vue-cli 3.0脚手架创建vue项目
1. 卸载vue-cli 2.0 npm uninstall -g vue-cli 2. 安装vue-cli 3.0 npm install @vue/cli 3. 创建项目 npm create & ...
- Odoo的附件大小限制
Odoo使用binary类型来保存附件数据,可以直接支持附件数据的上传.但是在实际使用中,有可能遇到附件文件大小超过限制的情况,如下图: 但是ERP定制过程中难免会遇到客户确实需要上传超大附件,那么怎 ...
- odoo12动作里添加向导
在odoo12的 动作里添加向导例子1:只会在tree视图里显示,不会在form里显示 <act_window id="action_change_stage_ttest" ...
- 利用LRU策略实现Axios请求缓存
业务场景 前一段时间刚做完一个项目,先说一下业务场景,有别于其他的前端项目,这次的项目是直接调用第三方服务的接口,而我们的服务端只做鉴权和透传,第三方为了灵活,把接口拆的很零散,所以这个项目就像扔给你 ...