
抓包分析、多线程爬虫及xpath学习
1、抓包分析
1.1 Fiddler安装及基本操作
由于很多网站采用的是HTTPS协议,而fiddler默认不支持HTTPS,先通过设置使fiddler能抓取HTTPS网站,过程可参考(https://www.cnblogs.com/liulinghua90/p/9109282.html)。使用clear可以将当前fiddler清屏。
1.2 通过抓包爬取腾讯视频评论
unicode转码:在Python中转码可以直接输入u'需要转码的内容'
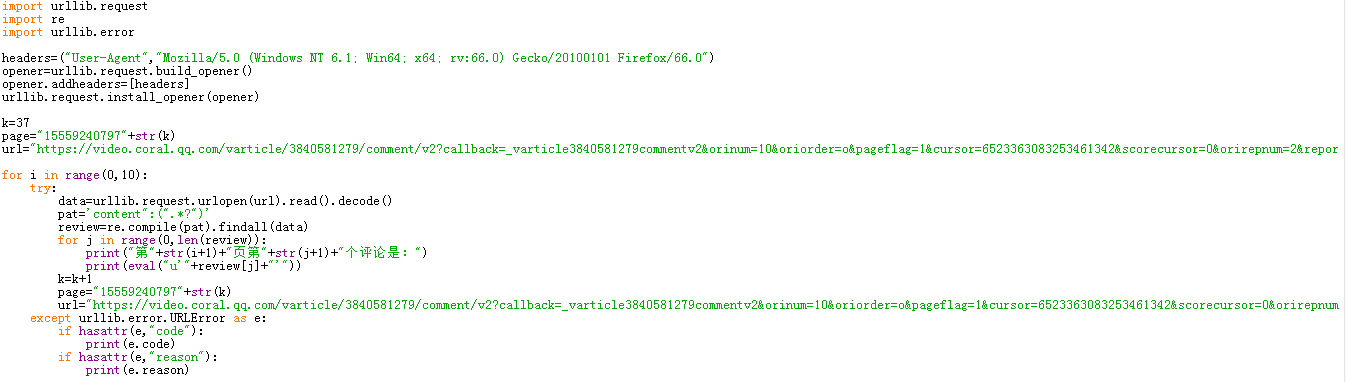
由于每个视频后面的评论需要自动加载,在源代码中未发现有关评论的相关链接,此时就需要使用fiddler进行抓包分析,打开视频网站后,可以先使用clear清屏,找到JS包,可以复制它的url,打开后发现评论都是使用的Unicode编码,此时就需要解码。由于需要自动加载后面的评论,此时需要分析网页的构成。再使用一次clear,在网页上点击加载更多评论,在fiddler中找到JS包,复制url,将之与之前的url进行对比,重复几次该操作,构造评论url。
下面给出爬取腾讯视频中权力的游戏第八季评论:
1.3 微信文章爬取
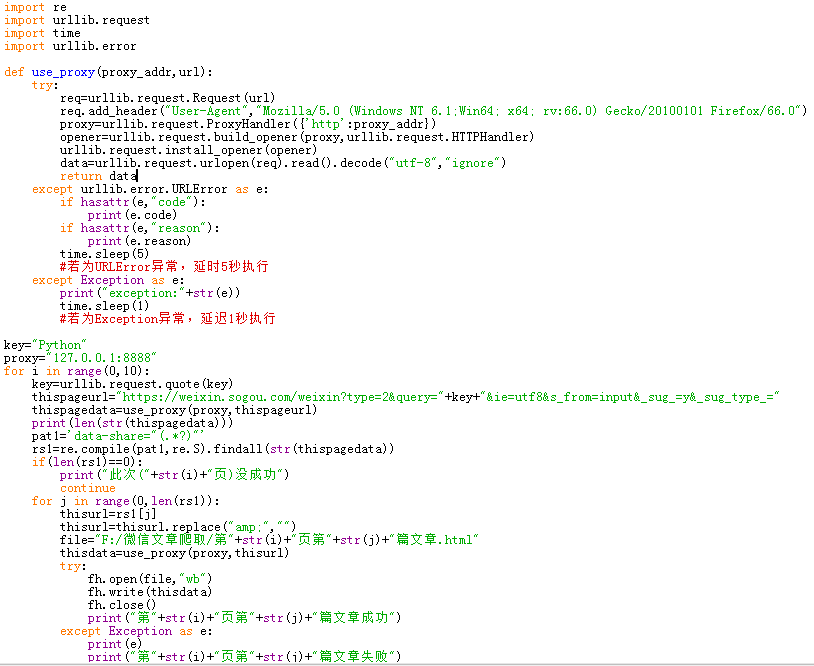
进入weixin.sougou.com,搜索关键词为“Python”,也采取抓包分析,不过增加了代理,其余操作步骤与1.2类似。
2、多线程爬虫
多线程,即程序中的某些程序段并行执行,合理地设置多线程,可以让爬虫的效率更高。
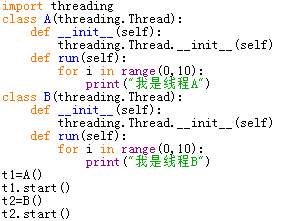
运行之后的结果为:
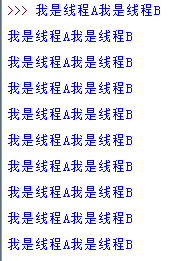
可以看出两个线程是同时开始工作的,那么如果用多线程爬取多个网页的话,就可以更加高效。下面将用多线程爬取糗事百科的文字内容:

首先需要分析网页的构造,通过翻页将规律找出来,实现在程序中实现自动翻页加载文本,其次需要将内容解码输出,最后需要加上异常处理。
3、scrapy xpath
/标签名:从顶端开始,如/html从顶端开始寻找html这个标签,找到的是这个标签内的内容
//标签名:寻找所有该标签
text():提取文本信息
@属性:提取属性信息
命令行输入:scrapy startproject 爬虫名,表示新建一个爬虫;如果新建一个自动爬虫,则先输入:scrapy startproject 爬虫名,再输入:scrapy genspider -t crawl 爬虫名 网址
items.py主要用来设置爬取的目标
pipelines.py设置后续的处理
settings.py主要用于配置信息
抓包分析、多线程爬虫及xpath学习的更多相关文章
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续一)
通过前一节得出地址可能的构建规律,如下: https://s.taobao.com/search?data-key=s&data-value=44&ajax=true&_ksT ...
- 爬虫系列(二) Chrome抓包分析
在这篇文章中,我们将尝试使用直观的网页分析工具(Chrome 开发者工具)对网页进行抓包分析,更加深入的了解网络爬虫的本质与内涵 1.测试环境 浏览器:Chrome 浏览器 浏览器版本:67.0.33 ...
- python爬虫(3)——用户和IP代理池、抓包分析、异步请求数据、腾讯视频评论爬虫
用户代理池 用户代理池就是将不同的用户代理组建成为一个池子,随后随机调用. 作用:每次访问代表使用的浏览器不一样 import urllib.request import re import rand ...
- FTP协议的粗浅学习--利用wireshark抓包分析相关tcp连接
一.为什么写这个 昨天遇到个ftp相关的问题,关于ftp匿名访问的.花费了大量的脑细胞后,终于搞定了服务端的配置,现在客户端可以像下图一样,直接在浏览器输入url,即可直接访问. 期间不会弹出输入用户 ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续二)
一.URL分析 通过对“Python机器学习”结果抓包分析,有两个无规律的参数:_ksTS和callback.通过构建如下URL可以获得目标关键词的检索结果,如下所示: https://s.taoba ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析
一.抓包基础 在淘宝上搜索“Python机器学习”之后,试图抓取书名.作者.图片.价格.地址.出版社.书店等信息,查看源码发现html-body中没有这些信息,分析脚本发现,数据存储在了g_page_ ...
- Java网络编程学习A轮_02_抓包分析TCP三次握手过程
参考资料: https://huoding.com/2013/11/21/299 https://hpbn.co/building-blocks-of-tcp/#three-way-handshake ...
- 抓包分析SSL/TLS连接建立过程【总结】
1.前言 最近在倒腾SSL方面的项目,之前只是虽然对SSL了解过,但是不够深入,正好有机会,认真学习一下.开始了解SSL的是从https开始的,自从百度支持https以后,如今全站https的趋势越来 ...
- wireshark 抓包分析 TCPIP协议的握手
wireshark 抓包分析 TCPIP协议的握手 原网址:http://www.cnblogs.com/TankXiao/archive/2012/10/10/2711777.html 之前写过一篇 ...
随机推荐
- HTTP协议12-HTTPS
1)HTTP的缺点 通信使用明文(不加密),内容可能会被窃听 不验证通信方的身份,因此有可能遭遇伪装 无法证明报文的完整性,所有有可能已被篡改 1.1 通信使用明文可能会被窃听 由于HTTP本身不具备 ...
- HDMI接口之HPD(热拔插)
HDMI (Pin 19)/DVI(Pin16)的功能是热插拔检测(HPD),这个信号将作为HDMI 源端(Source)是否发起EDID读,是否开始发送TMDS信号的依据.HPD是从HDMI显示器端 ...
- 【原创】Linux基础之上传下载
1 rz sz 安装 yum install -y lrzsz 上传 rz ,对话框操作 下载 sz $filename 注意:rz不能上传大于4g的文件,此时可以改为scp或sftp上传,其中sft ...
- 【原创】大叔经验分享(43)logstash设置jdbc_default_timezone后报错
logstash6.6.0-6.6.2版本使用jdbc input plugin时如果设置了jdbc_default_timezone,会报错: { 2012 rufus-scheduler inte ...
- 编辑技巧分享如何给PDF添加注释
纸质的文件想要添加注释就直接拿笔在上面添加就好了,那么电子文件要怎么添加注释呢,今天小编就以我们现在经常使用到的PDF文档来为大家分享怎么添加注释. 1. 我们需要在百度中搜索并下载并安装一款PD ...
- 爬虫高性能 asyncio库 twisted库 tornado库
一 背景知识 爬虫的本质就是一个socket客户端与服务端的通信过程,如果我们有多个url待爬取,只用一个线程且采用串行的方式执行,那只能等待爬取一个结束后才能继续下一个,效率会非常低. 需要强调的是 ...
- js编码解码 punyCode
;(function(w) { var PunycodeModule = function () { function IdnMapping() { this.utf16 = { decode: fu ...
- hihocoder 1496 寻找最大值
题解: 注意到$ai$只有$1e6$这件事情肯定要枚举和这个有关的东西 考虑枚举$ai\&aj$的值就可以了 那么这个集合一定是ai,aj的子集 于是我们对每个集合从大到小枚举丢掉一位转移就行 ...
- Beta(0/7)
组长重选议题 Beta阶段计划改进完善的功能 Beta阶段计划新增的功能 需要改进的团队分工 需要改进的工具流程 Beta冲刺的时间计划安排 组长重选议题 没人想当,所以没有换. Beta阶段计划改进 ...
- webpack打包样式代码去重
一.问题描述 控制台审查样式,同一个样式被导入很多遍,每调用一次@import "common.less";打包时都会多出一份类似的样式代码. 二.问题分析 补上... 三.解决方 ...