
Pandas 基础(12) - Stack 和 Unstack
这节的主题是 stack 和 unstack, 我目前还不知道专业领域是怎么翻译的, 我自己理解的意思就是"组成堆"和"解除堆". 其实, 也是对数据格式的一种转变方式, 单从字面上可能比较难理解, 所以给大家下面两张图来理解一下:

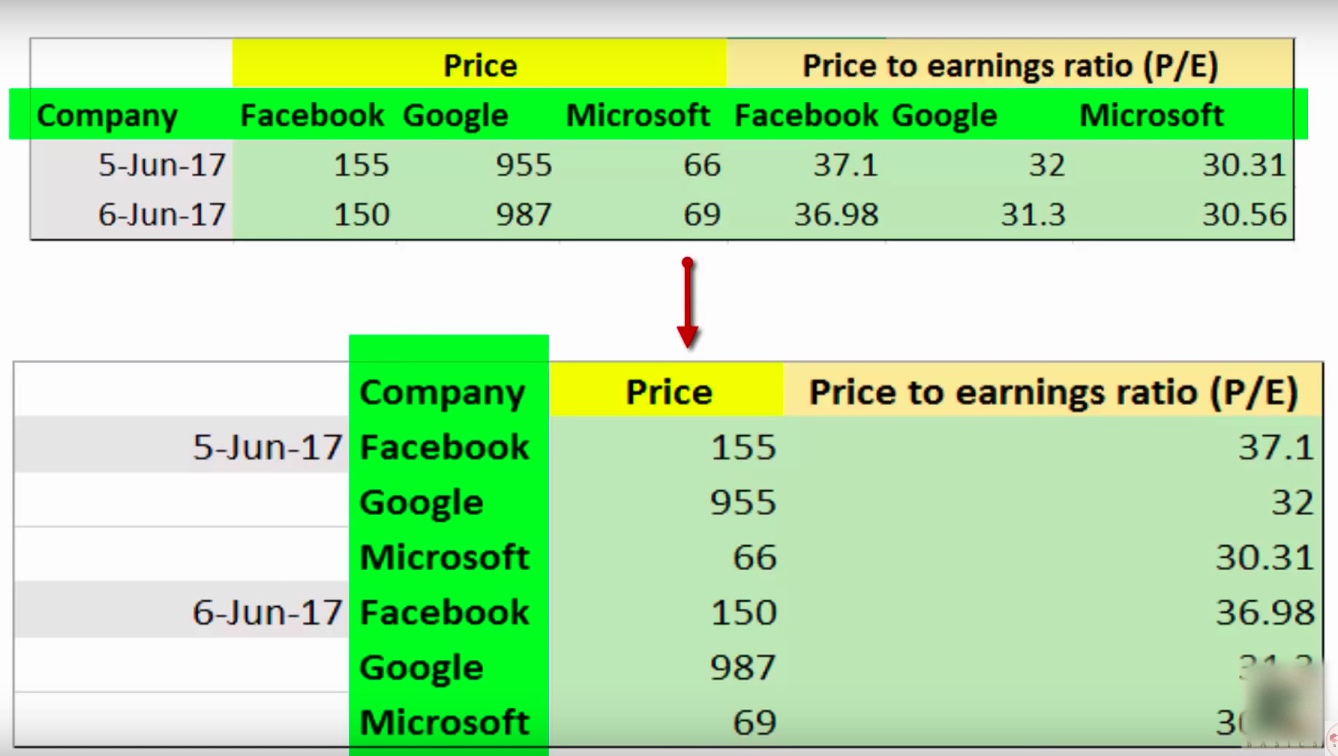
上图中, 标绿色的部分, 代表一个对应关系, 就是列的级别转为行级别.
下面来看下具体实现. 首先引入文件, 通过原表, 我们可以看到有两行表头, 所以这里要多加个参数 header=[0,1]:
df = pd.read_excel('/Users/rachel/Sites/pandas/py/pandas/12_stack/stocks.xlsx', header=[0,1])
输出: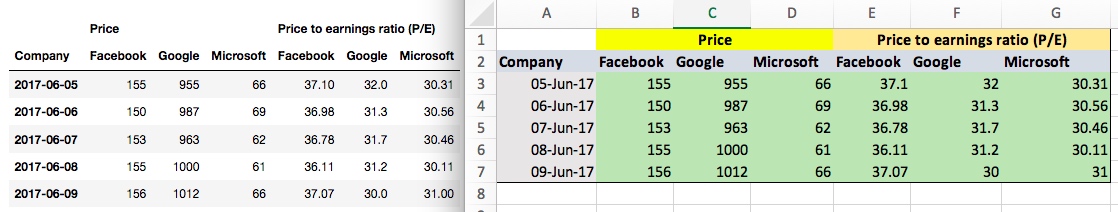
用 stack() 方法改变一下格式, 看会是什么效果:
df_stacked = df.stack()

df_stacked
从输出可以看到, 原来的数据结构是有两行表头, 经过 stack 之后, 就变成一行了, 也就是 Facebook Google Microsoft 这一行, 从原来的列名, 变成了索引: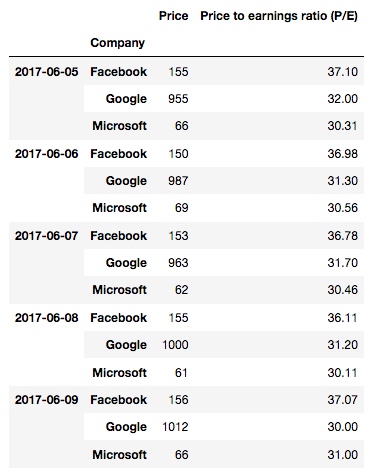
那我们现在再 unstack 看看:
df_stacked.unstack()
输出:
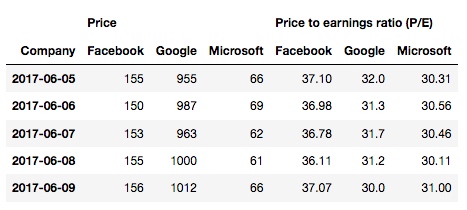
发现, unstack 之后, 整个数据结构又变回去了.
那我们现在再来重新 stack 一下, 并且加个参数 level=0, 也就是将第一行的表头堆叠成索引列:
df.stack(level=0)
输出: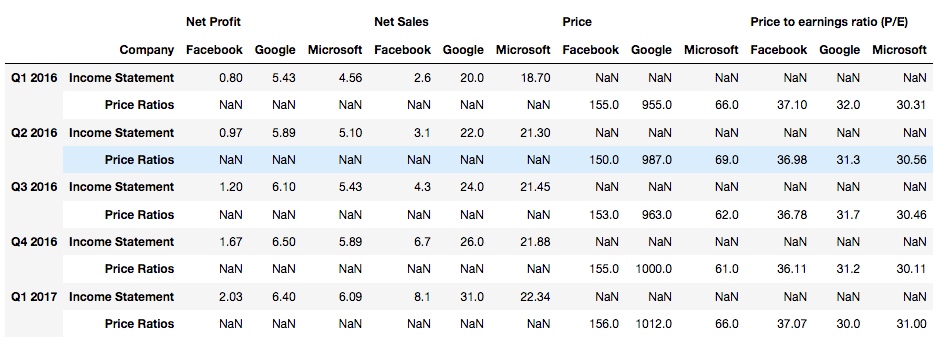
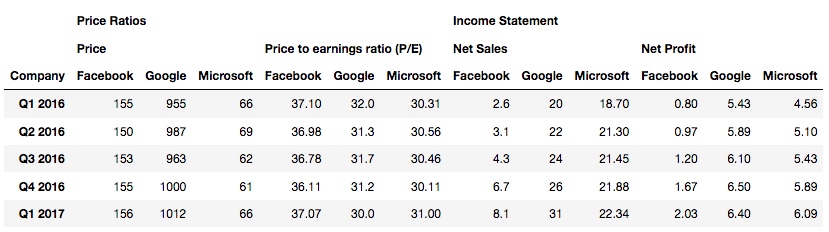
下面再来看一个更复杂点的例子, 这个表格中有三行表头:
df2 = pd.read_excel('/Users/rachel/Sites/pandas/py/pandas/12_stack/stocks_3_levels.xlsx', header=[0,1,2])
输出:
首先 stack 一下:
df2.stack()
输出, 我们看到最下面一行表头被堆叠到索引列了: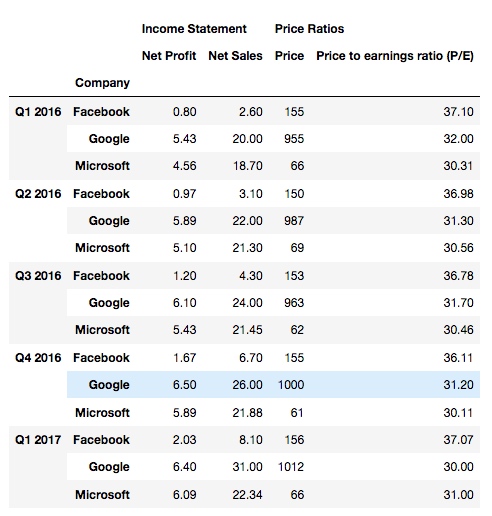
再试一下将 level 参数设为 0:
df2.stack(level=0)
发现, 第一行表头被 stack 了: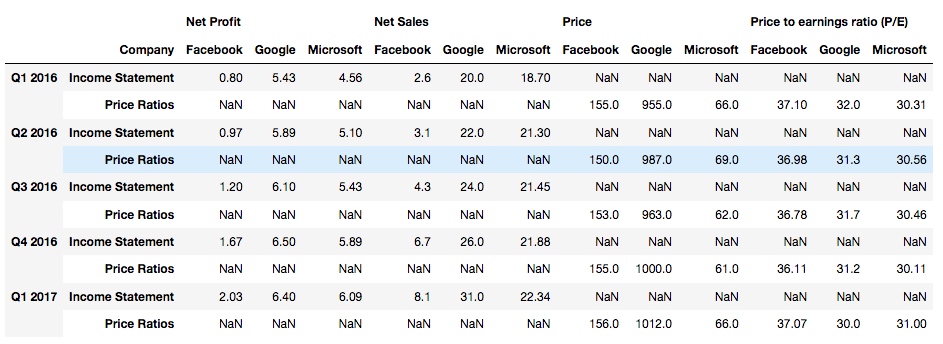
再设置 level=1:
df2.stack(level=1)
输出, 这次是第二行表头被 stack 了: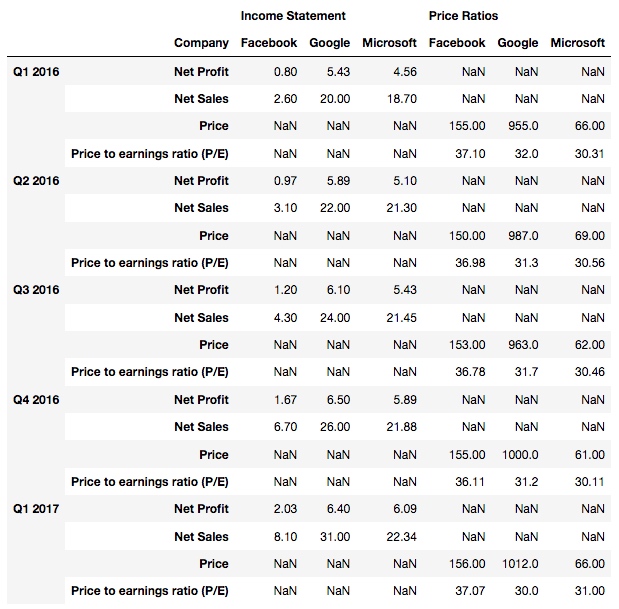
再试下设置 level=2:
df2.stack(level=2)
输出, 发现是第三行表头被 stack 了: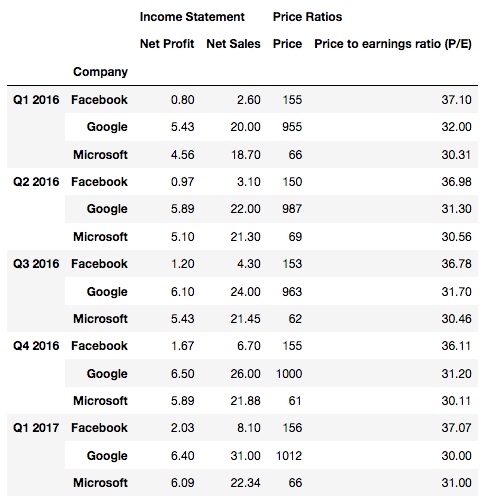
综上, 可以总结, stack 的作用就是可以将横向的表头(列名)转成纵向的索引列展示, 对于多行表头而言, 具体要转换哪一行取决于 level 参数, 如果不指定, 则默认转换最下面一行表头.
以上, 就是关于 stack 和 unstack 的基本操作了, enjoy!~~~
Pandas 基础(12) - Stack 和 Unstack的更多相关文章
- 数据重塑图解—Pivot, Pivot-Table, Stack and Unstack
Pivot pivot函数用于创建一个新的派生表,该函数有三个参数:index, columns和values.你需要在原始表中指定这三个参数所对定的列名,接下来pivot函数会创建一个新的表格,其中 ...
- python pandas stack和unstack函数
在用pandas进行数据重排时,经常用到stack和unstack两个函数.stack的意思是堆叠,堆积,unstack即"不要堆叠",我对两个函数是这样理解和区分的. 常见的数据 ...
- 利用Python进行数据分析(12) pandas基础: 数据合并
pandas 提供了三种主要方法可以对数据进行合并: pandas.merge()方法:数据库风格的合并: pandas.concat()方法:轴向连接,即沿着一条轴将多个对象堆叠到一起: 实例方法c ...
- pandas 基础操作 更新
创建一个Series,同时让pandas自动生成索引列 创建一个DataFrame数据框 查看数据 数据的简单统计 数据的排序 选择数据(类似于数据库中sql语句) 另外可以使用标签来选择 通过位置获 ...
- numpy&pandas基础
numpy基础 import numpy as np 定义array In [156]: np.ones(3) Out[156]: array([1., 1., 1.]) In [157]: np.o ...
- 利用Python进行数据分析(9) pandas基础: 汇总统计和计算
pandas 对象拥有一些常用的数学和统计方法. 例如,sum() 方法,进行列小计: sum() 方法传入 axis=1 指定为横向汇总,即行小计: idxmax() 获取最大值对应的索 ...
- 利用Python进行数据分析(8) pandas基础: Series和DataFrame的基本操作
一.reindex() 方法:重新索引 针对 Series 重新索引指的是根据index参数重新进行排序. 如果传入的索引值在数据里不存在,则不会报错,而是添加缺失值的新行. 不想用缺失值,可以用 ...
- 利用Python进行数据分析(7) pandas基础: Series和DataFrame的简单介绍
一.pandas 是什么 pandas 是基于 NumPy 的一个 Python 数据分析包,主要目的是为了数据分析.它提供了大量高级的数据结构和对数据处理的方法. pandas 有两个主要的数据结构 ...
- [.net 面向对象编程基础] (12) 面向对象三大特性——继承
[.net 面向对象编程基础] (12) 面向对象三大特性——继承 上节我们说了面向对象的三大特性之一的封装,解决了将对同一对象所能操作的所有信息放在一起,实现统一对外调用,实现了同一对象的复用,降低 ...
随机推荐
- js设计模式(五)---观察者模式
概述: 观察者模式也叫 “ 发布-订阅 " 模式 , 发布者发布信息是不需要考虑订阅者是谁?添加订阅者的时候也不需要通知发布者. 应用: 最经典的就是: DOM事件 开发过程中我们常用自定义 ...
- javascript与jquery的区别
- 在 C# 中使用文件名启动应用程序
本文演示了如何启动与某一给定文档扩展名或文件类型关联的应用程序而又无须知道该关联应用程序的名称或位置.例如,您可以用一个与 .bmp 文件扩展名关联的应用程序启动 Arcade.bmp 文件,多 ...
- 嵌入式常用技术概览之SPI
一.先决知识 (1)理解并知道移位寄存器如何工作 二.SPI概述 SPI(serial Peripheral Interface 串行片上(外围)设备接 ...
- ES6 迭代器
Iterator Iterator 是 ES6 引入的一种新的遍历机制,迭代器有两个核心概念: 迭代器是一个统一的接口,它的作用是使各种数据结构可被便捷的访问,它是通过一个键为Symbol.itera ...
- python框架之Django(5)-O/RM
字段&参数 字段与db类型的对应关系 字段 DB Type AutoField integer AUTO_INCREMENT BigAutoField bigint AUTO_INCREMEN ...
- emqtt日志、证书、集群状态等位置
1.日志 进入pod后,cd /var/log/emqttd/ 可以看到四种日志 2.证书等位置 cd /etc/emqttd 3.集群状态查询位置 任意位置 emqttd_ctl cluster s ...
- 运行pytorch代码遇到的error解决办法
1.no CUDA-capable device is detected 首先考虑的是cuda的驱动问题,查看gpu显示是否正常,然后更新最新的cuda驱动: 第二个考虑的是cuda设备的默认参数是否 ...
- tp 内置压缩文件zip
一.解压缩zip文件 $zip = new ZipArchive;//新建一个ZipArchive的对象 /* 通过ZipArchive的对象处理zip文件 $zip->open这个方法的参数表 ...
- Unity中实现人物平滑转身
using UnityEngine; public class PlayerController : MonoBehaviour { ; ; ; void Update() { hor = Input ...