
Hadoop的概念、版本、发展史
Hadoop是什么?
Hadoop: 适合大数据的分布式存储和计算平台
Hadoop不是指具体一个框架或者组件,它是Apache软件基金会下用Java语言开发的一个开源分布式计算平台。实现在大量计算机组成的集群中对海量数据进行分布式计算。适合大数据的分布式存储和计算平台。
Hadoop1.x中包括两个核心组件:MapReduce和Hadoop Distributed File System(HDFS)
其中HDFS负责将海量数据进行分布式存储,而MapReduce负责提供对数据的计算结果的汇总
Hadoop的起源
2003-2004年,Google公布了部分GFS和MapReduce思想的细节,受此启发的Doug Cutting等人用2年的业余时间实现了DFS和MapReduce机制,使Nutch性能飙升。然后Yahoo招安Doug Gutting及其项目。
2005年,Hadoop作为Lucene的子项目Nutch的一部分正式引入Apache基金会。
2006年2月被分离出来,成为一套完整独立的软件,起名为Hadoop
Hadoop名字不是一个缩写,而是一个生造出来的词。是Hadoop之父Doug Cutting儿子毛绒玩具象命名的。
Hadoop的成长过程
Lucene–>Nutch—>Hadoop
总结起来,Hadoop起源于Google的三大论文
GFS:Google的分布式文件系统Google File System
MapReduce:Google的MapReduce开源分布式并行计算框架
BigTable:一个大型的分布式数据库
演变关系
GFS—->HDFS
Google MapReduce—->Hadoop MapReduce
BigTable—->HBase
Hadoop发展史
Hadoop大事记
2004年— 最初的版本(现在称为HDFS和MapReduce)由Doug Cutting和Mike Cafarella开始实施。
2005年12月— Nutch移植到新的框架,Hadoop在20个节点上稳定运行。
2006年1月— Doug Cutting加入雅虎。
2006年2月— Apache Hadoop项目正式启动以支持MapReduce和HDFS的独立发展。
2006年2月— 雅虎的网格计算团队采用Hadoop。
2006年4月— 标准排序(10 GB每个节点)在188个节点上运行47.9个小时。
2006年5月— 雅虎建立了一个300个节点的Hadoop研究集群。
2006年5月— 标准排序在500个节点上运行42个小时(硬件配置比4月的更好)。
2006年11月— 研究集群增加到600个节点。
2006年12月— 标准排序在20个节点上运行1.8个小时,100个节点3.3小时,500个节点5.2小时,900个节点7.8个小时。
2007年1月— 研究集群到达900个节点。
2007年4月— 研究集群达到两个1000个节点的集群。
2008年4月— 赢得世界最快1TB数据排序在900个节点上用时209秒。
2008年7月— 雅虎测试节点增加到4000个
2008年9月— Hive成为Hadoop的子项目
2008年11月— Google宣布其MapReduce用68秒对1TB的程序进行排序
2008年10月— 研究集群每天装载10TB的数据。
2008年— 淘宝开始投入研究基于Hadoop的系统–云梯。云梯总容量约9.3PB,共有1100台机器,每天处理18000道作业,扫描500TB数据。
2009年3月— 17个集群总共24 000台机器。
2009年3月— Cloudera推出CDH(Cloudera’s Dsitribution Including Apache Hadoop)
2009年4月— 赢得每分钟排序,雅虎59秒内排序500 GB(在1400个节点上)和173分钟内排序100 TB数据(在3400个节点上)。
2009年5月— Yahoo的团队使用Hadoop对1 TB的数据进行排序只花了62秒时间。
2009年7月— Hadoop Core项目更名为Hadoop Common;
2009年7月— MapReduce 和 Hadoop Distributed File System (HDFS) 成为Hadoop项目的独立子项目。
2009年7月— Avro 和 Chukwa 成为Hadoop新的子项目。
2009年9月— 亚联BI团队开始跟踪研究Hadoop
2009年12月—亚联提出橘云战略,开始研究Hadoop
2010年5月— Avro脱离Hadoop项目,成为Apache顶级项目。
2010年5月— HBase脱离Hadoop项目,成为Apache顶级项目。
2010年5月— IBM提供了基于Hadoop 的大数据分析软件——InfoSphere BigInsights,包括基础版和企业版。
2010年9月— Hive( Facebook) 脱离Hadoop,成为Apache顶级项目。
2010年9月— Pig脱离Hadoop,成为Apache顶级项目。
2011年1月— ZooKeeper 脱离Hadoop,成为Apache顶级项目。
2011年3月— Apache Hadoop获得Media Guardian Innovation Awards 。
2011年3月— Platform Computing 宣布在它的Symphony软件中支持Hadoop MapReduce API。
2011年5月— Mapr Technologies公司推出分布式文件系统和MapReduce引擎——MapR Distribution for Apache Hadoop。
2011年5月— HCatalog 1.0发布。该项目由Hortonworks 在2010年3月份提出,HCatalog主要用于解决数据存储、元数据的问题,主要解决HDFS的瓶颈,它提供了一个地方来存储数据的状态信息,这使得 数据清理和归档工具可以很容易的进行处理。
2011年4月— SGI( Silicon Graphics International )基于SGI Rackable和CloudRack服务器产品线提供Hadoop优化的解决方案。
2011年5月— EMC为客户推出一种新的基于开源Hadoop解决方案的数据中心设备——GreenPlum HD,以助其满足客户日益增长的数据分析需求并加快利用开源数据分析软件。Greenplum是EMC在2010年7月收购的一家开源数据仓库公司。
2011年5月— 在收购了Engenio之后, NetApp推出与Hadoop应用结合的产品E5400存储系统。
2011年6月— Calxeda公司(之前公司的名字是Smooth-Stone)发起了“开拓者行动”,一个由10家软件公司组成的团队将为基于Calxeda即将推出的ARM系统上芯片设计的服务器提供支持。并为Hadoop提供低功耗服务器技术。
2011年6月— 数据集成供应商Informatica发布了其旗舰产品,产品设计初衷是处理当今事务和社会媒体所产生的海量数据,同时支持Hadoop。
2011年7月— Yahoo!和硅谷风险投资公司 Benchmark Capital创建了Hortonworks 公司,旨在让Hadoop更加鲁棒(可靠),并让企业用户更容易安装、管理和使用Hadoop。
2011年8月— Cloudera公布了一项有益于合作伙伴生态系统的计划——创建一个生态系统,以便硬件供应商、软件供应商以及系统集成商可以一起探索如何使用Hadoop更好的洞察数据。
2011年8月— Dell与Cloudera联合推出Hadoop解决方案——Cloudera Enterprise。Cloudera Enterprise基于Dell PowerEdge C2100机架服务器以及Dell PowerConnect 6248以太网交换机
Hadoop的四大特性(优点)
- 扩容能力(Scalable):Hadoop是在可用的计算机集群间分配数据并完成计算任务的,这些集群可用方便的扩展到数以千计个节点中。
- 成本低(Economical):Hadoop通过普通廉价的机器组成服务器集群来分发以及处理数据,以至于成本很低。
- 高效率(Efficient):通过并发数据,Hadoop可以在节点之间动态并行的移动数据,使得速度非常快。
- 可靠性(Rellable):能自动维护数据的多份复制,并且在任务失败后能自动地重新部署(redeploy)计算任务。所以Hadoop的按位存储和处理数据的能力值得人们信赖。
Hadoop的版本
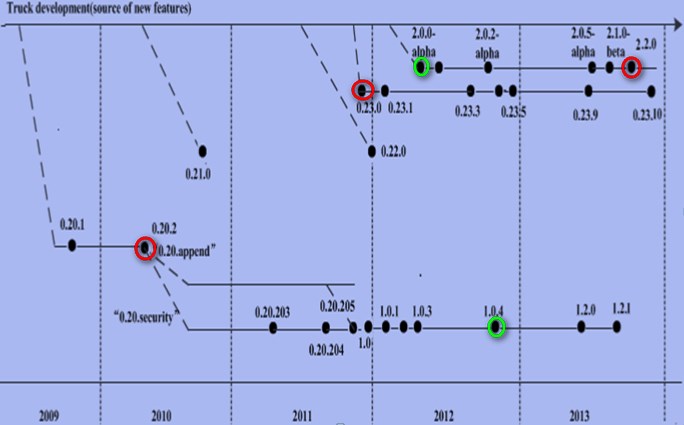
Hadoop的版本很特殊,是由多条分支并行的发展着。
1.x:该版本是由0.20.x发行版系列的延续
2.x:该版本是由0.23.x发行版系列的延续
其实Hadoop也就两个版本1.x和2.x
Hadoop1.x 指的是:1.x(0.20.x)、0.21、0.22
Hadoop2.x 指的是:2.x、0.23.x
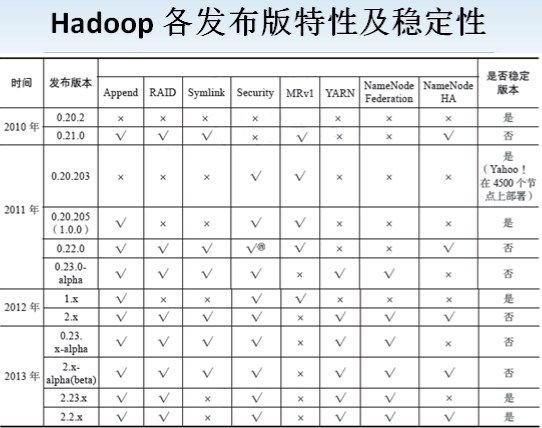
注意:高版本不一定包含低版本的特性
董的博客中也解释了各个版本的问题:
Hadoop版本选择探讨
Hadoop 2.0中的基本术语解释
Hadoop版本演变图
红色:表示企业中用的最多的实际生产版本
绿色:表示企业中用的最多的alpha版本
如何选择Hadoop版本
当前Hadoop版本比较混乱,让很多用户不知所措。实际上,当前Hadoop只有两个版本:Hadoop 1.0和Hadoop 2.0,其中,Hadoop 1.0由一个分布式文件系统HDFS和一个离线计算框架MapReduce组成,而Hadoop 2.0则包含一个支持NameNode横向扩展的HDFS,一个资源管理系统YARN和一个运行在YARN上的离线计算框架MapReduce。相比于Hadoop 1.0,Hadoop 2.0功能更加强大,且具有更好的扩展性、性能,并支持多种计算框架。
当我们决定是否采用某个软件用于开源环境时,通常需要考虑以下几个因素:
- 是否为开源软件,即是否免费。
- 是否有稳定版,这个一般软件官方网站会给出说明。
- 是否经实践验证,这个可通过检查是否有一些大点的公司已经在生产环境中使用知道。
- 是否有强大的社区支持,当出现一个问题时,能够通过社区、论坛等网络资源快速获取解决方法。
摘自董的博客
Hadoop的概念、版本、发展史的更多相关文章
- 大数据及hadoop简要概念
大数据 大数据简要概念 指无法在一定时间范围内用常规软件工具进行捕捉.管理和处理的数据集合.需要新处理模式,才能具有更强的决策力.洞察发现力和流程优化能力的海量.高增长率和多样化的信息资产. 大数据作 ...
- hadoop的概念
hadoop的概念 网上会经常遇到各种hadoop的概念,Hive,HBase,Hdfs都各是什么呢? 首先从hdfs说起,hdfs是分布式文件系统,它把集群当作单机一样做文件操作,文件可能存在于多个 ...
- Hadoop 2.x 版本的单机模式安装
Hadoop 2.x 版本比起之前的版本在Hadoop和MapReduce上做了许多变化,主要的变化之一,是JobTracker被ResourceManager和ApplicationManager所 ...
- hadoop分布式存储(1)-hadoop基础概念(毕业设计)
hadoop是一种用于海量数据存储.管理.分析的分布式系统.需要hadoop需要储备一定的基础知识:1.掌握一定的linux操作命令 2.会java编程.因此hadoop必须安装在有jdk的linux ...
- Hadoop基本概念
一个分布式系统基础架构,由Apache基金会开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序.充分利用集群的威力高速运算和存储.Hadoop实现了一个分布式文件系统(Hadoop Dist ...
- 大数据 - hadoop基础概念 - HDFS
Hadoop之HDFS的概念及用法 1.概念介绍 Hadoop是Apache旗下的一个项目.他由HDFS.MapReduce.Hive.HBase和ZooKeeper等成员组成. HDFS是一个高度容 ...
- hadoop 核心概念及入门
Hadoop Hadoop背景 什么是HADOOP HADOOP是apache旗下的一套开源软件平台HADOOP提供利用服务器集群,根据用户的自定义业务逻辑,对海量数据进行分布式处理,HADOOP的核 ...
- Hadoop 基本概念
一.Hadoop 简介 Hadoop 是一个由 Apache 基金会所开发的分布式系统基础架构,它可以使用户在不了解分布式底层细节的情況下开发分布式程序,充分利用集群的威力进行高速运算和存储. 从其定 ...
- hadoop分布式存储(1)-hadoop基础概念
hadoop是一种用于海量数据存储.管理.分析的分布式系统.需要hadoop需要储备一定的基础知识:1.掌握一定的linux操作命令 2.会java编程.因此hadoop必须安装在有jdk的linux ...
随机推荐
- conda 管理 python 版本
conda常用命令 查看当前系统下的环境 conda info -e 创建新的环境 # 指定python版本为2.7 conda create -n env_name python=2.7 # 同时安 ...
- centos LAMP第二部分apache配置 下载discuz!配置第一个虚拟主机 安装Discuz! 用户认证 配置域名跳转 配置apache的访问日志 配置静态文件缓存 配置防盗链 访问控制 apache rewrite 配置开机启动apache tcpdump 第二十节课
centos LAMP第二部分apache配置 下载discuz!配置第一个虚拟主机 安装Discuz! 用户认证 配置域名跳转 配置apache的访问日志 配置静态文件缓存 配置防盗链 ...
- Java压缩多个文件并导出
controller层: /** * 打包压缩下载文件 */ @RequestMapping(value = "/downLoadZipFile") public void dow ...
- 菜单和按钮-EasyUI Menu 菜单、EasyUI Linkbutton 链接按钮、EasyUI Menubutton 菜单按钮、EasyUI Splitbutton 分割按钮
EasyUI Menu 菜单 通过 $.fn.menu.defaults 重写默认的 defaults. 菜单(Menu)通常用于上下文菜单.它是创建其他菜单组件(比如:menubutton.spli ...
- Office 2003 2007 2010 配置进度 正在配置 解决方案 (转载)
在安装过Office2003.2007 或者2010之后,如果没有选择全部的组件,或者是因为安装到非系统盘,有时候打开 Office 文档的时候就会出现正在配置Office,或者Office配置进度的 ...
- Python Web开发之路
Flask相关 1.DBUtils数据库连接池 2.Flask之初体验 3.Flask之WTForms 4.Flask之信号 5.Flask之flask-session 6.Flask之flask-s ...
- eclipse中gradle插件安装
help===>install software===>http://download.eclipse.org/buildship/updates/e46/releases/2.x/
- showDoc的基本使用方法
ShowDoc介绍 ShowDoc就是一个非常适合IT团队的在线文档分享工具,它可以加快团队之间沟通的效率. API文档( 查看Demo) 随着移动互联网的发展,BaaS(后端即服务)越来越流行.服务 ...
- EL表达式判断条件要写在${}内
由于老没开发框架了,今天提取公共省市县三级联动组件时,使用jsp传参搞了半天才弄出来. 组件代码 $(function(){console.log("${param.init}") ...
- 20145315 《Java程序设计》第九周学习总结
20145315 <Java程序设计>第九周学习总结 教材学习内容总结 第16章--整合数据库 16.1.1JDBC简介 应用程序通过通信协议对数据库进行指令交换,以进行对数据的的增删查找 ...