
使用webmagic搭建一个简单的爬虫
刚刚接触爬虫,听说webmagic很不错,于是就了解了一下。
webmagic的是一个无须配置、便于二次开发的爬虫框架,它提供简单灵活的API,只需少量代码即可实现一个爬虫。
这句话说的真的一点都不假,像我这样什么都不懂的人直接下载部署,看了看可以调用的方法,马上就写出了第一个爬虫小程序。
以下是我学习的过程:
首先需要下载jar:http://webmagic.io/download.html
部署好后就建一个class继承PageProcessor接口,重写process()方法,即可完成一个爬虫。
是不是很简单?
先上代码,再讲解吧。
import us.codecraft.webmagic.Page;

import us.codecraft.webmagic.Site;

import us.codecraft.webmagic.Spider;

import us.codecraft.webmagic.processor.PageProcessor;

public class MyProcessor implements PageProcessor {

	// 抓取网站的相关配置,包括编码、抓取间隔、重试次数等

	private Site site = Site.me().setRetryTimes(3).setSleepTime(100);

    private static int count =0;

	@Override

	public Site getSite() {

		return site;

	}

	@Override

	public void process(Page page) {

        //判断链接是否符合http://www.cnblogs.com/任意个数字字母-/p/7个数字.html格式

		if(!page.getUrl().regex("http://www.cnblogs.com/[a-z 0-9 -]+/p/[0-9]{7}.html").match()){

			//加入满足条件的链接

			page.addTargetRequests(

					page.getHtml().xpath("//*[@id=\"post_list\"]/div/div[@class='post_item_body']/h3/a/@href").all());

		}else{

			//获取页面需要的内容

			System.out.println("抓取的内容:"+

					page.getHtml().xpath("//*[@id=\"Header1_HeaderTitle\"]/text()").get()

					);

			count ++;

		}

	}

	public static void main(String[] args) {

		long startTime, endTime;

		System.out.println("开始爬取...");

        startTime = System.currentTimeMillis();

		Spider.create(new MyProcessor()).addUrl("https://www.cnblogs.com/").thread(5).run();

		endTime = System.currentTimeMillis();

		System.out.println("爬取结束,耗时约" + ((endTime - startTime) / 1000) + "秒,抓取了"+count+"条记录");

	}

}
由于刚开始学,技术有限,所以简单地爬一下这些文章的作者。
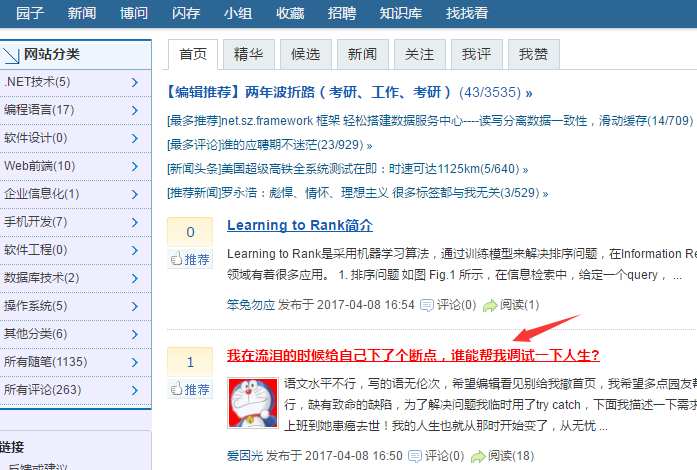
要爬取,首先得知道内容在哪个位置上。在chrome下审查一下元素发现,文章都在这里
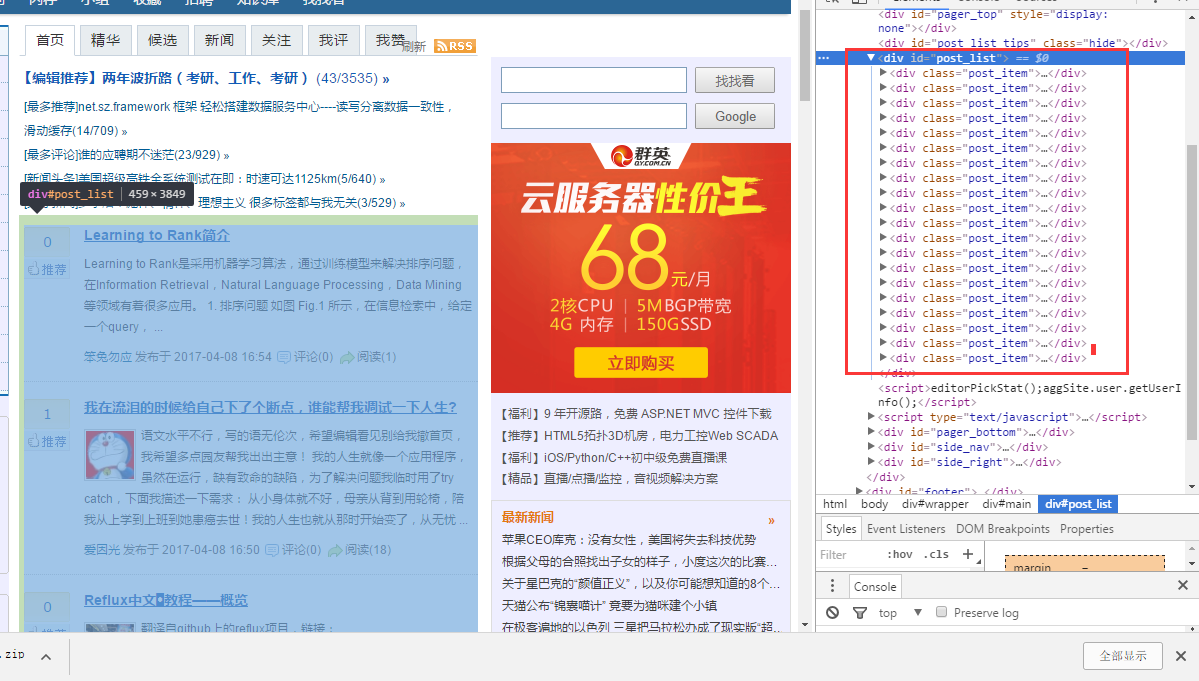
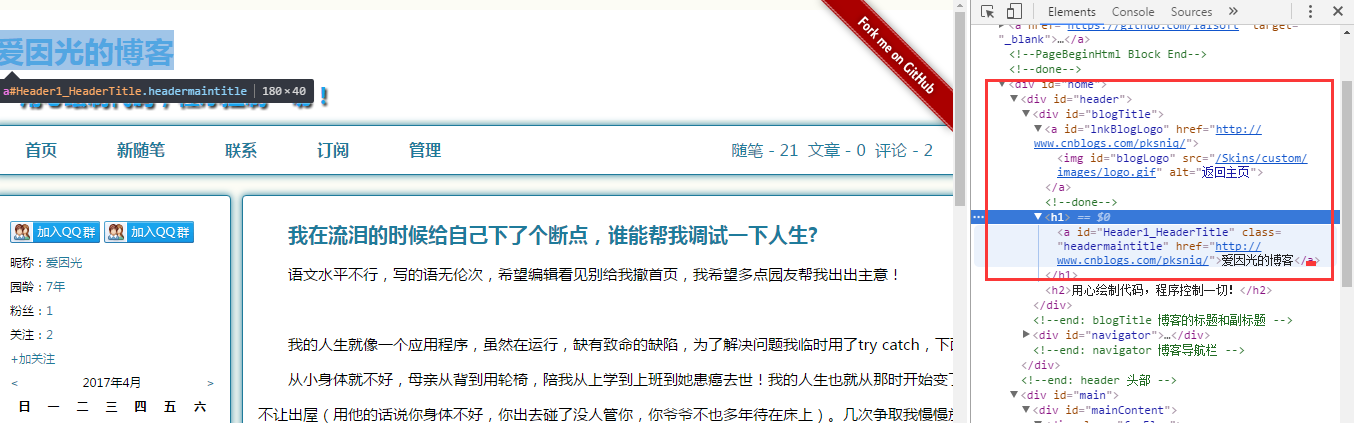
点进文章后审查元素发现作者的名字在这里
知道要爬的内容在哪个位置之后。我们还需要知道怎样才能拿到这些数据。
这里说一下webmagic的内容
启动爬虫就这句:Spider.create(new MyProcessor()).addUrl("https://www.cnblogs.com/").thread(5).run();//addUrl就是种子url
Page对象就是当前获取的页面,
getUrl()可以获得当前url,
addTargetRequests()就是把链接放入等待爬取
getHtml()获得页面的html元素
上面这些很容易就能知道它的意思,不懂得是xpath();
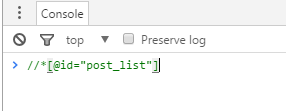
刚开始学,我也不懂,但是chrome懂,所以可以让它帮我们写好xpath。
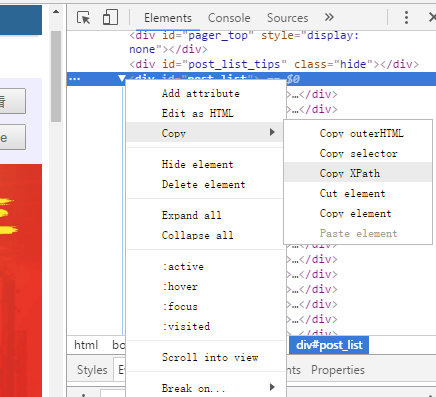
审查元素下,选择要需要的部分右键Copy,选择Copy XPath,然后在console下粘贴
关于xpath的教程可以查看https://www.one-tab.com/page/JFPOsHyvQUOQlzZwahc6-Q
关于webmagic的可以查看http://webmagic.io/docs/zh/posts/ch1-overview/
使用webmagic搭建一个简单的爬虫的更多相关文章
- 【转】使用webmagic搭建一个简单的爬虫
[转]使用webmagic搭建一个简单的爬虫 刚刚接触爬虫,听说webmagic很不错,于是就了解了一下. webmagic的是一个无须配置.便于二次开发的爬虫框架,它提供简单灵活的API,只需少量代 ...
- 用nodejs搭建一个简单的服务器
使用nodejs搭建一个简单的服务器 nodejs优点:性能高(读写文件) 数据操作能力强 官网:www.nodejs.org 验证是否安装成功:cmd命令行中输入node -v 如果显示版本号表示安 ...
- 初学Node(六)搭建一个简单的服务器
搭建一个简单的服务器 通过下面的代码可以搭建一个简单的服务器: var http = require("http"); http.createServer(function(req ...
- python (1)一个简单的爬虫: python 在windows下 创建文件夹并写入文件
1.一个简单的爬虫:爬取豆瓣的热门电影的信息 写在前面:如何创建本来存在的文件夹并写入 t_path = "d:/py/inn" #本来不存在inn,先定义路径,然后如果不存在,则 ...
- 【netty】(2)---搭建一个简单服务器
netty(2)---搭建一个简单服务器 说明:本篇博客是基于学习慕课网有关视频教学.效果:当用户访问:localhost:8088 后 服务器返回 "hello netty"; ...
- 使用gitblit搭建一个简单的局域网服务器
使用gitblit搭建一个简单的局域网服务器 1.使用背景 现在很多使用github管理代码,但是github需要互联网的支持,而且私有的git库需要收费.有一些项目的代码不能外泄,所以,搭建一个局域 ...
- Golang学习-第二篇 搭建一个简单的Go Web服务器
序言 由于本人一直从事Web服务器端的程序开发,所以在学习Golang也想从Web这里开始学起,如果对Golang还不太清楚怎么搭建环境的朋友们可以参考我的上一篇文章 Golang的简单介绍及Wind ...
- Python并发编程-一个简单的爬虫
一个简单的爬虫 #网页状态码 #200 正常 #404 网页找不到 #502 504 import requests from multiprocessing import Pool def get( ...
- python爬虫系列(1)——一个简单的爬虫实例
本文主要实现一个简单的爬虫,目的是从一个百度贴吧页面下载图片. 1. 概述 本文主要实现一个简单的爬虫,目的是从一个百度贴吧页面下载图片.下载图片的步骤如下: 获取网页html文本内容:分析html中 ...
随机推荐
- 第二百八十六节,MySQL数据库-MySQL事务操作(回滚)
MySQL数据库-MySQL事务操作(回滚) 事务用于将某些操作的多个SQL作为原子性操作,一旦有某一个出现错误,即可回滚到原来的状态,从而保证数据库数据完整性. 举例:有这样一张表 从表里可以看出张 ...
- PhoneGap开发不可或缺的五件装备
PhoneGap是一种介于WebApp和NativeApp之间的解决方案,它为每种移动客户端提供一个Native的壳,这种壳里边包着一个Web应 用.借助于壳,Web应用可以被安装,可以被发布到各大市 ...
- 解决myeclipse4.1.1对一个表生成映射文件的时候,出现“generating artifacts"的解决!
很多人在用myeclipse4.1.1对一个表生成映射文件的时候,都出现“generating artifacts"的问题.我也遇到了这个问题,弄得我也很郁闷!看了很多人的帖子后还是无法搞定 ...
- select2 选择框插件
<select id="selBusi_type"><select> //初始化业务类型下拉 var initBusiTypeSel = function( ...
- 对于jsp中编码的理解
1.会话都是从客户端也就是浏览器开始发起的,首先用户将地址输入到地址栏中, 当用户输入enter或者点击转到的按钮时,浏览器会根据当前页面的charset对地址栏中的地址进行encode一次,当服务器 ...
- Java中的各种加密算法
Java中为我们提供了丰富的加密技术,可以基本的分为单向加密和非对称加密 1.单向加密算法 单向加密算法主要用来验证数据传输的过程中,是否被篡改过. BASE64 严格地说,属于编码格式,而非加密算法 ...
- NHibernate初学五之关联一对多关系
1:创建两张表T_Country.T_Person:其中T_Person表中有一个CountryID对应T_Country的ID,一个Country可以对应多个Person CREATE TABLE ...
- 单选按钮选中指定value值
$("input[name='BlogStatus'][value='" + rep.data.Status + "']").prop("checke ...
- Don‘t talk.Just do it.
对于算法,自己掌握的还是不多.并且我发现对于一个算法的理解非常重要.也许你会发现你貌似会用某总算法但是,他一旦变形,自己就无从下手. 还有就是对于算法.最好每次都自己敲,这样不仅能添加对于算法的熟度. ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析
一.抓包基础 在淘宝上搜索“Python机器学习”之后,试图抓取书名.作者.图片.价格.地址.出版社.书店等信息,查看源码发现html-body中没有这些信息,分析脚本发现,数据存储在了g_page_ ...