
SQL Server-聚焦计算列或计算列持久化查询性能(二十二)
前言
上一节我们详细讲解了计算列以及计算列持久化的问题,本节我们依然如前面讲解来看看二者查询性能问题,简短的内容,深入的理解,Always to review the basics。
持久化计算列比非持久化计算列性能要好
我们开始创建两个一样的表并都插入条数据来进行比较,对于计算列我们重新进行创建计算列和非计算列持久化。
CREATE TABLE [dbo].[ComputeColumnCompare] (ID INT,

FirstName VARCHAR(),

LastName CHAR())

GO
INSERT INTO [dbo].[ComputeColumnCompare] (ID,FirstName,LastName)

SELECT TOP   ROW_NUMBER() OVER (ORDER BY a.name) RowID,

'Bob',

CASE WHEN ROW_NUMBER() OVER (ORDER BY a.name)% =  THEN 'Smith'

ELSE 'Brown' END

FROM sys.all_objects a

CROSS JOIN sys.all_objects b

GO
在ComputeColumn表上创建计算列
USE TSQL2012

GO

ALTER TABLE dbo.ComputeColumn ADD

FullName AS POWER(LEN(LEFT((FirstName+CAST(ID AS VARCHAR())),)), )

GO
在ComputeColumnCompare表上创建计算持久化列
USE TSQL2012

GO

ALTER TABLE dbo.ComputeColumnCompare ADD

FullName_P AS POWER(LEN(LEFT((FirstName+CAST(ID AS VARCHAR())),)), ) PERSISTED

GO
此时我们来运行两个表对计算列和计算列持久化列的查询
USE TSQL2012

GO

SELECT FullName

FROM dbo.ComputeColumn

WHERE FullName =

GO

SELECT FullName_P

FROM dbo.ComputeColumnCompare

WHERE FullName_P =

GO
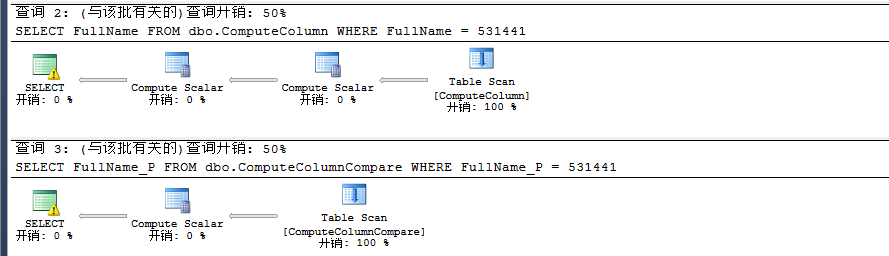
此时二者的开销是一样的,只是非持久化列多了一个Compute Scalar操作,主要是因为它计算值是在运行时,此时我们来看看操作成本。
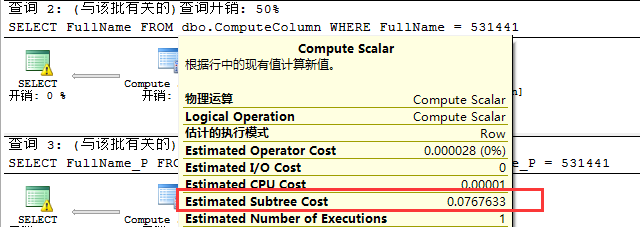

我们看到二者性能还是有一点差异,所以我们能够知道如果计算操作比较复杂时利用持久化来提前进行计算性能会比非持久化列更好。是不是所有情况下持久化列性能都比持久化列性能要好呢?继续往下看。
非持久化计算列比持久化计算列性能要好
我们再来创建测试表并插入1万条数据来进行比较。
USE TSQL2012

GO

CREATE TABLE [dbo].[ComputeColumn] (ID INT,

FirstName VARCHAR(),

LastName CHAR())

GO

CREATE TABLE [dbo].[ComputeColumnCompare](ID INT,

FirstName VARCHAR(),

LastName CHAR())

GO
USE TSQL2012

GO

INSERT INTO  [dbo].[ComputeColumn](ID,FirstName,LastName)

SELECT TOP  ROW_NUMBER() OVER (ORDER BY a.name) RowID,

'Bob',

CASE WHEN ROW_NUMBER() OVER (ORDER BY a.name)% =  THEN 'Smith'

ELSE 'Brown' END

FROM sys.all_objects a

CROSS JOIN sys.all_objects b

GO

INSERT INTO [dbo].[ComputeColumnCompare](ID,FirstName,LastName)

SELECT TOP  ROW_NUMBER() OVER (ORDER BY a.name) RowID,

'Bob',

CASE WHEN ROW_NUMBER() OVER (ORDER BY a.name)% =  THEN 'Smith'

ELSE 'Brown' END

FROM sys.all_objects a

CROSS JOIN sys.all_objects b

GO
接下来在两表上创建持久化计算列和非持久化计算列
USE TSQL2012

GO

ALTER TABLE dbo.ComputeColumn ADD

FullName AS (FirstName+' '+LastName)

GO

ALTER TABLE dbo.ComputeColumnCompare ADD

FullName_P AS (FirstName+' '+LastName) PERSISTED

GO
最后我们进行查询看看查询计划结果
USE TSQL2012

GO

SELECT FullName

FROM dbo.ComputeColumn

WHERE FullName = 'Bob Smith'

GO

SELECT FullName_P

FROM dbo.ComputeColumnCompare

WHERE FullName_P = 'Bob Smith'

GO

到这里我们发现非持久化计算列性能要比持久化计算列性能要好,和上面对照的话我已经明确进行了标记定义列的大小以及插入行的多少是不同的,所以对于持久化列和非持久化列二者并没有绝对性能的谁好谁好,当我们想要看二者谁性能更佳时,我们可能需要考虑定义列的大小、数据行的多少等等。下面我们还看最后一种情况,就是在计算列上来创建索引。
非持久化计算列提高查询性能
我们继续创建测试表
USE TSQL2012

GO

CREATE TABLE [dbo].[ComputeColumn] (ID INT,

FirstName VARCHAR(),

LastName VARCHAR())

GO

CREATE TABLE [ComputeColumnCompare] (ID INT,

FirstName VARCHAR(),

LastName VARCHAR())

GO
USE TSQL2012

GO

INSERT INTO [dbo].[ComputeColumn] (ID,FirstName,LastName)

SELECT TOP  ROW_NUMBER() OVER (ORDER BY a.name) RowID,

'Bob',

CASE WHEN ROW_NUMBER() OVER (ORDER BY a.name)% =  THEN 'Smith'

ELSE 'Brown' END

FROM sys.all_objects a

CROSS JOIN sys.all_objects b

GO

INSERT INTO  [dbo].[ComputeColumnCompare](ID,FirstName,LastName)

SELECT TOP  ROW_NUMBER() OVER (ORDER BY a.name) RowID,

'Bob',

CASE WHEN ROW_NUMBER() OVER (ORDER BY a.name)% =  THEN 'Smith'

ELSE 'Brown' END

FROM sys.all_objects a

CROSS JOIN sys.all_objects b

GO
在ComputeColumn表上创建计算列并创建一个非聚集索引
ALTER TABLE dbo.ComputeColumn ADD

FullName AS (FirstName+' '+LastName)

GO

CREATE NONCLUSTERED INDEX IX_CompCol_CityTrim

ON dbo.ComputeColumn (FullName)

GO
在ComputeColumnCompare表上创建计算列
ALTER TABLE dbo.ComputeColumnCompare ADD

FullName_P AS (FirstName+' '+LastName)

GO
最后查询两个表看看查询计划结果
USE TSQL2012

GO

SELECT FullName

FROM dbo.ComputeColumn

WHERE FullName = 'Bob Smith'

GO

SELECT FullName_P

FROM dbo.ComputeColumnCompare

WHERE FullName_P = 'Bob Smith'

GO

从上述我们知道对计算列创建一个索引能很好的提高查询性能,当然了上述仅仅只是返回计算列,若返回其他列的话可能会导致Key Lookup,但是从另外一个角度来讲还是能提高查询性能,为了解决Key Lookup问题建立太多索引也是有问题的,具体情况具体分析吧。这里并没有比较持久化计算列和非持久化计算列的性能,二者其实是一样的,就没有比较了,只是在利用持久化在数据存储上不同而已。参考资料:【http://blog.sqlauthority.com/2010/08/03/sql-server-computed-column-persisted-and-performance/】
总结
到此我们算是结束了对于计算列以及关于计算列持久的概念和性能的分析,下节我们再看看其他查询的知识,接着就进入表表达式的学习,简短的内容,深入的理解,我们下节再会。
SQL Server-聚焦计算列或计算列持久化查询性能(二十二)的更多相关文章
- 在SQL Server 2014里可更新的列存储索引 (Updateable Column Store Indexes)
传统的关系数据库服务引擎往往并不是对超大量数据进行分析计算的最佳平台,为此,SQL Server中开发了分析服务引擎去对大笔数据进行分析计算.当然,对于数据的存放平台SQL Server数据库引擎而言 ...
- 第16/24周 SQL Server 2014中的基数计算
大家好,欢迎回到性能调优培训.上个星期我们讨论在SQL Server里基数计算过程里的一些问题.今天我们继续详细谈下,SQL Server 2014里引入的新基数计算. 新基数计算 SQL Serve ...
- Expression构建DataTable to Entity 映射委托 sqlserver 数据库里面金额类型为什么不建议用float,实例告诉你为什么不能。 sql server 多行数据合并成一列 C# 字符串大写转小写,小写转大写,数字保留,其他除外 从0开始用U盘制作启动盘装Windows10系统(联想R720笔记本)并永久激活方法 纯CSS打造淘宝导航菜单栏 C# Winform
Expression构建DataTable to Entity 映射委托 1 namespace Echofool.Utility.Common { 2 using System; 3 using ...
- 向SQL Server 现有表中添加新列并添加描述.
注: sql server 2005 及以上支持. 版本估计是不支持(工作环境2005,2008). 工作需要, 需要向SQL Server 现有表中添加新列并添加描述. 从而有个如下存储过程. (先 ...
- SQL Server调优系列基础篇(子查询运算总结)
前言 前面我们的几篇文章介绍了一系列关于运算符的介绍,以及各个运算符的优化方式和技巧.其中涵盖:查看执行计划的方式.几种数据集常用的连接方式.联合运算符方式.并行运算符等一系列的我们常见的运算符.有兴 ...
- sql server 使用链接服务器连接Oracle,openquery查询数据
对接问题描述:不知道正式库oracle数据库账户密码,对方愿意在对方的客户端上输入账号和密码,但不告诉我们 解决方案:使用一台sql server作为中间服务器,可以通过转存数据到sql serv ...
- sql:sql server,MySQL,PostgreSQL的表,视图,存储过程结构查询
sql server 2005: --SQL SERVER 2005 生成代码需要知道的SQL语句 use LibrarySystem --查询当前数据库所有表和其的主键字段,字段类型,长度,是否为空 ...
- SQL Server 执行计划利用统计信息对数据行的预估原理二(为什么复合索引列顺序会影响到执行计划对数据行的预估)
本文出处:http://www.cnblogs.com/wy123/p/6008477.html 关于统计信息对数据行数做预估,之前写过对非相关列(单独或者单独的索引列)进行预估时候的算法,参考这里. ...
- 在一个SQL Server表中的多个列找出最大值
在一个SQL Server表中一行的多个列找出最大值 有时候我们需要从多个相同的列里(这些列的数据类型相同)找出最大的那个值,并显示 这里给出一个例子 IF (OBJECT_ID('tempdb..# ...
随机推荐
- 在WPF中使用依赖注入的方式创建视图
在WPF中使用依赖注入的方式创建视图 0x00 问题的产生 互联网时代桌面开发真是越来越少了,很多应用都转到了浏览器端和移动智能终端,相应的软件开发上的新技术应用到桌面开发的文章也很少.我之前主要做W ...
- 分治法求解最近对问题(c++)
#include"stdafx.h" #include<iostream> #include<cmath> #define TRUE 1 #define F ...
- CSS 特殊属性介绍之 pointer-events
首先看一下 MDN 上关于 pointer-events 的介绍: CSS属性 pointer-events 允许作者控制特定的图形元素在何时成为鼠标事件的 target.当未指定该属性时,SVG 内 ...
- Tesseract-OCR字符识别简介
OCR(Optical Character Recognition):光学字符识别,是指对图片文件中的文字进行分析识别,获取的过程.Tesseract:开源的OCR识别引擎,初期Tesseract引擎 ...
- 动手做第一个Chrome插件
Chrome插件是令人惊讶的简单,一旦你弄懂它的工作和实现原理.它是由一部分HTML,一部分Js,然后混合了一个叫做manifest.json的Json文件组合而成的整体.这意味着你可以使用你最擅长的 ...
- 《动手实现一个网页加载进度loading》
loading随处可见,比如一个app经常会有下拉刷新,上拉加载的功能,在刷新和加载的过程中为了让用户感知到 load 的过程,我们会使用一些过渡动画来表达.最常见的比如"转圈圈" ...
- 学习C的笔记
[unsigned] 16位系统中一个int能存储的数据的范围为-32768~32767,而unsigned能存储的数据范围则是0~65535.由于在计算机中,整数是以补码形式存放的.根据最高位的不同 ...
- T-SQL字符串相加之后被截断的那点事
本文出处:http://www.cnblogs.com/wy123/p/6217772.html 字符串自身相加, 虽然赋值给了varchar(max)类型的变量,在某些特殊情况下仍然会被“截断”,这 ...
- TypeScript
TypeScript: Angular 2 的秘密武器(译) 本文整理自Dan Wahlin在ng-conf上的talk.原视频地址: https://www.youtube.com/watch? ...
- XSS 前端防火墙 —— 无懈可击的钩子
昨天尝试了一系列的可疑模块拦截试验,尽管最终的方案还存在着一些兼容性问题,但大体思路已经明确了: 静态模块:使用 MutationObserver 扫描. 动态模块:通过 API 钩子来拦截路径属性. ...