
Flink资料(5) -- Job和调度
该文档翻译自Jobs and Scheduling
-----------------------------------------------
该文档简单描述了Flink是如何调度Job的,以及如何在JobManager上表现并跟踪Job状态。
一、调度
Flink通过任务槽(Task Slot)定义执行资源。每个TaskManager都有一或多个任务槽,每个任务槽都可以运行一个流水线并行任务。一个流水线包括多个连续的任务,如一个MapFunction的第n个并行实例与一个ReduceFunction的第n个并行实例的连续任务。注意,Flink通常会并发执行连续的任务,对于流数据程序来说,任何情况都如此执行;而对批处理程序,多数情况也如此执行。
图1中是具有一个数据源、一个MapFunction和一个ReduceFunction的程序。数据源和MapFunction的执行并发度都为4,而ReduceFunction的执行并发度为3。在图1中,程序以Source-Map-Reduce的执行顺序,在具有2个TaskManager的集群上运行,每个TaskManager都有3个任务槽,则程序执行情况图所述。
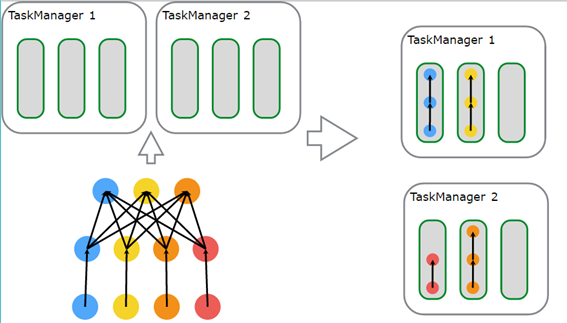
图1Flink并发运行和SlotSharing
Flink内通过SlotSharingGroup和CoLocationGroup来定义任务在共享任务槽的行为,可定义自由共享,或是严格定义某些任务部署到同一个任务槽中。
二、JobManager数据结构
在Job执行期间,JobManager将持续耿总分布式任务的执行,来决定什么时候调度下一个/下一批问题,并且对完成的或失败的任务进行响应。
JobManager接收JobGraph,JobGraph是数据流的表现形式,包括Operator(JobVertex)和中间结果(intermediateDataSet)。每个Operator都有诸如并行度和执行代码等属性。此外,JobGraph拥有一些附加的库,这些库都是在Operator执行代码时所需要的。
JobManager将JobGraph转换为ExecutionGraph。ExecutionGraph是JobGraph的并行版本:对每个JobVertex,它针对每个并行子任务都有一个ExecutionVertex。一个并行度为100的Operator将拥有一个JobVertex和100个ExecutionVertex。ExecutionVertex会跟踪其特定子任务的执行状态。来自一个JobVertex的所有ExecutionVertex都由一个ExecutionJobVertex管理,ExecutionJobVertex跟踪Operator总体的状态。除了这些节点之外,ExecutionGraph同样包括了IntermediateResult和IntermediateResultPartition,前者跟踪IntermediateDataSet的状态,后者跟踪每个它的partition的状态。
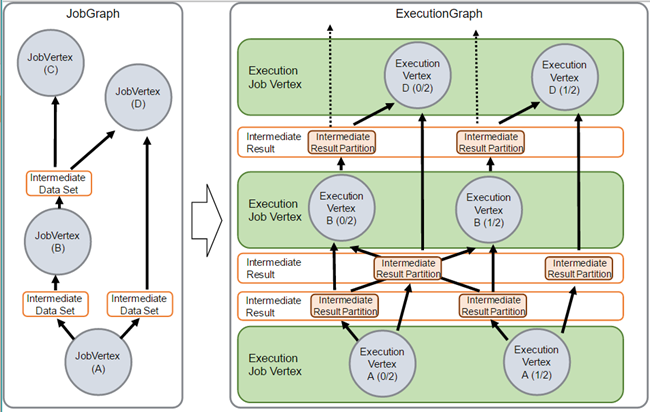
图2
JobGraph(Vertex) - ExecutionGraph(Vertex)
在程序执行期间,每个并行任务要经过多个阶段,从created到finished或failed。图3为各个状态以及它们之间可能的转换。一个任务可能被多次执行(如在失效恢复的过程中),所以我们以一个Exection跟踪一个ExecutionVertex。每个ExecutionVertex都有一个当前Execution(current execution)和一个前驱Execution(prior execution)。
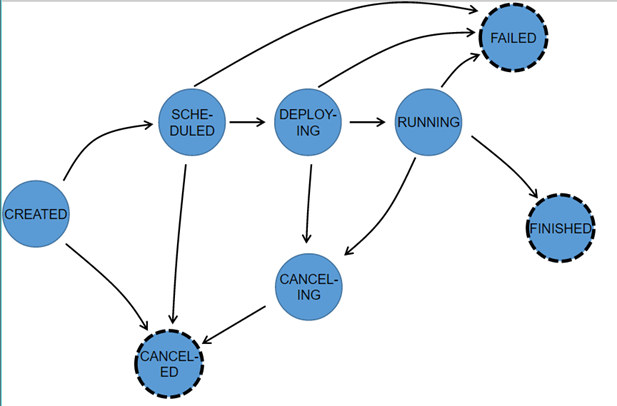
图3 执行阶段及跳转
Flink资料(5) -- Job和调度的更多相关文章
- Flink资料(1)-- Flink基础概念(Basic Concept)
Flink基础概念 本文描述Flink的基础概念,翻译自https://ci.apache.org/projects/flink/flink-docs-release-1.0/concepts/con ...
- Flink资料(8) -- Flink代码贡献的指导及准则
本文翻译自Contributing Code ----------------------------------------- Apache Flink是由自愿的代码贡献者维护.优化及扩展的.Apa ...
- Flink资料(7) -- 背压监控
背压(backpressure)监控 本文翻译自Back Pressure Monitoring --------------------------------------------------- ...
- Flink资料(4) -- 类型抽取和序列化
类型抽取和序列化 本文翻译自Type Extraction and Serialization Flink处理类型的方式比较特殊,包括它自己的类型描述,一般类型抽取和类型序列化框架.该文档描述这些概念 ...
- Flink资料(3)-- Flink一般架构和处理模型
Flink一般架构和处理模型 本文翻译自General Architecture and Process Model ----------------------------------------- ...
- Flink资料(2)-- 数据流容错机制
数据流容错机制 该文档翻译自Data Streaming Fault Tolerance,文档描述flink在流式数据流图上的容错机制. ------------------------------- ...
- Flink资料(6) -- 如何添加一个新的Operator
false false false false EN-US ZH-CN X-NONE /* Style Definitions */ table.MsoNormalTable {mso-style-n ...
- Flink学习笔记-新一代Flink计算引擎
说明:本文为<Flink大数据项目实战>学习笔记,想通过视频系统学习Flink这个最火爆的大数据计算框架的同学,推荐学习课程: Flink大数据项目实战:http://t.cn/EJtKh ...
- Dijkstra 调度场算法 Python实现 一
调度场算法(Shunting Yard Algorithm)是一个用于将中缀表达式转换为后缀表达式的经典算法,由 Edsger Wybe Dijkstra 引入,因其操作类似于火车编组场而得名. — ...
随机推荐
- Hibernate中load与get的区别
1.get()采用立即加载方式,而load()采用延迟加载; ①get()方法执行的时候,会立即向数据库发出查询语句;(查询顺序:内部缓存,数据库) ②load()方法返回的是一个代理(此代理中只有一 ...
- 如何让tableView展示数据
设置数据源对象 self.tableView.dataSource = self; 数据源对象要遵守协议 @interface ViewController () <UITableViewDat ...
- Android Studio 项目目录结构 英文版
I don't know if this is because of the Gradle Build System (I'd wager it is), but I'll tell you what ...
- VC++客户端 缩小包的尺寸
图片压缩: 1. 背景图片尺寸一般为100-300KB,使用纯色图片可缩小至1-3KB,方法得当可缩小1M多: 2. .ico一般为100-200KB,16x16一直到256x256,可减去其中几种尺 ...
- c++对文件操作的支持(二)
#include <stdio.h> #include <iostream> #include <fstream> using namespace std; voi ...
- linux安装php5.3
安装php的依赖包 [root@localhost admin]# unzip libxml2-2.7.8.tar.zip [root@localhost admin]#tar zvxf libxml ...
- 开博第二篇:记一个利用JavaScript,编写PS脚本,开发图片量产工具
背景:身在一个有实业的电商公司,设计部的妹子们总是会有做不完的商品图片,当然了,要是做点有技术含量的美化工作也罢,但是最近她们很是无聊,总是要做一些重复性的工作,就比如如题所说的,图片量产,量产什么呢 ...
- java接口的理解
接口的最主要的作用是达到统一访问,就是在创建对象的时候用接口创建,[接口名] [对象名]=new [实现接口的类],这样你像用哪个类的对象就可以new哪个对象了,不需要改原来的代码,就和你的USB接口 ...
- C++进程间通信(常用理解例子)-买票
#include "stdafx.h" #include <iostream>using namespace std; #include "windows.h ...
- linux下实现两人、三人无序对话功能
序:引子 对话功能实际上就是利用管道见得通信.最原始的是一方发另一方收,不能进项交互,发送方的代码如下: /*============================================ ...