
Java多线程18:线程池
使用线程池与不使用线程池的差别
先来看一下使用线程池与不使用线程池的差别,第一段代码是使用线程池的:
public static void main(String[] args)

{

    long startTime = System.currentTimeMillis();

    final List<Integer> l = new LinkedList<Integer>();

    ThreadPoolExecutor tp = new ThreadPoolExecutor(100, 100, 60, TimeUnit.SECONDS, new LinkedBlockingQueue<Runnable>(20000));

    final Random random = new Random();

    for (int i = 0; i < 20000; i++)

    {

        tp.execute(new Runnable()

        {

            public void run()

            {

                l.add(random.nextInt());

            }

        });

    }

    tp.shutdown();

    try

    {

        tp.awaitTermination(1, TimeUnit.DAYS);

    }

    catch (InterruptedException e)

    {

        e.printStackTrace();

    }

    System.out.println(System.currentTimeMillis() - startTime);

    System.out.println(l.size());

}
接着是不使用线程池的:
public static void main(String[] args)

{

    long startTime = System.currentTimeMillis();

    final List<Integer> l = new LinkedList<Integer>();

    final Random random = new Random();

    for (int i = 0; i < 20000; i++)

    {

        Thread thread = new Thread()

        {

            public void run()

            {

                l.add(random.nextInt());

            }

        };

        thread.start();

        try

        {

            thread.join();

        }

        catch (InterruptedException e)

        {

            e.printStackTrace();

        }

    }

    System.out.println(System.currentTimeMillis() - startTime);

    System.out.println(l.size());

}
运行一下,我这里第一段代码使用了线程池的时间是194ms,第二段代码不使用线程池的时间是2043ms。这里默认的线程池中的线程数是100,如果把这个数量减小,虽然系统的处理数据能力变弱了,但是速度却更快了。当然这个例子很简单,但也足够说明问题了。
线程池的作用
线程池的作用就2个:
1、减少了创建和销毁线程的次数,每个工作线程都可以被重复利用,可执行多个任务
2、可以根据系统的承受能力,调整线程池中工作线程的数据,防止因为消耗过多的内存导致服务器崩溃
使用线程池,要根据系统的环境情况,手动或自动设置线程数目。少了系统运行效率不高,多了系统拥挤、占用内存多。用线程池控制数量,其他线程排队等候。一个任务执行完毕,再从队列中取最前面的任务开始执行。若任务中没有等待任务,线程池这一资源处于等待。当一个新任务需要运行,如果线程池中有等待的工作线程,就可以开始运行了,否则进入等待队列。
线程池类结构
画了一张图表示线程池的类结构图:
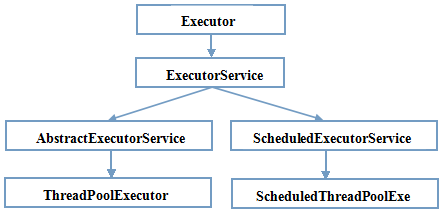
这张图基本简单代表了线程池类的结构:
1、最顶级的接口是Executor,不过Executor严格意义上来说并不是一个线程池而只是提供了一种任务如何运行的机制而已
2、ExecutorService才可以认为是真正的线程池接口,接口提供了管理线程池的方法
3、下面两个分支,AbstractExecutorService分支就是普通的线程池分支,ScheduledExecutorService是用来创建定时任务的
ThreadPoolExecutor六个核心参数
这篇文章重点讲的就是线程池ThreadPoolExecutor,开头也演示过ThreadPoolExecutor的使用了。
下面来看一下ThreadPoolExecutor完整构造方法的签名,签名中包含了六个参数,是ThreadPoolExecutor的核心,对这些参数的理解、配置、调优对于使用好线程池是非常重要的。因此接下来需要逐一理解每个参数的具体作用。先看一下构造方法签名:
public ThreadPoolExecutor(int corePoolSize,

                          int maximumPoolSize,

                          long keepAliveTime,

                          TimeUnit unit,

                          BlockingQueue<Runnable> workQueue,

                          ThreadFactory threadFactory,

                          RejectedExecutionHandler handler)
1、corePoolSize
核心池的大小。在创建了线程池之后,默认情况下,线程池中没有任何线程,而是等待有任务到来才创建线程去执行任务。默认情况下,在创建了线程池之后,线程池钟的线程数为0,当有任务到来后就会创建一个线程去执行任务
2、maximumPoolSize
池中允许的最大线程数,这个参数表示了线程池中最多能创建的线程数量,当任务数量比corePoolSize大时,任务添加到workQueue,当workQueue满了,将继续创建线程以处理任务,maximumPoolSize表示的就是wordQueue满了,线程池中最多可以创建的线程数量
3、keepAliveTime
只有当线程池中的线程数大于corePoolSize时,这个参数才会起作用。当线程数大于corePoolSize时,终止前多余的空闲线程等待新任务的最长时间
4、unit
keepAliveTime时间单位
5、workQueue
存储还没来得及执行的任务
6、threadFactory
执行程序创建新线程时使用的工厂
7、handler
由于超出线程范围和队列容量而使执行被阻塞时所使用的处理程序
corePoolSize与maximumPoolSize举例理解
上面的内容,其他应该都相对比较好理解,只有corePoolSize和maximumPoolSize需要多思考。这里要特别再举例以四条规则解释一下这两个参数:
1、池中线程数小于corePoolSize,新任务都不排队而是直接添加新线程
2、池中线程数大于等于corePoolSize,workQueue未满,首选将新任务加入workQueue而不是添加新线程
3、池中线程数大于等于corePoolSize,workQueue已满,但是线程数小于maximumPoolSize,添加新的线程来处理被添加的任务
4、池中线程数大于大于corePoolSize,workQueue已满,并且线程数大于等于maximumPoolSize,新任务被拒绝,使用handler处理被拒绝的任务
ThreadPoolExecutor的使用很简单,前面的代码也写过例子了。通过execute(Runnable command)方法来发起一个任务的执行,通过shutDown()方法来对已经提交的任务做一个有效的关闭。尽管线程池很好,但我们要注意JDK API的一段话:
强烈建议程序员使用较为方便的Executors工厂方法Executors.newCachedThreadPool()(无界线程池,可以进行线程自动回收)、Executors.newFixedThreadPool(int)(固定大小线程池)和Executors.newSingleThreadExecutor()(单个后台线程),它们均为大多数使用场景预定义了设置。
所以,跳开对ThreadPoolExecutor的关注(还是那句话,有问题查询JDK API),重点关注一下JDK推荐的Executors。
Executors
个人认为,线程池的重点不是ThreadPoolExecutor怎么用或者是Executors怎么用,而是在合适的场景下使用合适的线程池,所谓"合适的线程池"的意思就是,ThreadPoolExecutor的构造方法传入不同的参数,构造出不同的线程池,以满足使用的需要。
下面来看一下Executors为用户提供的几种线程池:
1、newSingleThreadExecutos() 单线程线程池
public static ExecutorService newSingleThreadExecutor() {

    return new FinalizableDelegatedExecutorService

        (new ThreadPoolExecutor(1, 1,

                                0L, TimeUnit.MILLISECONDS,

                                new LinkedBlockingQueue<Runnable>()));

}
单线程线程池,那么线程池中运行的线程数肯定是1。workQueue选择了无界的LinkedBlockingQueue,那么不管来多少任务都排队,前面一个任务执行完毕,再执行队列中的线程。从这个角度讲,第二个参数maximumPoolSize是没有意义的,因为maximumPoolSize描述的是排队的任务多过workQueue的容量,线程池中最多只能容纳maximumPoolSize个任务,现在workQueue是无界的,也就是说排队的任务永远不会多过workQueue的容量,那maximum其实设置多少都无所谓了
2、newFixedThreadPool(int nThreads) 固定大小线程池
public static ExecutorService newFixedThreadPool(int nThreads) {

    return new ThreadPoolExecutor(nThreads, nThreads,

                                  0L, TimeUnit.MILLISECONDS,

                                  new LinkedBlockingQueue<Runnable>());

}
固定大小的线程池和单线程的线程池异曲同工,无非是让线程池中能运行的线程编程了手动指定的nThreads罢了。同样,由于是选择了LinkedBlockingQueue,因此其实第二个参数maximumPoolSize同样也是无意义的
3、newCachedThreadPool() 无界线程池
public static ExecutorService newCachedThreadPool() {

    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,

                                  60L, TimeUnit.SECONDS,

                                  new SynchronousQueue<Runnable>());

}
无界线程池,意思是不管多少任务提交进来,都直接运行。无界线程池采用了SynchronousQueue,采用这个线程池就没有workQueue容量一说了,只要添加进去的线程就会被拿去用。既然是无界线程池,那线程数肯定没上限,所以以maximumPoolSize为主了,设置为一个近似的无限大Integer.MAX_VALUE。 另外注意一下,单线程线程池和固定大小线程池线程都不会进行自动回收的,也即是说保证提交进来的任务最终都会被处理,但至于什么时候处理,就要看处理能力了。但是无界线程池是设置了回收时间的,由于corePoolSize为0,所以只要60秒没有被用到的线程都会被直接移除
谈谈workQueue
上面三种线程池都提到了一个概念,workQueue,也就是排队策略。排队策略描述的是,当前线程大于corePoolSize时,线程以什么样的方式排队等待被运行。
排队有三种策略:直接提交、有界队列、无界队列。
谈谈后两种,JDK使用了无界队列LinkedBlockingQueue作为WorkQueue而不是有界队列ArrayBlockingQueue,尽管后者可以对资源进行控制,但是个人认为,使用有界队列相比无界队列有三个缺点:
1、使用有界队列,corePoolSize、maximumPoolSize两个参数势必要根据实际场景不断调整以求达到一个最佳,这势必给开发带来极大的麻烦,必须经过大量的性能测试。所以干脆就使用无界队列,任务永远添加到队列中,不会溢出,自然maximumPoolSize也没什么用了,只需要根据系统处理能力调整corePoolSize就可以了
2、防止业务突刺。尤其是在Web应用中,某些时候突然大量请求的到来都是很正常的。这时候使用无界队列,不管早晚,至少保证所有任务都能被处理到。但是使用有界队列呢?那些超出maximumPoolSize的任务直接被丢掉了,处理地慢还可以忍受,但是任务直接就不处理了,这似乎有些糟糕
3、不仅仅是corePoolSize和maximumPoolSize需要相互调整,有界队列的队列大小和maximumPoolSize也需要相互折衷,这也是一块比较难以控制和调整的方面
当然,最后还是那句话,就像Comparable和Comparator的对比、synchronized和ReentrantLock,再到这里的无界队列和有界队列的对比,看似都有一个的优点稍微突出一些,但是这绝不是鼓励大家使用一个而不使用另一个,任何东西都需要根据实际情况来,当然在一开始的时候可以重点考虑那些看上去优点明显一点的
四种拒绝策略
所谓拒绝策略之前也提到过了,任务太多,超过maximumPoolSize了怎么把?当然是接不下了,接不下那只有拒绝了。拒绝的时候可以指定拒绝策略,也就是一段处理程序。
决绝策略的父接口是RejectedExecutionHandler,JDK本身在ThreadPoolExecutor里给用户提供了四种拒绝策略,看一下:
1、AbortPolicy
直接抛出一个RejectedExecutionException,这也是JDK默认的拒绝策略
2、CallerRunsPolicy
尝试直接运行被拒绝的任务,如果线程池已经被关闭了,任务就被丢弃了
3、DiscardOldestPolicy
移除最晚的那个没有被处理的任务,然后执行被拒绝的任务。同样,如果线程池已经被关闭了,任务就被丢弃了
4、DiscardPolicy
不能执行的任务将被删除
Java多线程18:线程池的更多相关文章
- Java多线程与线程池技术
一.序言 Java多线程编程线程池被广泛使用,甚至成为了标配. 线程池本质是池化技术的应用,和连接池类似,创建连接与关闭连接属于耗时操作,创建线程与销毁线程也属于重操作,为了提高效率,先提前创建好一批 ...
- Java 多线程:线程池
Java 多线程:线程池 作者:Grey 原文地址: 博客园:Java 多线程:线程池 CSDN:Java 多线程:线程池 工作原理 线程池内部是通过队列结合线程实现的,当我们利用线程池执行任务时: ...
- java多线程、线程池及Spring配置线程池详解
1.java中为什么要使用多线程使用多线程,可以把一些大任务分解成多个小任务来执行,多个小任务之间互不影像,同时进行,这样,充分利用了cpu资源.2.java中简单的实现多线程的方式 继承Thread ...
- Java多线程和线程池
转自:http://blog.csdn.net/u013142781/article/details/51387749 1.为什么要使用线程池 在Java中,如果每个请求到达就创建一个新线程,开销是相 ...
- Java多线程之线程池详解
前言 在认识线程池之前,我们需要使用线程就去创建一个线程,但是我们会发现有一个问题: 如果并发的线程数量很多,并且每个线程都是执行一个时间很短的任务就结束了,这样频繁创建线程就会大大降低系统的效率,因 ...
- JAVA多线程(三) 线程池和锁的深度化
github演示代码地址:https://github.com/showkawa/springBoot_2017/tree/master/spb-demo/spb-brian-query-servic ...
- Java多线程-ThreadPool线程池(三)
开完一趟车完整的过程是启动.行驶和停车,但老司机都知道,真正费油的不是行驶,而是长时间的怠速.频繁地踩刹车等动作.因为在速度切换的过程中,发送机要多做一些工作,当然就要多费一些油. 而一个Java线程 ...
- java 多线程 4 线程池
系统启动一个新线程的成本是比较高的,因为它涉及到与操作系统的交互.在这种情况下,使用线程池可以很好的提供性能,尤其是当程序中需要创建大量生存期很短暂的线程时,更应该考虑使用线程池. 与数据库连接池类似 ...
- Java多线程之线程池
现在是多核的时代,面向多核的编程很重要,因此基于java的并发和多线程开发非常重要. 线程池是于队列密切相关的,其中队列保存了所有等待执行的任务.工作者线程的任务很简单:从队列中获取一个任务,执行任务 ...
- Java多线程(四) 线程池
一个优秀的软件不会随意的创建.销毁线程,因为创建和销毁线程需要耗费大量的CPU时间以及需要和内存做出大量的交互.因此JDK5提出了使用线程池,让程序员把更多的精力放在业务逻辑上面,弱化对线程的开闭管理 ...
随机推荐
- TCP/IP详解系列 --- 概念总结02
TCP复位报文段(RST)的用途: 1.当客户端程序访问不存在的端口时,目标主机将给它发送一个复位报文段:收到复位报文段的一端应该关闭连接或者重新连接,而不能回应这个复位报文段. 2.当客户端程序向服 ...
- My安卓知识3--多个activity之前共享数据的方法
在网上搜这个问题的时候看到了有一篇文章说有五种方法: 1.基于消息的通信机制 Intent ---boudle ,extra 数据类型有限,比如遇到不可序列化的数据Bitmap,InputStrea ...
- vmware安装linux6.3
安装信息: 1.vmware9.0下载地址:http://pan.baidu.com/share/link?shareid=1287299796&uk=2585121485 2.oraclel ...
- DSP(1) -- 离散时间信号的序列类型
1.单位采样序列δ(n):在MATLAB 中函数zeros(1,N)产生一个由N个零组成的列向量.它可用来实现有限区间的δ(n).然而,更高明的方法是利用逻辑关系式n==0来实现δ(n). 2.单位阶 ...
- eclipse配置javaee环境
笔者开发javaee项目时惯用myeclipse,但由于个人笔记本性能较低,myeclipse对内存的消耗极大,所以考虑换成eclipse开发.本文介绍eclipse配置javaee开发环境的一些体会 ...
- 使用Application Insights 做分析
Application Insights on Windows Desktop apps, services and worker roles : https://azure.microsoft.co ...
- 由Selenium1转变为Selenium2所遇到的问题
1.使用ant脚本运行测试,报NoClassDefError,但使用junit方式运行或debug,都没有错误. 原因:找不到包,但具体是哪个包,不清楚:且为何使用junit方式运行就没有问题,也不清 ...
- linux进程间通信-共享内存
转载:http://www.cnblogs.com/fangshenghui/p/4039720.html 一 共享内存介绍 共享内存可以从字面上去理解,就把一片逻辑内存共享出来,让不同的进程去访问它 ...
- shell下批量重命名svn文件的方法
shell下批量重命名svn文件的方法 目标: 将svn目录下所有文件重命名 , 原文件前缀为 ucc_ , 批量改为 xmd_ 用tree看下当前svn目录 ucc_1.c ucc_1.h ucc_ ...
- express 转
目录 此文重点介绍Express3.0的开发框架,其中还会涉及到Mongoose,Ejs,Bootstrap等相关内容.Express已经升级到4.x,请同时参考文章,Node.js开发框架Expre ...