
NLP:单词嵌入Word Embeddings
深度学习、自然语言处理和表征方法
原文链接:http://blog.jobbole.com/77709/
一个感知器网络(perceptron network)。感知器 (perceptron)是非常简单的神经元,如果超过一个阈值它就会被启动,如果没超过改阈值它就没反应。感知器网络的输入和输出都是是二进制的(0和1)。
注意可能的输入个数是有限的。对每个可能的输入,我们可以在隐层里面构建一个只对这个输入有反应的神经元(见注解1)。然后我们可以利用这个神经元和输出神经元之间的连接来控制这个输入下得到的结果(见注解2)。

这样可以说明单隐层神经网络的确是有普适性的。但是这也没啥了不起的呀。你的模型能干和查询表一样的事并不能说明你的模型有任何优点。这只能说明用你的模型来完成任务并不是不可能的罢了。
普适性的真正意义是:一个网络能适应任何你给它的训练数据。这并不代表插入新的数据点的时候它能表现地很理想。
所以普适性并不能解释为什么神经网络如此好用。真正的原因比这微妙得多… 为了理解它,我们需要先理解一些具体的成果。
单词嵌入(Word Embeddings)
我想从深度学习研究的一个非常有意思的部分讲起,它就是:单词嵌入(word embeddings)。在我看来,单词嵌入是目前深度学习最让人兴奋的领域之一,尽管它最早是由Bengio等人在十多年前提出的(见注解3)。除此之外,我认为它们能帮助你通过直觉来了解为什么深度学习如此有效。
单词嵌入W:words→Rn是一个参数化函数,它把某个语言里的单词映射成高维向量(大概200到500维)。例如这样:
举个一个可能的任务的例子:训练一个网络让其预测一个5元组(5-gram)(连续的5个词)是否‘成立’。我们可以随便从维基百科上选一堆5元组(比如cat sat on the mat)然后把其中一个词随便换成另外一个词(比如cat sat song the mat),那么一半的5元组估计都会变得荒谬且没意义了。

我们训练的模型会通过W把5元组中每个词的表征向量取出来,输入给另外一个叫R的模块,模块R会试图预测这个5元组是‘成立的’或者是‘破碎的’。然后我们希望看见:
为了准确地预测这些值,这个网络需要从W以及R中学习到好的参数。
现在看来这个任务并没什么意思。也许它能用来检测语法错误什么的,没什么大不了。但是极其有趣的部分是这个W。
(事实上,对我们来说,这个任务的意义就是学习W。我们当然也可以做一些其他的任务 – 一个很常见的任务是预测句子中下一个单词。但我们实际上并不在乎任务是什么。这节后面我们会谈到许多单词嵌入成果,但并不会区分得到这些成果的方法的不同。)
想直观感受一下单词嵌入空间的话,我们可以用t-SNE来对它进行可视化。t-SNE是一个复杂的高维数据可视化技术。

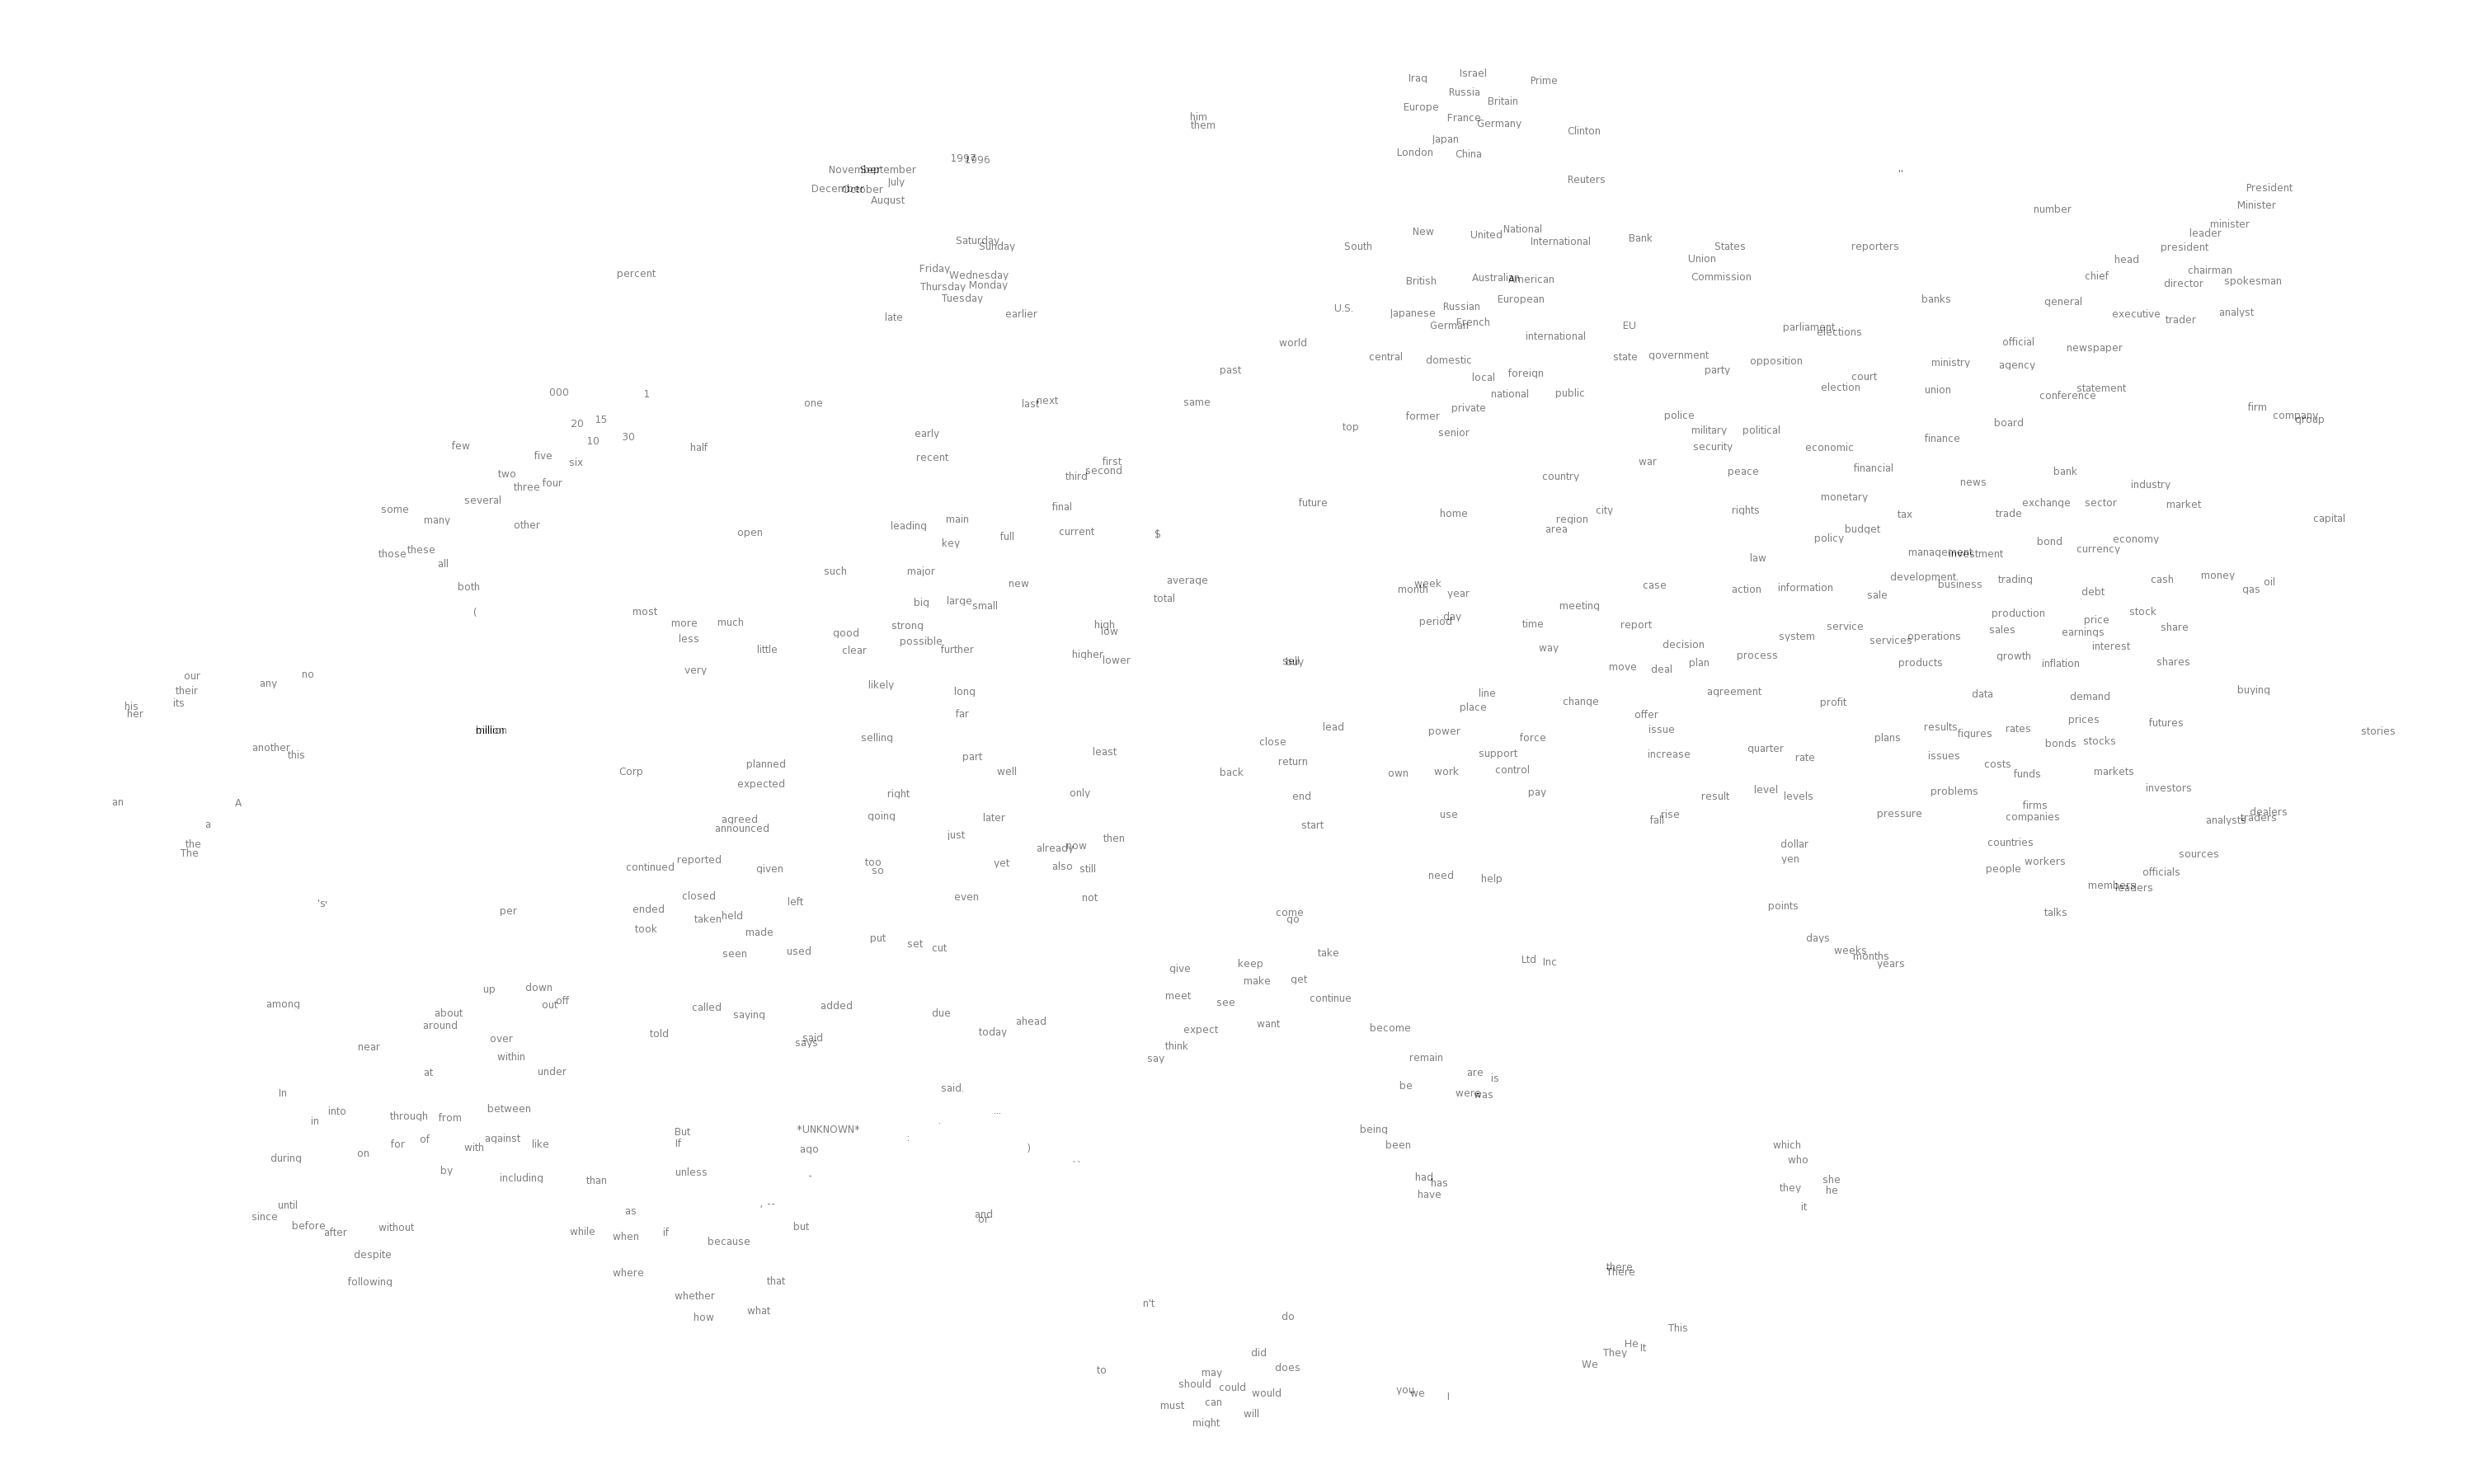
这种单词构成的“地图”对我们来说更直观。相似的词离得近。另一种方法是看对一个给定单词来说,哪些其他的单词离它最近。我们可以再一次看到,这些词都很相似。

网络能让意义相似的词拥有相似的向量,这看起来是很自然的事。如果你把一个词换成它的同义词(例如 “a few people sing well” → “a couple people sing well”),句子的成立性并没有变化。虽然从字面上看,句子变化很大,但如果W把同义词(像“few”和”couple”这种)映射到相近的空间,从R的角度来看句子的变化很小。
这就牛了。可能的5元组的数目是巨大的,相比之下我们的训练数据量很小。相似的单词距离近能让我们从一个句子演变出一类相似的句子。这不仅指把一个词替换成一个它的同义词,而且指把一个词换成一个相似类别里面的词(如“the wall is blue” → “the wall is red” )。进一步地,我们可以替换多个单词(例如“the wall is blue” → “the ceiling is red”)。它的影响对单词数目来说是指数级的
(参见注解4)。
很明显,这是W的一个用武之地。但它是如何学会做这个的呢?看起来很可能很多情况下它是先知道“the wall is blue”这样的句子是成立的,然后才见到“the wall is red”这样的句子。这样的话,把“red”往”blue”那边挪近一点,网络的效果就更好。
我们并没见过每个单词使用的例子,但是类比能让我们泛化衍生出新的单词组合。你懂的单词你都见过,但是你能懂的句子你并没有都见过。神经网络也是如此。
DeepLearning的优化方法:
NLP:单词嵌入Word Embeddings的更多相关文章
- TensorFlow NMT的词嵌入(Word Embeddings)
本文转载自:http://blog.stupidme.me/2018/08/05/tensorflow-nmt-word-embeddings/,本站转载出于传递更多信息之目的,版权归原作者或者来源机 ...
- deeplearning.ai 序列模型 Week 2 NLP & Word Embeddings
1. Word representation One-hot representation的缺点:把每个单词独立对待,导致对相关词的泛化能力不强.比如训练出“I want a glass of ora ...
- Coursera Deep Learning笔记 序列模型(二)NLP & Word Embeddings(自然语言处理与词嵌入)
参考 1. Word Representation 之前介绍用词汇表表示单词,使用one-hot 向量表示词,缺点:它使每个词孤立起来,使得算法对相关词的泛化能力不强. 从上图可以看出相似的单词分布距 ...
- 吴恩达《深度学习》-课后测验-第五门课 序列模型(Sequence Models)-Week 2: Natural Language Processing and Word Embeddings (第二周测验:自然语言处理与词嵌入)
Week 2 Quiz: Natural Language Processing and Word Embeddings (第二周测验:自然语言处理与词嵌入) 1.Suppose you learn ...
- 吴恩达《深度学习》-第五门课 序列模型(Sequence Models)-第二周 自然语言处理与词嵌入(Natural Language Processing and Word Embeddings)-课程笔记
第二周 自然语言处理与词嵌入(Natural Language Processing and Word Embeddings) 2.1 词汇表征(Word Representation) 词汇表示,目 ...
- 课程五(Sequence Models),第二 周(Natural Language Processing & Word Embeddings) —— 1.Programming assignments:Operations on word vectors - Debiasing
Operations on word vectors Welcome to your first assignment of this week! Because word embeddings ar ...
- [DeeplearningAI笔记]序列模型2.1-2.2词嵌入word embedding
5.2自然语言处理 觉得有用的话,欢迎一起讨论相互学习~Follow Me 2.1词汇表征 Word representation 原先都是使用词汇表来表示词汇,并且使用1-hot编码的方式来表示词汇 ...
- [C5W2] Sequence Models - Natural Language Processing and Word Embeddings
第二周 自然语言处理与词嵌入(Natural Language Processing and Word Embeddings) 词汇表征(Word Representation) 上周我们学习了 RN ...
- 翻译 | Improving Distributional Similarity with Lessons Learned from Word Embeddings
翻译 | Improving Distributional Similarity with Lessons Learned from Word Embeddings 叶娜老师说:"读懂论文的 ...
随机推荐
- 洛谷 2234 BZOJ 1588 HNOI2002 营业额统计
[题解] treap模板题,直接用Treap维护前驱.后继,每次找到更接近当前val的加上就好了. #include<cstdio> #include<algorithm> # ...
- 【Codeforces 63C】Bulls and Cows
[链接] 我是链接,点我呀:) [题意] 给你一个长度为4的数字序列(每个数字都在0~9之间,且不重复出现) 现在让你猜这个长度为4的序列是什么. 猜了之后对方会告诉有几个数字是位置和数字都正确的(猜 ...
- HyperLedger项目以及社区
本文不涉及任何技术开发的内容,仅供你跟同学.同事吹牛B之用.就像很多牛人总爱讲历史典故一样. 一.诞生与现状 HyperLedger 诞生于2015年12月17日,HyperLedger 追寻Apac ...
- 【学QT】2 - QT/E环境的建立
Arm-Linux嵌入式QT/E环境的建立(qt/e 3.x系列) QT/E 3.x系列比QT/E 2.x系列有非常大的改进,大大提高了开发进度,不再使用tmake,安装也更简单.但 ...
- kendo grid结合ajax功能
我感觉使用ajax结合表格绑定效率更好一些,可以灵活的控制点击前后的事件,现在grid前后的事件我不能控制
- 洛谷 P2997 [USACO10NOV]旗帜Banner
P2997 [USACO10NOV]旗帜Banner 题目背景 题目大意(by:曹彦臣): 平面上有(0,0)到(n,m)的(n+1)*(m+1)个点.问有多少点对所连的线段不过其他点,且长度在[l, ...
- [MongoDB]mongo命令行工具
1.use dbname 自动创建 2.db.user.find() 空 show collections 空 show dbs 3.db.user.save({name:'',age:20}) db ...
- Machine_learning--score
辛苦了2个半月,终须学完了machine-learning watermark/2/text/aHR0cDovL2Jsb2cuY3Nkbi5uZXQvY2hyaXN0cHJpbmNlMDA3/font ...
- ASP.NET MVC 4源代码分析之怎样定位控制器
利用少有的空余时间.具体的浏览了下ASP.NET MVC 4的源代码.照着之前的步伐继续前进(尽管博客园已经存在非常多大牛对MVC源代码分析的博客,可是从个人出发.还是希望自己可以摸索出这些). 首先 ...
- oc30--id
// // Person.h #import <Foundation/Foundation.h> @interface Person : NSObject - (void)sleep; @ ...