
用深度学习模型Word2Vec探索《红楼梦》人物关系
先来看一看结果,发现:
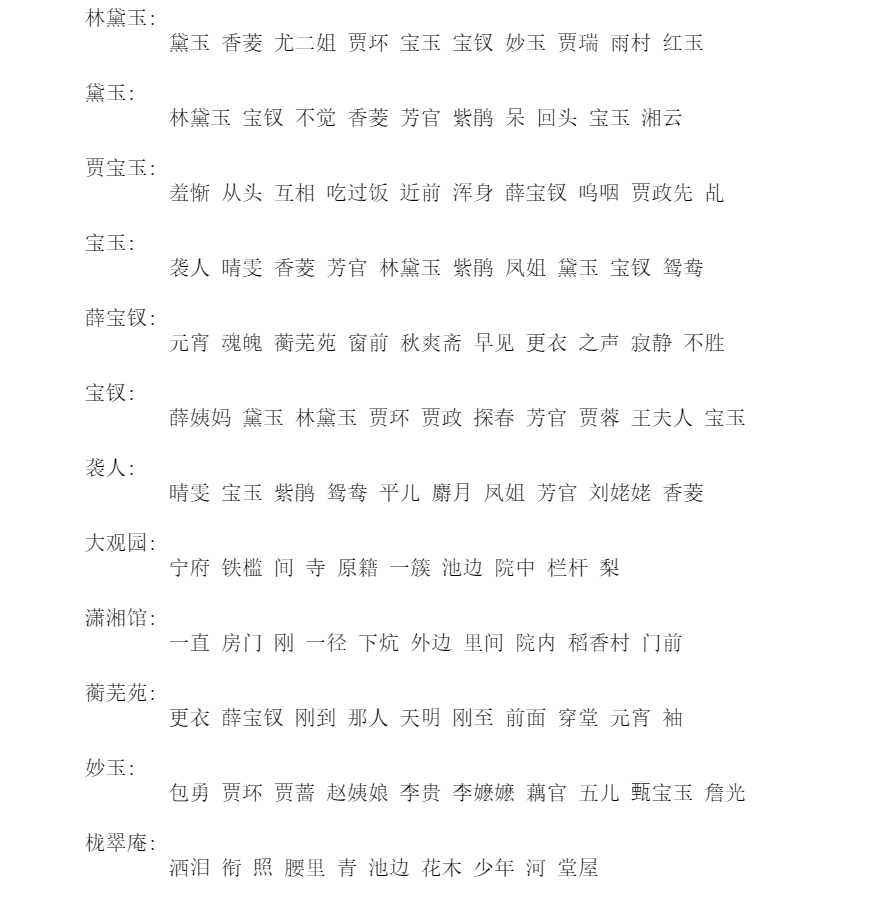
1.贾宝玉和袭人的关系最近。
2.薛宝钗和自己的妈妈关系最近。
3.贾宝玉和林黛玉逼格比较统一,薛宝钗属于独树一帜的逼格调性。
4.大观园中可以看到邢岫烟经常出没...
还有更多秘密等你自己上手去训练模型并发现...
开始写代码!
1from tqdm import tqdm
2#tqdm用来观察进度条,非必须
3import jieba
4import sys
5import os
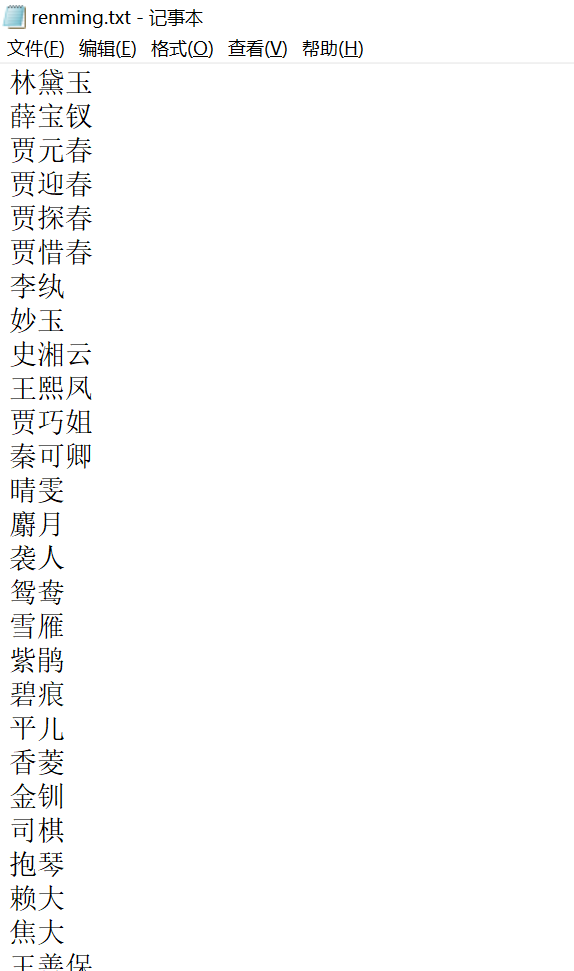
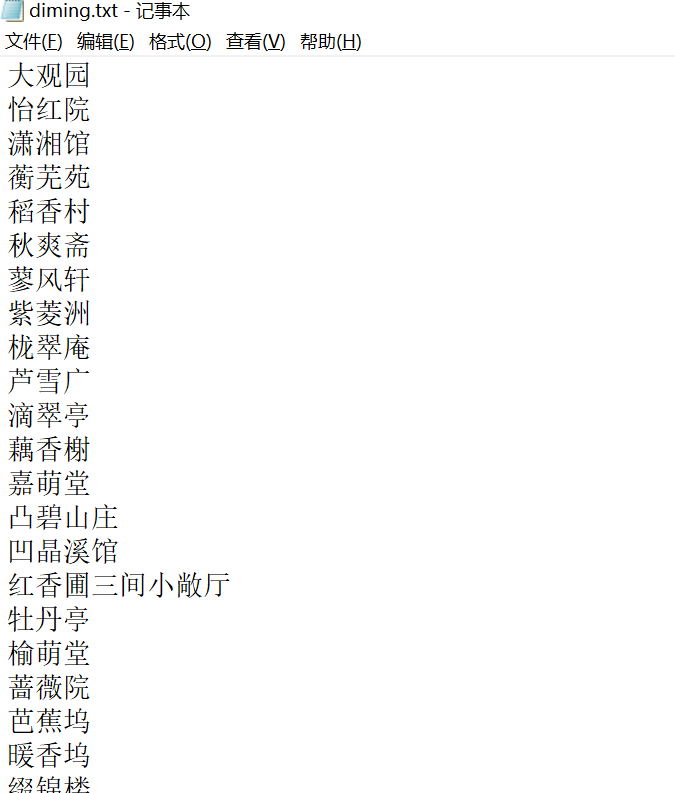
声明一下,这里自定义了两个词典分别命名为“renming.txt”和“diming.txt”,分别写入了红楼梦中常见人名地名,这里展示一下格式,有需要的可以添加我微信dicey0310
继续写代码!
 1os.chdir("C://users//dicey//desktop")
 2# 调用 jieba分词module后,添加单词本(人名等):
 3jieba.load_userdict("renming.txt")
 4jieba.load_userdict("diming.txt")
 5
 6#这里是在百度上下载的红楼梦完整版的txt
 7filename = 'HongLouMeng.txt'
 8text_lines = []
 9with open(filename,encoding='utf-8',errors='ignore') as f:
10    for line in tqdm(f):
11        text_lines.append(line)
12print('总共读入%d行文字'% (len(text_lines)))
13
14#检查一下读入文字的正确性
15print(text_lines[17])
把红楼梦的txt版(utf-8编码)一行一行读进来,用tqdm辅助显示进度条:
1data_lines = []
2
3## 分词并添加进列表:
4for line in tqdm(text_lines):
5    one_line = [' '.join(jieba.cut(line, cut_all=False))][0].split(' ')
6    data_lines.append(one_line)
开始数据预处理,去除了标点符号、数字、停用词:
1import re
2# 标点符号 (punctuation)
3punct = set(u'''.&#:!),.:;?]}¢'"、。〉》」』】〕〗〞︰︱︳﹐、﹒﹔﹕﹖﹗﹚﹜﹞! .&# &# ),.*:;O?|}︴︶︸︺︼︾﹀﹂﹄﹏、~¢々‖•·ˇˉ―--′’”([{£¥'"‵〈《「『【〔〖([{£¥〝︵︷︹︻︽︿﹁﹃﹙﹛﹝({“‘-—_…0123456789''')
4isNumber = re.compile(r'\d+.*')
5with open('stopwords.txt',encoding='utf-8',errors='ignore') as f:
6    stopwords = f.read()
7filter_words = [w for w in data_words if (w not in punct)
8                and (not isNumber.search(w.lower()))and(w not in stopwords)]
引入gensim库,并使用Word2Vec模型构造内部字典树,和训练神经模型:
1import gensim
2model = gensim.models.Word2Vec(iter=1)
3# an empty model, no training yet
4model.build_vocab(data_lines) #传入语料,构建内部字典树
5model.train(data_lines, total_examples = len(data_lines), epochs = 100)
6#开始训练神经模型100次
7#epochs表示训练次数
注意,上面这块代码也可换做下面这样的简写法:
1import gensim
2model = gensim.models.Word2Vec(data_lines,iter=10)
3'''
4直接把data_lines喂给World2Vec模型,
510代表会调用句子迭代器运行11次(一般来说,会运行 iter+1 次,默认情况下  iter=5)。
6第一次运行负责收集单词和它们的出现频率,从而构造一个内部字典树。第二次以及以后的运行负责训练神经模型(train)。
7'''
开始读入我们关心的人名、地名,并打印结果:
 1test_words = ['林黛玉','黛玉','贾宝玉','宝玉','薛宝钗','宝钗','袭人','大观园','潇湘馆','蘅芜苑','妙玉','栊翠庵']
 2#开始读入
 3neighbors = []
 4for test_word in test_words:
 5    neighbors.append(model.most_similar(test_word))
 6#开始打印结果
 7for i in range(len(neighbors)):
 8    str = ' '.join([x[0] for x in neighbors[i]])
 9    print('%s:' % test_words[i])
10    print('\t%s\n' % (str))
这里展示部分结果:(每个人名、地名之后跟的是与自己关系最密切/在100维词向量中最相近的名词)
最后我们看一下“黛玉”的坐标(100维),以及“黛玉”和“林黛玉”之间的相似度。
1print(model["黛玉"])
2print(model.similarity("黛玉",'林黛玉'))
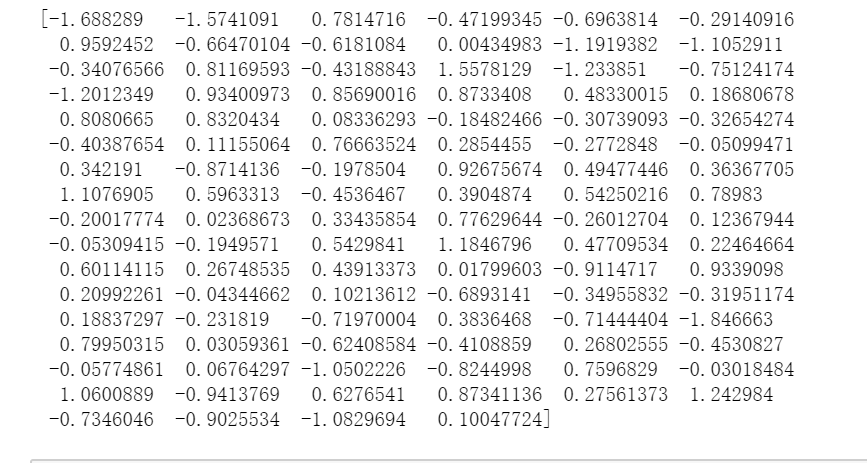
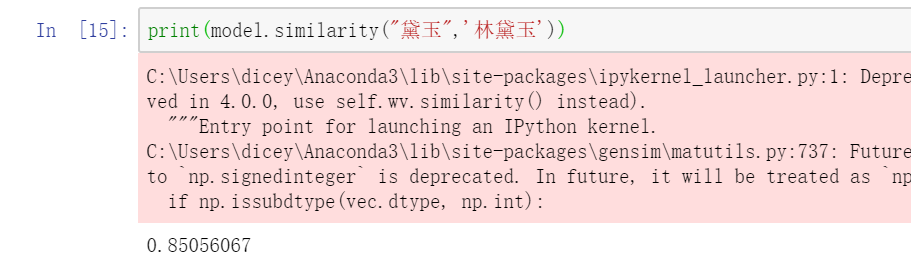
注意:相似度不为1(相似度等于1时代表词向量在每个维度上都完全相等)。是因为叫“林黛玉”时常为正式场合,直呼“黛玉”时一般属于日常情况,相信各位懂得~
用深度学习模型Word2Vec探索《红楼梦》人物关系的更多相关文章
- 红楼梦人物关系图,一代大师成绝响,下回分解待何人,kindle读书摘要
人物关系图: https://www.cnblogs.com/images/cnblogs_com/elesos/1120632/o_2033091006.jpg 红楼梦 (古典名著普及文库) ( ...
- PyTorch如何构建深度学习模型?
简介 每过一段时间,就会有一个深度学习库被开发,这些深度学习库往往可以改变深度学习领域的景观.Pytorch就是这样一个库. 在过去的一段时间里,我研究了Pytorch,我惊叹于它的操作简易.Pyto ...
- Apple的Core ML3简介——为iPhone构建深度学习模型(附代码)
概述 Apple的Core ML 3是一个为开发人员和程序员设计的工具,帮助程序员进入人工智能生态 你可以使用Core ML 3为iPhone构建机器学习和深度学习模型 在本文中,我们将为iPhone ...
- AI佳作解读系列(一)——深度学习模型训练痛点及解决方法
1 模型训练基本步骤 进入了AI领域,学习了手写字识别等几个demo后,就会发现深度学习模型训练是十分关键和有挑战性的.选定了网络结构后,深度学习训练过程基本大同小异,一般分为如下几个步骤 定义算法公 ...
- 『高性能模型』Roofline Model与深度学习模型的性能分析
转载自知乎:Roofline Model与深度学习模型的性能分析 在真实世界中,任何模型(例如 VGG / MobileNet 等)都必须依赖于具体的计算平台(例如CPU / GPU / ASIC 等 ...
- 深度学习模型stacking模型融合python代码,看了你就会使
话不多说,直接上代码 def stacking_first(train, train_y, test): savepath = './stack_op{}_dt{}_tfidf{}/'.format( ...
- 深度学习模型融合stacking
当你的深度学习模型变得很多时,选一个确定的模型也是一个头痛的问题.或者你可以把他们都用起来,就进行模型融合.我主要使用stacking和blend方法.先把代码贴出来,大家可以看一下. import ...
- 利用 TFLearn 快速搭建经典深度学习模型
利用 TFLearn 快速搭建经典深度学习模型 使用 TensorFlow 一个最大的好处是可以用各种运算符(Ops)灵活构建计算图,同时可以支持自定义运算符(见本公众号早期文章<Tenso ...
- Roofline Model与深度学习模型的性能分析
原文链接: https://zhuanlan.zhihu.com/p/34204282 最近在不同的计算平台上验证几种经典深度学习模型的训练和预测性能时,经常遇到模型的实际测试性能表现和自己计算出的复 ...
- 在NLP中深度学习模型何时需要树形结构?
在NLP中深度学习模型何时需要树形结构? 前段时间阅读了Jiwei Li等人[1]在EMNLP2015上发表的论文<When Are Tree Structures Necessary for ...
随机推荐
- LP1-5:常见BUG
一般常见的错误放在通用的代码里.错误判断就是if/else,太多影响性能,接口只需要加入必要的判断就好.
- Appium-TouchAction类与MultiAction类(控件元素的滑动、拖动,九宫格解锁,手势操作等)
文章转自:https://www.cnblogs.com/lfr0123/p/13679568.html swipe一般用于对页面进行上下左右滑动操作,但自动化过程中还会遇到其他情况,如对控件元素进行 ...
- virtualBox虚拟机中安装linux系统并连接
1.安装virtualBox 1.1.下载 virtualBox是免费的,直接去官网下载 https://www.virtualbox.org/ 在官网左侧找到Downloads,下载需要的版本 1. ...
- 2023 2 4 c++NOIP机试 小豫豫在郑州 type
1 #include <iostream> 2 #include <string> 3 using namespace std; 4 int j(string str){ 5 ...
- linux部署nacos集群
linux部署nacos集群 一.简介: 什么是Nacos Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service的首字母简称,一个更易于 ...
- unixbench测试CPU性能工具
UnixBench是一个类unix系(Unix,BSD,Linux)统下的性能测试工具,一个开源工具,被广泛用与测试linux系统主机的性能.Unixbench的主要测试项目有:系统调用.读写.进程. ...
- python菜鸟学习: 15 GUI界面化记事本
# -*- coding: utf-8 -*-import tkinter as tkdef getNewCreate(): passdef getCharcount1(sss): # 添加字数统 s ...
- TCP&UDP测试工具使用方式方法
第一项:测试TCP 步骤1:首先需要一台电脑上建立一个TCP服务器.并设置一个端口号如下图60003即可.并开启服务 步骤2:在另外一台电脑上,创建一个客户端连接,如下图.输入服务器的IP地址和端口号 ...
- eval()
s='12*2'd=eval(s)#字符串运算函数print(d) 结果: 24
- github 设置代理
1. 直接修改 .git/config 文件 注意: 仅对当前仓库有效, 推荐这种, 因为不是所有的仓库都需要走代理 [http "https://github.com"] pro ...