
我试了试用 SQL查 Linux日志,好用到飞起
大家好,我是小富~
最近发现点好玩的工具,迫不及待的想跟大家分享一下。
大家平时都怎么查Linux日志呢?
像我平时会用tail、head、cat、sed、more、less这些经典系统命令,或者awk这类三方数据过滤工具,配合起来查询效率很高。但在使用过程中有一点让我比较头疼,那就是命令参数规则太多了,记的人脑壳疼。
那查日志有没有一种通用的方式,比如用SQL查询,毕竟这是程序员都比较熟悉的表达式。
今天分享的工具q,就实现了以写SQL的方式来查询、统计文本内容,一起看看这货到底有什么神奇之处。
搭个环境
q是一个命令行工具,允许我们在任意文件或者查询结果,比如可以在ps -ef查询进程命令的结果集上,直接执行SQL语句查询。
宗旨就是文本即数据库表,额~,当然这句话是我自己理解的,哈哈哈
它将普通文件或者结果集当作数据库表,几乎支持所有的SQL结构,如WHERE、GROUP BY、JOINS等,支持自动列名和列类型检测,支持跨文件连接查询,这两个后边详细介绍,支持多种编码。
安装比较简单,在Linux CentOS环境,只要如下三步搞定,Windows环境更是只需安装个exe就可以用了。
wget https://github.com/harelba/q/releases/download/1.7.1/q-text-as-data-1.7.1-1.noarch.rpm #下载版本

sudo rpm -ivh q-text-as-data-1.7.1-1.noarch.rpm # 安装

q --version  #查看安装版本
语法
q支持所有SQLiteSQL语法,标准命令行格式q + 参数命令 + "SQL"
q <命令> "<SQL>"
我要查询myfile.log文件的内容,直接q "SELECT * FROM myfile.log"。
q "SELECT * FROM myfile.log"
q不附加参数使用是完全没有问题的,但利用参数会让显示结果更加美观,所以这里简单了解一下,它的参数分为 2种。
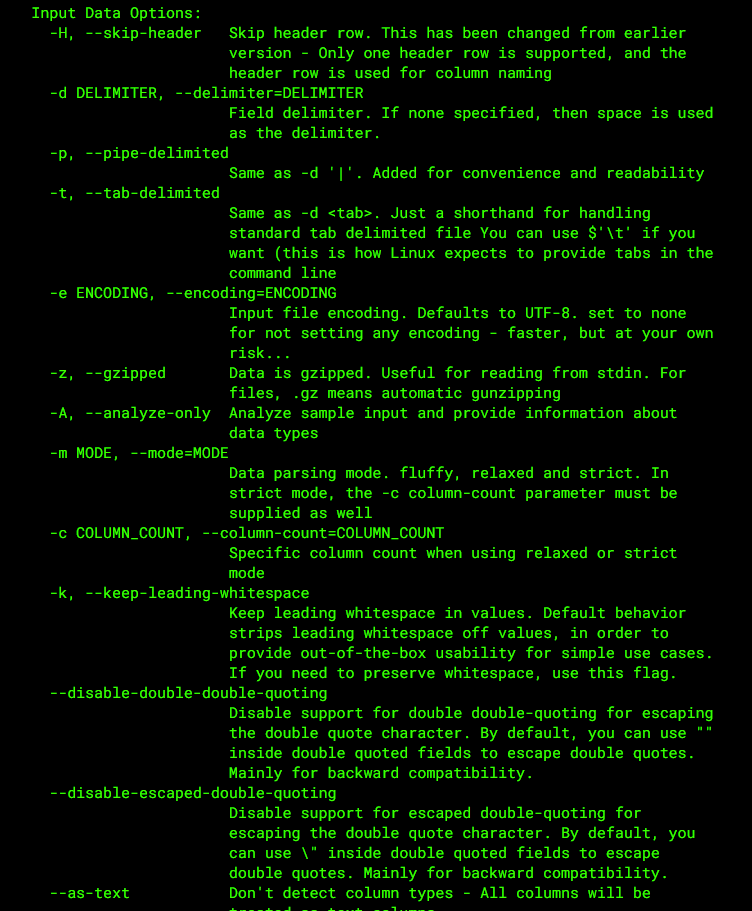
input输入命令:指的是对要查询的文件或结果集进行操作,比如:-H命令,表示输入的数据包含标题行。
q -H "SELECT * FROM myfile.log"
在这种情况下,将自动检测列名,并可在查询语句中使用。如果未提供此选项,则列将自动命名为cX,以c1起始以此类推。
q "select c1,c2 from ..."
output输出命令:作用在查询输出的结果集,比如:-O,让查询出来的结果显示列名。
[root@iZ2zebfzaequ90bdlz820sZ software]# ps -ef | q -H "select count(UID) from - where UID='root'"

104

[root@iZ2zebfzaequ90bdlz820sZ software]# ps -ef | q -H -O "select count(UID) from - where UID='root'"

count(UID)

104
还有很多参数就不一一列举了,感兴趣的同学在官网上看下,接下来我们重点演示一下使用SQL如何应对各种查询日志的场景。
玩法贼多
下边咱们一起看几个查询日志的经常场景中,这个SQL该如何写。
1、关键字查询
关键字检索,应该是日常开发使用最频繁的操作,不过我个人认为这一点q并没有什么优势,因为它查询时必须指定某一列。
[root@iZ2zebfzaequ90bdlz820sZ software]# q "select * from douyin.log where c9 like '%待解析%'"

2021-06-11 14:46:49.323 INFO 22790 --- [nio-8888-exec-2] c.x.douyin.controller.ParserController : 待解析URL :url=https%3A%2F%2Fv.douyin.com%2Fe9g9uJ6%2F

2021-06-11 14:57:31.938 INFO 22790 --- [nio-8888-exec-5] c.x.douyin.controller.ParserController : 待解析URL :url=https%3A%2F%2Fv.douyin.com%2Fe9pdhGP%2F

2021-06-11 15:23:48.004 INFO 22790 --- [nio-8888-exec-2] c.x.douyin.controller.ParserController : 待解析URL :url=https%3A%2F%2Fv.douyin.com%2Fe9pQjBR%2F

2021-06-11 2
而用grep命令则是全文检索。
[root@iZ2zebfzaequ90bdlz820sZ software]# cat douyin.log | grep '待解析URL'

2021-06-11 14:46:49.323  INFO 22790 --- [nio-8888-exec-2] c.x.douyin.controller.ParserController   : 待解析URL :url=https%3A%2F%2Fv.douyin.com%2Fe9g9uJ6%2F

2021-06-11 14:57:31.938  INFO 22790 --- [nio-8888-exec-5] c.x.douyin.controller.ParserController   : 待解析URL :url=https%3A%2F%2Fv.douyin.com%2Fe9pdhGP%2F
2、模糊查询
like模糊搜索,如果文本内容列有名字直接用列名检索,没有则直接根据列号c1、c2、cN。
[root@iZ2zebfzaequ90bdlz820sZ software]# cat test.log

abc

2

3

4

5

23

24

25

[root@iZ2zebfzaequ90bdlz820sZ software]# q -H -t "select * from test.log where abc like '%2%'"

Warning: column count is one - did you provide the correct delimiter?

2

23

24

25
3、交集并集
支持UNION和UNION ALL操作符对多个文件取交集或者并集。
如下建了test.log和test1.log两个文件,里边的内容有重叠,用union进行去重。
q -H -t "select * from test.log union select * from test1.log"

[root@iZ2zebfzaequ90bdlz820sZ software]# cat test.log

abc

2

3

4

5

[root@iZ2zebfzaequ90bdlz820sZ software]# cat test1.log

abc

3

4

5

6

[root@iZ2zebfzaequ90bdlz820sZ software]# q -H -t "select * from test.log union select * from test1.log"

Warning: column count is one - did you provide the correct delimiter?

Warning: column count is one - did you provide the correct delimiter?

2

3

4

5

6
4、内容去重
比如统计某个路径下的./clicks.csv文件中,uuid字段去重后出现的总个数。
q -H -t "SELECT COUNT(DISTINCT(uuid)) FROM ./clicks.csv"
5、列类型自动检测
注意:q会理解每列是数字还是字符串,判断是根据实数值比较,还是字符串比较进行过滤,这里会用到-t命令。
q -H -t "SELECT request_id,score FROM ./clicks.csv WHERE score > 0.7 ORDER BY score DESC LIMIT 5"
6、字段运算
读取系统命令查询结果,计算/tmp目录中每个用户和组的总值。可以对字段进行运算处理。
sudo find /tmp -ls | q "SELECT c5,c6,sum(c7)/1024.0/1024 AS total FROM - GROUP BY c5,c6 ORDER BY total desc"

[root@iZ2zebfzaequ90bdlz820sZ software]# sudo find /tmp -ls | q "SELECT c5,c6,sum(c7)/1024.0/1024 AS total FROM - GROUP BY c5,c6 ORDER BY total desc"

www www 8.86311340332

root root 0.207922935486

mysql mysql 4.76837158203e-06
7、数据统计
统计系统拥有最多进程数的前 3个用户ID,按降序排序,这就需要和系统命令配合使用了,先查询所有进程再利用SQL筛选,这里的q命令就相当grep命令。
ps -ef | q -H "SELECT UID,COUNT(*) cnt FROM - GROUP BY UID ORDER BY cnt DESC LIMIT 3"

[root@iZ2zebfzaequ90bdlz820sZ software]# ps -ef | q -H "SELECT UID,COUNT(*) cnt FROM - GROUP BY UID ORDER BY cnt DESC LIMIT 3"

root 104

www 16

rabbitmq 4

[root@iZ2zebfzaequ90bdlz820sZ software]# ps -ef | q -H -O "SELECT UID,COUNT(*) cnt FROM - GROUP BY UID ORDER BY cnt DESC LIMIT 3"

UID cnt

root 110

www 16

rabbitmq 4
我们看到加与不加-O命令的区别就是否显示查询结果的标题。
8,连文件查
一般情况下,我们的日志文件会按天分割成很多个固定容量的子文件,在没有统一的日志收集服务器的情况下,如果不给个报错时间区间去查一个关键词,那么无异于大海捞针。
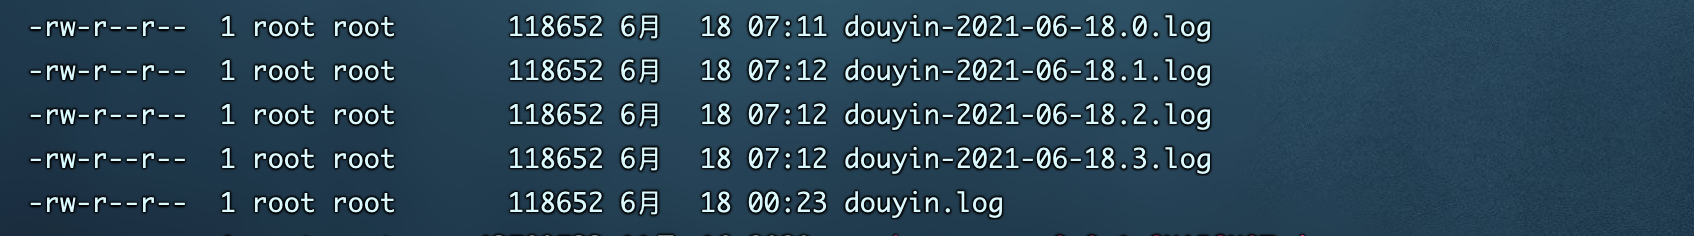
如果可以将所有文件内容合并后在查就会省事很多,q支持将文件像数据库表那样联合查询。
q -H "select * from douyin.log a join douyin-2021-06-18.0.log b on (a.c2=b.c3) where b.c1='root'"
总结
看完可能会有人抬杠:q写这么多代码直接用awk不香吗?额~ 介绍这个工具的初衷并不是说要替换现有哪种工具,而是多提供一种更为便捷的查日志方法。
我也有在用awk确实很强大没得说,但这里边涉及到一个学习成本的问题,琳琅满目的命令、匹配规则想玩转还是要下点功夫的。而对于新手程序员稍微有点数据库经验,写SQL问题都不大,上手q则会容易的多。
整理了几百本各类技术电子书,送给小伙伴们。关注公号回复【666】自行领取。和一些小伙伴们建了一个技术交流群,一起探讨技术、分享技术资料,旨在共同学习进步,如果感兴趣就加入我们吧!
我试了试用 SQL查 Linux日志,好用到飞起的更多相关文章
- linux日志文件
linux日志文件 在系统运行正常的情况下学习了解这些不同的日志文件有助于你在遇到紧急情况时从容找出问题并加以解决. /var/log/messages — 包括整体系统信息,其中也包含系统启动期间的 ...
- 《Unix/Linux日志分析与流量监控》书稿完成
<Unix/Linux日志分析与流量监控>书稿完成 近日,历时3年创作的75万字书稿已完成,本书紧紧围绕网络安全的主题,对各种Unix/Linux系统及网络服务日志进行了全面系统的讲解,从 ...
- <1>Linux日志查找方法
Linux日志查找方法 适用于测试,开发,运维人员,用来查找Linux服务器问题的一般方法,比较实用,如果有更好的办法可以一块讨论,欢迎大神们来指导哈!!! 进入正题 第一步.通过Xshell登录服务 ...
- Linux—日志查看(测试人员)
备注:在筛选语句后面加“--col”可以高亮显示查询结果中的关键字 cd /home/admin/logs/服务器名 #进入日志目录(错误日志文件:common-error.log),路径因公司而定 ...
- 位于/var/log目录下的20个Linux日志文件
位于/var/log目录下的20个Linux日志文件[译] from:http://buptguo.com/2014/01/16/linux-var-log-files/ 原文地址:20 Linux ...
- Linux日志分析的实战专题
来自 日志也是用户应该注意的地方之一.不要低估日志文件对网络安全的重要作用,因为日志文件能够详细记录系统每天发生的各种各样的事件.用户可以通过日志文件 检查错误产生的原因,或者在受到攻击和黑客入侵 ...
- linux日志查询技巧
问题描述: 18803959896用户反馈,通讯录备份失败,提示“身份验证失败,请注销账号后重新登录”,不管用账号密码登录还是一键登录,都是提示这个.请协助查询.谢谢~ 备注:三星note3最新版本彩 ...
- Linux日志查看
Linux日志查看: 1.Last -a 把从何处登入系统的主机名称或IP地址,显示在最后一行.-d 指定记录文件.指定记录文件.将IP地址转换成主机名称.-f <记录文件> 指定记录文 ...
- Linux日志管理系统rsyslog
一.日志的概念 什么是日志?日志就是历史事件.历史事件包括时间.地点.人物.时间.这个是生活中所说的日志很好理解.在Linux中也有类似的服务,它主要作用就是记录Linux系统的历史事件,包括什么时间 ...
随机推荐
- ThinkPHP5查询-select与find理解
出现问题 在tp5框架中判断select查询结果是否为空时,无论查询条件是否满足,判断查询结果都不为空 解析问题 select查询的是多条数据,若查询数据为空,则返回一个空的二维数组 array(ar ...
- Govern EventBus - 历经多年生产环境验证的事件驱动架构框架
Govern EventBus Govern EventBus 是一个历经四年生产环境验证的事件驱动架构框架, 通过事件总线机制来治理微服务间的远程过程调用. 使用本地事务来支持微服务内强一致性,事件 ...
- Unity API笔记
1. 返回某范围的随机数 Random.Range method. static float Range(float min, float max); returns a float – return ...
- 二分查找确定lower_bound和upper_bound
lower_bound当target存在时, 返回它出现的第一个位置,如果不存在,则返回这样一个下标i:在此处插入target后,序列仍然有序. 代码如下: int lower_bound(int* ...
- 面试 CSS篇清除浮动及display:inline-block
一. 在div使用display:inline-block时,HTML代码中的回车换行键会被转化为一个空白符 如图 <style type="text/css"> *{ ...
- (Dubbo架构)基于MDC+Filter的跨应用分布式日志追踪解决方案
在单体应用中,日志追踪通常的解决方案是给日志添加 tranID(追踪ID),生成规则因系统而异,大致效果如下: 查询时只要使用 grep 命令进行追踪id筛选即可查到此次调用链中所有日志,但是在 du ...
- 在/etc/profile下配置java的环境变量
在/etc/profile下配置java的环境变量 原创 Java 作者:xiaoyan5686670 时间:2016-01-18 14:30:28 6152 0 以root用户编辑:#vi /e ...
- mysql 配置文件概述
mysql 配置文件概述 mysql 配置文件 mysql 的配置文件为 /etc/my.cnf 配置文件查找次序:若在多个配置文件中均有设定,则最后找到的最终生效 /etc/my.cnf --> ...
- linux系统的负载详解
系统的平均负载 如何理解平均负载 单位时间内,系统处于可运行状态和不可中断状态的平均进程数,也就是平均活跃进程数. 平均负载多少合理 核心数 平均负载 含义 4 2 有50%的cpu是空闲状态,见 ...
- IDEA workspace.xml 在 git 中无法忽略 ignore 问题
问题描述 关于 .idea 的文件夹中的 workspace.xml 设置 ignore 之后每次 commit 依旧提示需要提交改变,这就会导致, 每次merge就会导致提示"本地文件改变 ...