
Python爬虫之lxml-etree和xpath的结合使用
本篇文章给大家介绍的是Python爬虫之lxml-etree和xpath的结合使用(附案例),内容很详细,希望可以帮助到大家。
lxml:python的HTML / XML的解析器
官网文档:https://lxml.de/
使用前需要安装lxml包
终端输入(win7.8,10在cmd输入)pip install -i https://pypi.tuna.tsinghua.edu.cn/simple lxml
功能:
1 解析html:使用etree.html(text)将字符串格式的 html片段解析成 html 文档
2 读取xml文件
3 etree和xpath配合使用(本文主要介绍)
示例:etree和xpath配合使用
# lxml-etree读取文件from lxml import etree

xml = etree.parse("./py24.xml")

print(type(xml))# 查找所有 book 节点rst = xml.xpath('//book')

print(type(rst))

print(rst)# 查找带有 category 属性值为 sport 的元素rst2 = xml.xpath('//book[@category="sport"]')

print(type(rst2))

print(rst2)# 查找带有category属性值为sport的元素的book元素下到的year元素rst3 = xml.xpath('//book[@category="sport"]/year')

rst3 = rst3[0]

print('-------------\n',type(rst3))

print(rst3.tag)

print(rst3.text)
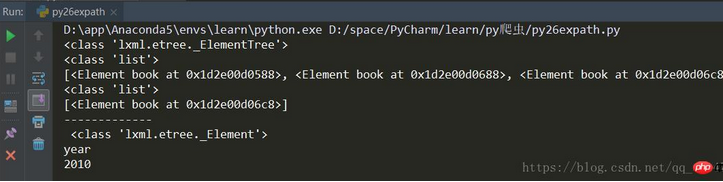
结果:
示例:使用lxml解析html代码
# 先安装lxml

# 用 lxml 来解析HTML代码

from lxml import etree

text = '''<p>

    <ul>

        <li class="item-0"><a href="0.html">item 0 </a></li>

        <li class="item-1"><a href="1.html">item 1 </a></li>

        <li class="item-2"><a href="2.html">item 2 </a></li>

        <li class="item-3"><a href="3.html">item 3 </a></li>

        <li class="item-4"><a href="4.html">item 4 </a></li>

        <li class="item-5"><a href="5.html">item 5 </a></li>

    </ul>     </p>'''

# 利用 etree.HTML 把字符串解析成 HTML 文件

html = etree.HTML(text)

s = etree.tostring(html).decode()

print(s)
结果:

示例:读取xml文件
# lxml-etree读取文件from lxml import etree

xml = etree.parse("./py24.xml")

sxml = etree.tostring(xml, pretty_print=True)

print(sxml)
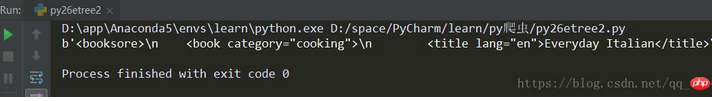
结果:
Python爬虫之lxml-etree和xpath的结合使用的更多相关文章
- 小白学 Python 爬虫(20):Xpath 进阶
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 小白学 Python 爬虫(19):Xpath 基操
人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Li ...
- 爬虫之lxml - etree - xpath的使用
# 解析原理: # - 获取页面源码数据 # - 实例化一个etree对象,并且将页面源码数据加载到该对象中 # - 调用该对象的xpath方法进行指定标签定位 # - xpath函数必须结合着xpa ...
- python爬虫入门(三)XPATH和BeautifulSoup4
XML和XPATH 用正则处理HTML文档很麻烦,我们可以先将 HTML文件 转换成 XML文档,然后用 XPath 查找 HTML 节点或元素. XML 指可扩展标记语言(EXtensible Ma ...
- Python 爬虫 解析库的使用 --- XPath
一.使用XPath XPath ,全称XML Path Language,即XML路径语言,它是一门在XML文档中查找信息的语言.它最初是用来搜寻XML文档的,但是它同样适用于HTML文档的搜索. 所 ...
- Python爬虫——使用 lxml 解析器爬取汽车之家二手车信息
本次爬虫的目标是汽车之家的二手车销售信息,范围是全国,不过很可惜,汽车之家只显示100页信息,每页48条,也就是说最多只能够爬取4800条信息. 由于这次爬虫的主要目的是使用lxml解析器,所以在信息 ...
- Python爬虫使用lxml模块爬取豆瓣读书排行榜并分析
上次使用了BeautifulSoup库爬取电影排行榜,爬取相对来说有点麻烦,爬取的速度也较慢.本次使用的lxml库,我个人是最喜欢的,爬取的语法很简单,爬取速度也快. 本次爬取的豆瓣书籍排行榜的首页地 ...
- python爬虫三大解析库之XPath解析库通俗易懂详讲
目录 使用XPath解析库 @(这里写自定义目录标题) 使用XPath解析库 1.简介 XPath(全称XML Path Languang),即XML路径语言,是一种在XML文档中查找信息的语言. ...
- Python爬虫:数据解析 之 xpath
资料: W3C标准:https://www.w3.org/TR/xpath/all/ W3School:https://www.w3school.com.cn/xpath/index.asp 菜鸟教程 ...
- Python爬虫教程-22-lxml-etree和xpath配合使用
Python爬虫教程-22-lxml-etree和xpath配合使用 lxml:python 的HTML/XML的解析器 官网文档:https://lxml.de/ 使用前,需要安装安 lxml 包 ...
随机推荐
- Shiro安全框架「快速入门」就这一篇
Shiro 简介 照例又去官网扒了扒介绍: Apache Shiro is a powerful and easy-to-use Java security framework that perfor ...
- Maven的详细下载、安装及配置(亲测)
一.下载 官网下载地址:https://maven.apache.org/download.cgi 选择安装包进行下载,如图: 下载后,对压缩包进行解压 二.安装 确认电脑已安装好JDK 2.配置环境 ...
- 仅使用JsonUtility && File类实现Json数据读写
using System.Collections; using System.Collections.Generic; using UnityEngine; using System; using S ...
- Netty 框架学习 —— 添加 WebSocket 支持
WebSocket 简介 WebSocket 协议是完全重新设计的协议,旨在为 Web 上的双向数据传输问题提供一个切实可行的解决方案,使得客户端和服务器之间可以在任意时刻传输消息 Netty 对于 ...
- POJ 2826 An Easy Problem? 判断线段相交
POJ 2826 An Easy Problem?! -- 思路来自kuangbin博客 下面三种情况比较特殊,特别是第三种 G++怎么交都是WA,同样的代码C++A了 #include <io ...
- 尝试用面向对象思维理解Vue组件
什么是组件 用面向对象的思维去理解Vue组件,可以将所有的事物都抽象为对象,而类或者说是组件,都具有属性和操作. 如抽取人类为组件,其基本的属性有姓名.年龄.国籍:基本的方法有吃饭.睡觉.跑步等. & ...
- Docker:Linux离线安装docker
docker离线下载路径 docker所有版本:https://download.docker.com/linux/static/stable/ 离线安装 1.解压 #解压tar包 tar -xvf ...
- 合并N个长度为M的有序数组为一个N*M的有序数组
题目:合并N个有序数组,每个数组的长度为M,合并为N*M的有序数组.时间复杂度要求最低 解法:N个数组进行两两合并,合并后的数组再继续执行合并过程,最后合成N*M的有序数组.可以认为合并这个递归过程发 ...
- 25 Linux中的信号
Linux中的信号 信号是进程在运行过程中,由自身产生或由进程外部发过来的消息(事件).每个信号用一个整型常量宏表示,以SIG开头,比如SIGCHLD.SIGINT等,它们在系统头文件中定义,也可以通 ...
- diff -u:内核开发的新项目
译至:http://www.linuxjournal.com/content/diff-u-whats-new-kernel-development-1 Linux的一个问题是它的系统调用实现 . 正 ...