
12、基于yarn的提交模式
一、三种提交模式
1、Spark内核架构,其实就是第一种模式,standalone模式,基于Spark自己的Master-Worker集群。

2、第二种,是基于YARN的yarn-cluster模式。

3、第三种,是基于YARN的yarn-client模式。

4、如果,你要切换到第二种和第三种模式,很简单,将我们之前用于提交spark应用程序的spark-submit脚本,加上--master参数,设置为yarn-cluster,或yarn-client,即可。

  如果你没设置,那么,就是standalone模式。
二、基于YARN的提交模式
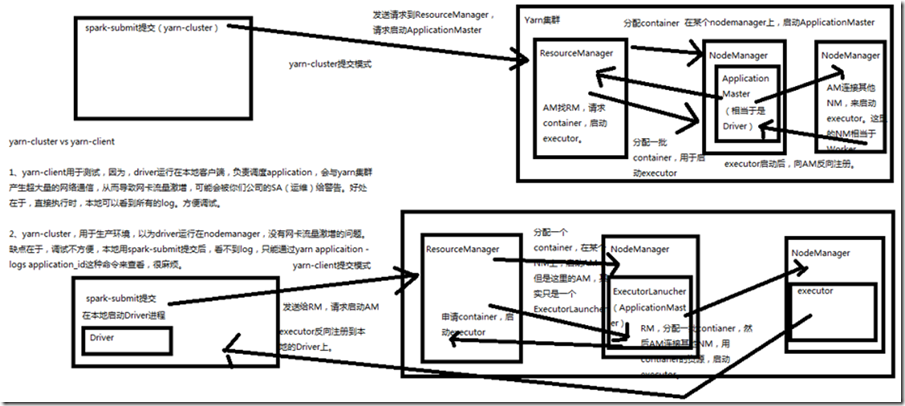
1、基于YARN的yarn-cluster模式
流程详细分析:

spark-submit提交(yarn-cluster),发送请求到ResourceManager,请求启动ApplicationMaster,ResourceManager接收到请求后,会在某个NodeManager上分配container,启动ApplicationMaster

ResourceManager分配Container,在某个NodeManager上,启动ApplicationMaster

ApplicationMaster(相当于是Driver)

ApplicationMaster找ResourceManager,请求container,启动Executor

ResourceManager分配一批container,用于启动Executor

ApplicationMaster所在的NodeManager上,可能会启动Executor

ApplicationMaster连接其他NodeManager,来启动Executor,这里的NameNode相当于Wroker

Executor启动后,向ApplicationMaster反向注册
2、基于YARN的yarn-client模式
流程详细分析:

spark-submit提交(yarn-client),会在本地启动Driver进程

发送给ResourceManager,请求启动ApplicationMaster

ResourceManager分配Container,在某个NodeManager上启动ApplicationMaster,但这里的ApplicationMaster,其实只是一个ExecutorLauncher

ExecutorLauncher(ApplicationMaster)申请Container,启动executor

ResourceManager分配一批Container

,ExecutorLauncher(ApplicationMaster)所在的NodeManager上,可能会启动Executor

ExecutorLauncher(ApplicationMaster)连接其他NodeManager,用Container资源,启动Executor

Executor反向注册到本地的Driver上
3、以上两种模式对比
1、yarn-client模式用于测试,因为driver运行在本地客户端,负责调度application,会与yarn集群产生超大量的网络通信,从而导致网卡流量激增,

可能会被公司的运维给警告,好处在于,直接执行时,本地可以看到所有log,方便调试

2、

yarn-cluster,用于生产环境,因为driver运行在NodeManager,没有网卡流量激增的问题,缺点在于,调试不方便,本地用spark-submit提交后,看不到log,

只能通过yarn application -logs application_id这种命令来查看,很麻烦
4、设置
##修改spark-env.sh

[root@spark1 ~]# vim /usr/local/spark/conf/spark-env.sh        #写入hadoop的home

export HADOOP_HOME=/usr/local/hadoop

###脚本文件

yarn-cluster:

/opt/module/spark/bin/spark-submit \

--class com.zj.spark.core.WordCountCluster \

--master yarn-cluster \

--num-executors 3 \

--driver-memory 100m \

--executor-memory 100m \

--executor-cores 3 \

/opt/module/datas/sparkstudy/java/mysparkstudy-1.0-SNAPSHOT-jar-with-dependencies.jar \

yarn-client:

/opt/module/spark/bin/spark-submit \

--class com.zj.spark.core.WordCountCluster \

--master yarn-client \

--num-executors 3 \

--driver-memory 100m \

--executor-memory 100m \

--executor-cores 3 \

/opt/module/datas/sparkstudy/java/mysparkstudy-1.0-SNAPSHOT-jar-with-dependencies.jar \
12、基于yarn的提交模式的更多相关文章
- spark基于yarn的两种提交模式
一.spark的三种提交模式 1.第一种,Spark内核架构,即standalone模式,基于Spark自己的Master-Worker集群. 2.第二种,基于YARN的yarn-cluster模式. ...
- Spark剖析-宽依赖与窄依赖、基于yarn的两种提交模式、sparkcontext原理剖析
Spark剖析-宽依赖与窄依赖.基于yarn的两种提交模式.sparkcontext原理剖析 一.宽依赖与窄依赖 二.基于yarn的两种提交模式深度剖析 2.1 Standalne-client 2. ...
- Spark运行模式_基于YARN的Resource Manager的Custer模式(集群)
使用如下命令执行应用程序: 和"基于YARN的Resource Manager的Client模式(集群)"运行模式,区别如下: 在Resource Manager端提交应用程序,会 ...
- Flink源码阅读(一)——Flink on Yarn的Per-job模式源码简析
一.前言 个人感觉学习Flink其实最不应该错过的博文是Flink社区的博文系列,里面的文章是不会让人失望的.强烈安利:https://ververica.cn/developers-resource ...
- 基于事件的异步模式(EAP)
什么是EAP异步编程模式 EAP基于事件的异步模式是.net 2.0提出来的,实现了基于事件的异步模式的类将具有一个或者多个以Async为后缀的方法和对应的Completed事件,并且这些类都支持异步 ...
- Entity Framework 实体框架的形成之旅--基于泛型的仓储模式的实体框架(1)
很久没有写博客了,一些读者也经常问问一些问题,不过最近我确实也很忙,除了处理日常工作外,平常主要的时间也花在了继续研究微软的实体框架(EntityFramework)方面了.这个实体框架加入了很多特性 ...
- Event-based Asynchronous Pattern Overview基于事件的异步模式概览
https://msdn.microsoft.com/zh-cn/library/wewwczdw(v=vs.110).aspx Applications that perform many task ...
- 基于Java 生产者消费者模式(详细分析)
Java 生产者消费者模式详细分析 本文目录:1.等待.唤醒机制的原理2.Lock和Condition3.单生产者单消费者模式4.使用Lock和Condition实现单生产单消费模式5.多生产多消费模 ...
- spark提交模式
spark基本的提交语句: ./bin/spark-submit \ --class <main-class> \ --master <master-url> \ --depl ...
随机推荐
- Linux实现MYSQl数据库的定时备份
今天给大家分享一下如何在Linux下实现MYSQl数据库的定时备份. 前提需要保证你的Linux服务器已经安装了MYSQl数据库服务. 1.创建shell脚本 vim backupdb.sh 创建脚本 ...
- Abp session和Cookie
问道 面向Abp 在面向服务的时候,Session 干嘛用? 先把Session 的作用说了,但是在微服务环境下给忽略了,相当于忽略了核心. Session 只是个功能.就是根据Cookie 的Ses ...
- iOS - Xcode中从动态库剥离不需要的架构
自从iOS 8发布以来,开发人员已经能够利用动态库对iOS开发的好处.对于一般开发,为所有需要的架构设置一个单一的动态库是非常好的,所以您可以在所有设备和iOS模拟器上运行,而无需更改任何东西.然而, ...
- MonoSymbolFileException in CheckLineNumberTable
Mono.CompilerServices.SymbolWriter.MonoSymbolFileException: Exception of type 'Mono.CompilerServices ...
- 为什么Java中一个char能存下一个汉字
在Java中,char的长度是2字节,即16位,2的16次方是65536. 1.如果采用utf-8编码,一个汉字占3个字节,char为什么还能存下一个汉字呢? 参考:https://developer ...
- Qt 接受拖放
第一步:在构造函数里面 添加拖放支持,相当于总开关(注意这里设置之后是整个窗口可以接受拖放) setAcceptDrops(true); 第二步:重写接受拖放相关的虚函数 void dragEnter ...
- xadmin 配置内置User模型
xadmin 配置内置USER模型 默认展示 在你的User模型对应的app下创建adminx 文件 import xadmin from django.contrib.auth import get ...
- SQL SERVER-Alwayson原理
流程 1.异步提交模式 主副本无须确认该副本已经完成日志固化,就可提交事务. 主副本不受辅助副本的影响 辅助副本上的DB处于SYNCHRONIZING 2.同步提交模式 主副本要确认副本已经完成日志固 ...
- 批处理引擎MapReduce内部原理
批处理引擎MapReduce内部原理 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.MapReduce作业生命周期 MapReduce作业作为一种分布式应用程序,可直接运行在H ...
- Java 十大排序算法
目录: 1.冒泡排序(Bubble Sort) 2.选择排序(Selection Sort) 3.插入排序(Insertion Sort) 4.希尔排序(Shell Sort) 5.归并排序(Merg ...