
MapReduce Join的使用
一、Map端Join
可连接两个都非常大的数据集之间可使用map端连接,数据在到达map端之前就执行连接操作。
需满足:
两个要连接的数据集都先划分成相同数量的分区,相同的key要保证在同一分区中(每个分区中两个数据集数据量不一定要要相同), 并且要 按连接key排序;
利用CompositeInputFormat类,可实现map端连接:
代码参考:GitHub上Join示例
其它参考:hadoop实现join (CompositeInputFormat)
二、Reduce端连接
Reduce端连接更简单易用,以天气连接为例:
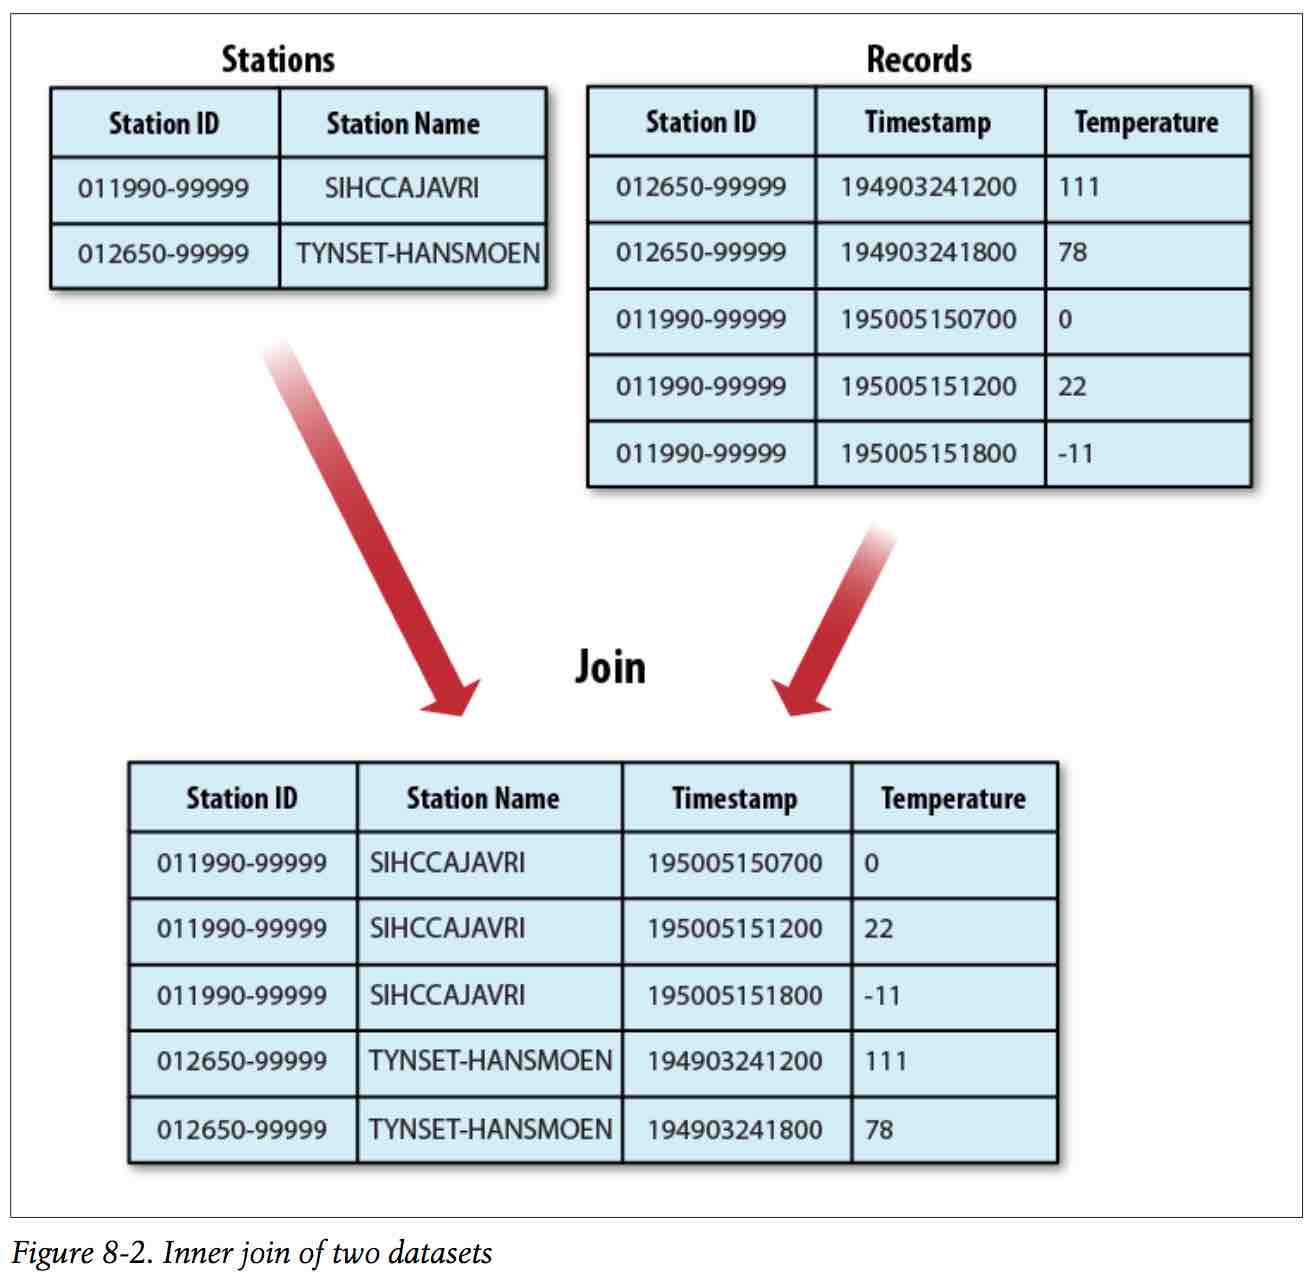
使用步骤:
1、使用MutipleInputs类设定不同输入数据集的InputFormat,以及Mapper;
2、辅助排序:通过自定义一个WritableComparable类型的 T,添加一个辅助排序字段,重写compareTo()方法,
作为传入Reducer的key,可完成可控的二次排序;
3、自定义Partitioner类,保证以自定义WritableComparable类型的T以首字段进行分区;自定一个分组Comparator类;
job.setPartitionerClass(KeyPartitioner.class);

job.setGroupingComparatorClass(TextPair.FirstComparator.class);
自定义Partitioner类、Comparator:
public static class KeyPartitioner extends Partitioner<TextPair, Text> {

    @Override

    public int getPartition(TextPair key, Text value, int numPartitions) {

        return (key.getFirst().hashCode() & Integer.MAX_VALUE) % numPartitions;

    }

}

public static class FirstComparator extends WritableComparator {

    private static final Text.Comparator TEXT_COMPARATOR = new Text.Comparator();

    public FirstComparator() {

        super(TextPair.class);

    }

    @Override

    public int compare(byte[] b1, int s1, int l1, byte[] b2, int s2, int l2) {

        try {

            int firstL1 = WritableUtils.decodeVIntSize(b1[s1]) + readVInt(b1, s1);

            int firstL2 = WritableUtils.decodeVIntSize(b2[s2]) + readVInt(b2, s2);

            return TEXT_COMPARATOR.compare(b1, s1, firstL1, b2, s2, firstL2);

        } catch (IOException e) {

            throw new IllegalArgumentException(e);

        }

    }

    @Override

    public int compare(WritableComparable a, WritableComparable b) {

        if (a instanceof TextPair && b instanceof TextPair) {

            return ((TextPair) a).first.compareTo(((TextPair) b).first);

        }

        return super.compare(a, b);

    }

}
3、在Reducer中把选到达的key提取出来,即可自定义完成Join操作;
三、使用分布式缓存来实现:
其它参考:MapReduce 中的两表 join 几种方案简介
MapReduce Join的使用的更多相关文章
- mapreduce join
MapReduce Join 对两份数据data1和data2进行关键词连接是一个很通用的问题,如果数据量比较小,可以在内存中完成连接. 如果数据量比较大,在内存进行连接操会发生OOM.mapredu ...
- SQL join中级篇--hive中 mapreduce join方法分析
1. 概述. 本文主要介绍了mapreduce框架上如何实现两表JOIN. 2. 常见的join方法介绍 假设要进行join的数据分别来自File1和File2. 2.1 reduce side jo ...
- MapReduce Join关联
Reduce join 原理 Map端的主要工作:为来自不同表(文件)的key/value对打标签以区别不同来源的记录.然后用连接字段作为key,其余部分和新加的标志作为value,最后进行输出. R ...
- mapreduce join操作
上次和朋友讨论到mapreduce,join应该发生在map端,理由太想当然到sql里面的执行过程了 wheremap端 join在map之前(笛卡尔积),但实际上网上看了,mapreduce的笛卡尔 ...
- Hadoop.2.x_高级应用_二次排序及MapReduce端join
一.对于二次排序案例部分理解 1. 分析需求(首先对第一个字段排序,然后在对第二个字段排序) 杂乱的原始数据 排序完成的数据 a,1 a,1 b,1 a,2 a,2 [排序] a,100 b,6 == ...
- MapReduce实现的Join
MapReduce Join 对两份数据data1和data2进行关键词连接是一个很通用的问题,如果数据量比较小,可以在内存中完成连接. 如果数据量比较大,在内存进行连接操会发生OOM.mapredu ...
- MapReduce中的Join算法
在关系型数据库中Join是非常常见的操作,各种优化手段已经到了极致.在海量数据的环境下,不可避免的也会碰到这种类型的需求,例如在数据分析时需要从不同的数据源中获取数据.不同于传统的单机模式,在分布式存 ...
- 大数据mapreduce俩表join之python实现
二次排序 在Hadoop中,默认情况下是按照key进行排序,如果要按照value进行排序怎么办?即:对于同一个key,reduce函数接收到的value list是按照value排序的.这种应用需求在 ...
- Hadoop学习之路(二十一)MapReduce实现Reduce Join(多个文件联合查询)
MapReduce Join 对两份数据data1和data2进行关键词连接是一个很通用的问题,如果数据量比较小,可以在内存中完成连接. 如果数据量比较大,在内存进行连接操会发生OOM.mapredu ...
随机推荐
- bzoj3196 二逼平衡树 树套树(线段树套Treap)
Tyvj 1730 二逼平衡树 Time Limit: 10 Sec Memory Limit: 128 MBSubmit: 4697 Solved: 1798[Submit][Status][D ...
- NCCloud 指令示例
http://ansrlab.cse.cuhk.edu.hk/software/nccloud/ Implementation of NCCloud in C++ (updated: August 2 ...
- SLF4J 简单日志门面 介绍和使用
参考:http://singleant.iteye.com/blog/934593 http://liuzidong.iteye.com/blog/776072 介绍: 简单日记门面(s ...
- CSGO
CSGO Time Limit: 4000/2000 MS (Java/Others) Memory Limit: 524288/524288 K (Java/Others) Problem D ...
- css-包含块
在CSS中,有事一个元素的位置和尺寸的计算都相对于一个矩形,这个矩形被称作包含块.包含块是一个相对的概念,比如 子元素的初始化布局总是在父元素的左上角,这就是一个相对的概念.其中父元素就是一个参照物, ...
- POJ 2185 Milking Grid [二维KMP next数组]
传送门 直接转田神的了: Milking Grid Time Limit: 3000MS Memory Limit: 65536K Total Submissions: 6665 Accept ...
- Java 并发编程中的 CyclicBarrier 用于一组线程互相等待
Java 5 引入的 Concurrent 并发库软件包中的 CyclicBarrier 是一个同步辅助类,它允许一组线程互相等待,直到到达某个公共屏障点 (common barrier point) ...
- sulime text 常用快捷键总结
Sublime Text 3汉化中文版主要特色: -语法高亮.代码提示补全.代码折叠.自定义皮肤/配色方案.多便签 -代码地图.多种界面布局与全屏免打扰模式 -完全开放的用户自定义配置与神奇实用的编辑 ...
- Idea配置Tomcat以及maven
配置Tamcat Run-->Edit Configurations +-->如果列表里没有tomcat-->点击33 items more irrelevant继续寻找--> ...
- codevs——1501 二叉树最大宽度和高度
1501 二叉树最大宽度和高度 时间限制: 1 s 空间限制: 128000 KB 题目等级 : 白银 Silver 题解 题目描述 Description 给出一个二叉树,输出它的 ...