
python爬虫requests模块
requests库的七个主要方法
1. requests.requests(method, url, **kwargs)
构造一个请求,支撑以下各方法的基础方法
method:请求方式,对应get/put/post等七中方法;
url:拟获取页面的url链接;
**kwargs:控制访问的参数,共13个;
method:请求方式
GET:请求获取url位置的资源;
HEAD:获得该资源的头部信息;
POST:请求向url位置的资源后附加新的数据;
PUT:请求向url位置存储一个资源,覆盖原url位置的资源;
PATCH:请求局部更新url位置的资源,即改变该处资源的部分内容;
DELETE:请求删除url位置存储的资源;
**kwargs:控制访问的参数,均为可选
params:字典或字节序列,作为参数增加到url中;
data:字典,字节序列或文件对象,作为Requests的内容;
json:Json格式的数据,作为Requests的内容;
headers:字典,HTTP定制头;
cookies:字典或cookiejar,Requests中的cookie;
auth:元组,支持HTTP认证功能;
files:字典类型,传输文件;
timeout:设定超超时时间,秒为单位;
proxies:字典类型,设定访问代理服务器,可以增加登记认证;
allow_redirests:True/Flase,默认为True,重定向开关;
stream:True/False,默认为True,获取内容立即下载开关;
verify:True/False,默认为True,认证SSL证书开关;
cert:本地SSL证书路径;
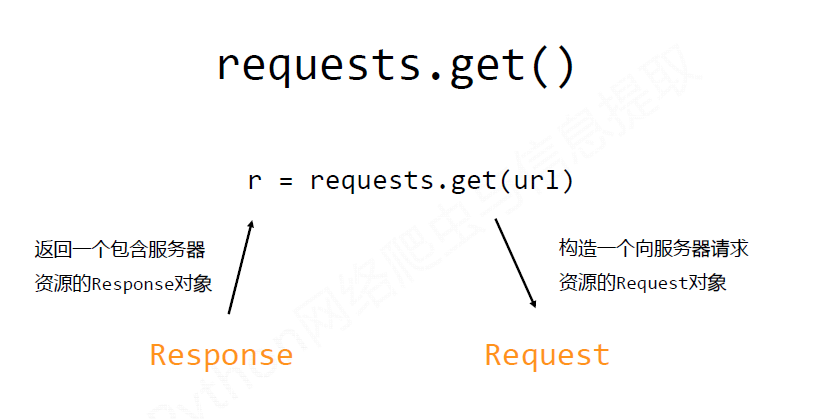
2. request.get(url, params=None, **kwargs)
获取HTML网页的主要方法,对应HTTP的GET;
params:url中额外参数,字典或字节流格式,可选;
**kwargs:12个控制访问参数;
3.requests.head(url, **kwargs)
获取HTML网页头信息方法,对应HTTP的HEAD;
**kwarge:12个控制访问参数;
4.requests.post(url, data=None, json=None, **kwargs)
向HTML网页提交post请求的方法,对应HTTP的POST;
data;字典、字节序列或文件,Requests的内容;
json:Json格式的数据,Requests的内容;
**kwargs:12个控制访问参数;
5.requests.put(url, data=None, **kwargs)
向HTML网页提交PUT请求方法,对应HTTP的PUT;
data:字典、字节序列或文件,Requests的内容;
**kwargs:12个控制访问参数;
6. requests.patch(url, data=None, **kwargs)
向HTML页面提交局部修请求,对应HTTP的PATCH;
data:字典、字节序列或文件,Requests的内容;
**kwagrs:12个控制访问参数;
7. requests.delete(uel, **kwagrs)
向HTML页面提交删除请求,对对应HTTP的DELETE;
**kwagrs:12个访问控制的参数;
requests库的两个重要的对象
Response对象的属性
1. r.status_code
HTTP请求的返回状态,200表示链接成功,404或其他表示失败;
2. r.text
HTTP响应内容的字符串形式,即url对应的页面内容;
3. r.encoding
从HTTP header中猜测的响应内容编码方式;
如果header中不存在charset,则认为编码为ISO-8859-1,r.text根据r.encoding显示网页内容;
4. r.apparent_encoding
从内容中分析出的响应内容编码方式(备选编码方式);
5. r.content
HTTP响应内容的二进制形式;
Requests库的异常
1. requests.ConnectionError
网络连接错误异常,如DNS查询失败,拒绝链接等;
2. requests.HTTPError
HTTP错误异常;
3. requests.URLRequired
url缺失异常;
4.requests.TooManyRedirects
超出最大重定向次数,产生重定向异常;
5. requests.ConnectTimeout
连接远程服务器超时异常;
6. requests.Timeout
请求url超时,产生超时异常;
7.r.raise_for_status()
如果不是200,产生异常requests.HTTPError;
爬取网页的通用代码框架
import requests

def getHTMLText(url):

    try:

        r = requests.get(url, timeout=30)

        r.raise_for_status()

        #RU如果状态不是200,引发HTTPError异常

        r.encoding() = r.appearent_conding()

        return r.text

    except:

        return "产生异常"

if __name__ == "__main__":

    url = "www.baidu.com"

    print(getHTMLText(url))
python爬虫requests模块的更多相关文章
- python 爬虫 requests模块 目录
requests模块(response常用属性) 基于requests模块的get请求 基于requests模块发起ajax的get请求 基于requests模块发起ajax的post请求
- python 爬虫 requests模块(response常用属性)
response常用属性 content获取的response对象中的二进制(byte)类型的页面数据response.content 返回响应状态码response.status_code 200 ...
- Python爬虫之使用Fiddler+Postman+Python的requests模块爬取各国国旗
介绍 本篇博客将会介绍一个Python爬虫,用来爬取各个国家的国旗,主要的目标是为了展示如何在Python的requests模块中使用POST方法来爬取网页内容. 为了知道POST方法所需要传 ...
- Python爬虫—requests库get和post方法使用
目录 Python爬虫-requests库get和post方法使用 1. 安装requests库 2.requests.get()方法使用 3.requests.post()方法使用-构造formda ...
- python爬虫 urllib模块url编码处理
案例:爬取使用搜狗根据指定词条搜索到的页面数据(例如爬取词条为‘周杰伦'的页面数据) import urllib.request # 1.指定url url = 'https://www.sogou. ...
- python 爬虫 urllib模块 目录
python 爬虫 urllib模块介绍 python 爬虫 urllib模块 url编码处理 python 爬虫 urllib模块 反爬虫机制UA python 爬虫 urllib模块 发起post ...
- Python之requests模块-hook
requests提供了hook机制,让我们能够在请求得到响应之后去做一些自定义的操作,比如打印某些信息.修改响应内容等.具体用法见下面的例子: import requests # 钩子函数1 def ...
- Python之requests模块-cookie
cookie并不陌生,与session一样,能够让http请求前后保持状态.与session不同之处,在于cookie数据仅保存于客户端.requests也提供了相应到方法去处理cookie. 在py ...
- Python之requests模块-session
http协议本身是无状态的,为了让请求之间保持状态,有了session和cookie机制.requests也提供了相应的方法去操纵它们. requests中的session对象能够让我们跨http请求 ...
随机推荐
- 一、Xadmin------安装
翻译:http://xadmin.readthedocs.io/en/docs-chinese 1.安装方法: 1)pip install django-xadmin 2)通过源文件安装,我是通过这种 ...
- 数学基础IV 欧拉函数 Miller Rabin Pollard's rho 欧拉定理 行列式
找了一些曾经没提到的算法.这应该是数学基础系最后一篇. 曾经的文章: 数学基础I 莫比乌斯反演I 莫比乌斯反演II 数学基础II 生成函数 数学基础III 博弈论 容斥原理(hidden) 线性基(h ...
- Contest1692 - 2019寒假集训第三十一场 UPC 11075 Problem D 小P的国际象棋
非常简单的单点修改+区间加+区间查询.我用的是最近刚学的区间修改版本树状数组. 直接维护即可,注意修改后的单点值已经不是a[i],或者b[i],要通过区间查询求单点.不然是错的. 区间修改版本树状数 ...
- 利用tushare进行对兴业银行股价的爬取,并使用numpy进行分析
import sysimport tushare as tsimport numpy as npdata=ts.get_h_data('601066')print(data)#读出兴业银行7列数据da ...
- WinRAR从入门到高级的操作技巧集合
一.基础技巧 1.批量建立文件夹 如果在工作中,经常要建立很多相同文件夹结构(如在备份数据时).那可以把这个繁琐的工作让WinRAR完成:先在“资源管理器”中把多个文件夹结构建好(包括其下的子文件夹) ...
- centos 7 network.service control process exited
一.service network restart 出错 问题描述: vmware 12 下centos 7 网络模式,NAT 昨晚作者打算更新自己虚拟机python,发现没网络ping www.ba ...
- 本地项目托管到github上
一,步骤 1.在github上新建一个仓库 2.进入我的项目目录, git init //初始化本地仓库 3.git add . //把修改的代码提交到暂存区 4.git status 该命令会把你本 ...
- 百度地图开发者API学习笔记二
一,地图上多个覆盖物(Marker). 当有多个覆盖物时,我们需要获取每个点的信息.如下图,每个Marker的经度都不相同 二,代码: <!DOCTYPE html> <html&g ...
- 实现数据结构与算法需要掌握的C语言
我使用C语言并不频繁,一般都是用来实现数据结构与算法,因为面向过程的编程方式容易理解算法的原理,但是呢,如果很长时间没写算法,那么就意味着C语言的某些语法就生疏了,但是总有那么一些,在写算法的时候,特 ...
- [FreeBuff]Trojan.Miner.gbq挖矿病毒分析报告
Trojan.Miner.gbq挖矿病毒分析报告 https://www.freebuf.com/articles/network/196594.html 竟然还有端口转发... 这哥们.. 江民安全 ...