
Hadoop生态圈-Kafka的旧API实现生产者-消费者
Hadoop生态圈-Kafka的旧API实现生产者-消费者
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
一.旧API实现生产者-消费者
1>.开启kafka集群
[yinzhengjie@s101 ~]$ more `which xkafka.sh`

#!/bin/bash

#@author :yinzhengjie

#blog:http://www.cnblogs.com/yinzhengjie

#EMAIL:y1053419035@qq.com

#判断用户是否传参

if [ $# -ne  ];then

    echo "无效参数,用法为: $0  {start|stop}"

    exit

fi

#获取用户输入的命令

cmd=$

for (( i= ; i<= ; i++ )) ; do

    tput setaf

    echo ========== s$i  $cmd ================

    tput setaf

    case $cmd in

        start)

            ssh s$i  "source /etc/profile ; kafka-server-start.sh -daemon /soft/kafka/config/server.properties"

            echo  s$i  "服务已启动"

            ;;

        stop)

            ssh s$i  "source /etc/profile ; kafka-server-stop.sh"

            echo s$i  "服务已停止"

            ;;

            *)

            echo "无效参数,用法为: $0  {start|stop}"

            exit

            ;;

     esac

done

[yinzhengjie@s101 ~]$
[yinzhengjie@s101 ~]$ more `which xkafka.sh`
[yinzhengjie@s101 ~]$ xkafka.sh start

========== s102 start ================

s102 服务已启动

========== s103 start ================

s103 服务已启动

========== s104 start ================

s104 服务已启动

[yinzhengjie@s101 ~]$
开启kafka集群([yinzhengjie@s101 ~]$ xkafka.sh start)
[yinzhengjie@s101 ~]$ xcall.sh jps

============= s101 jps ============

 Jps

命令执行成功

============= s102 jps ============

 QuorumPeerMain

 Kafka

 Jps

命令执行成功

============= s103 jps ============

 Jps

 QuorumPeerMain

 Kafka

命令执行成功

============= s104 jps ============

 Jps

 QuorumPeerMain

 Kafka

命令执行成功

============= s105 jps ============

 Jps

命令执行成功

[yinzhengjie@s101 ~]$

[yinzhengjie@s101 ~]$ more `which xcall.sh`

#!/bin/bash

#@author :yinzhengjie

#blog:http://www.cnblogs.com/yinzhengjie

#EMAIL:y1053419035@qq.com

#判断用户是否传参

if [ $# -lt  ];then

        echo "请输入参数"

        exit

fi

#获取用户输入的命令

cmd=$@

for (( i=;i<=;i++ ))

do

        #使终端变绿色

        tput setaf

        echo ============= s$i $cmd ============

        #使终端变回原来的颜色,即白灰色

        tput setaf

        #远程执行命令

        ssh s$i $cmd

        #判断命令是否执行成功

        if [ $? ==  ];then

                echo "命令执行成功"

        fi

done

[yinzhengjie@s101 ~]$
检查kafka是否正常启动([yinzhengjie@s101 ~]$ xcall.sh jps)
2>.编写生产者端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.kafka;

 import kafka.javaapi.producer.Producer;

 import kafka.producer.KeyedMessage;

 import kafka.producer.ProducerConfig;

 import java.util.Properties;

 public class TestProducer {

     public static void main(String[] args) throws Exception {

         //初始化Java的Properties属性

         Properties props = new Properties();

         //通过metadata.broker.list参数设置代理,其value对应的kafka服务器地址,如果有多个就用逗号(",")分隔。

         props.put("metadata.broker.list", "s102:9092, s103:9092, s104:9092");

         //指定message的数据类型,将传输的数据都序列化成字符串(String),当然还有很多序列化方式(LongEncoder,NullEncoder,DefalutEmcoder,IntegerEncoder),比如默认为字节类型等等。

         props.put("serializer.class", "kafka.serializer.StringEncoder");

         //包装java的prop,包装成ProducerConfig

         ProducerConfig config = new ProducerConfig(props);

         //使用producerConfig初始化producer

         //<String, String> 中第一个为key类型(未接触到),第二个是value类型,真实数据

         Producer<String, String> producer = new Producer<String, String>(config);

         //定义kafka的主题

         String topic = "yinzhengjie";

         for (int i = 1000; i < 2000; i++) {

             KeyedMessage<String, String> data = new KeyedMessage<String, String>(topic, "BigData" + i);

             producer.send(data);

             Thread.sleep(500);

         }

         producer.close();

     }

 }
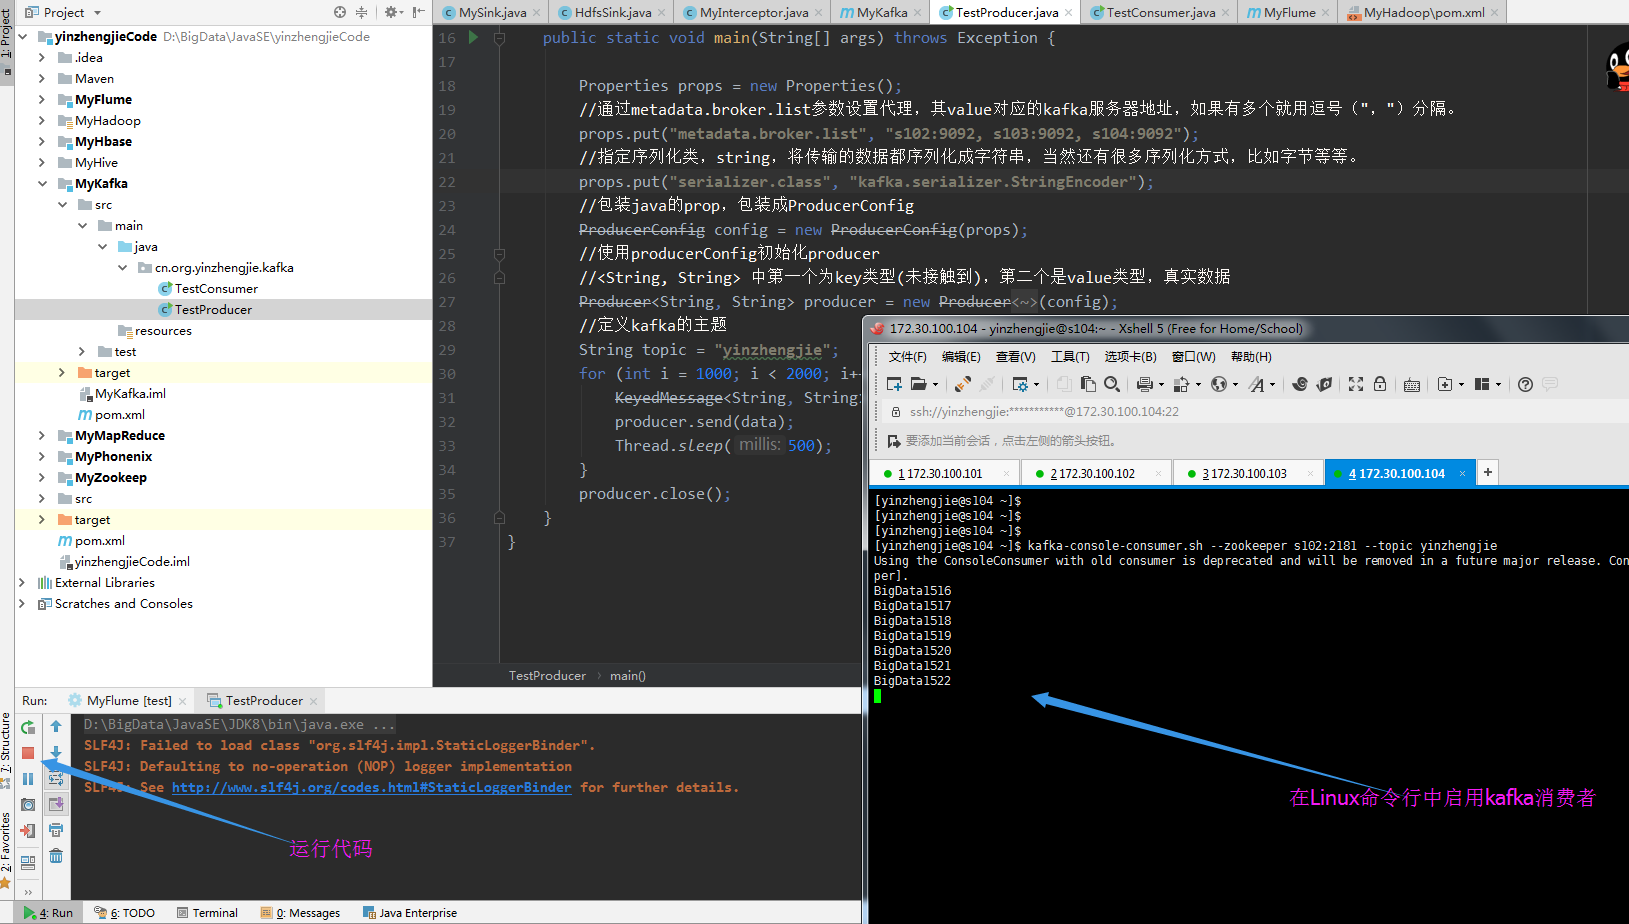
运行以上代码,并在Linux中断启用KafKa的消费者,截图如下:
3>.编写消费者端代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E7%94%9F%E6%80%81%E5%9C%88/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.kafka;

 import java.util.HashMap;

 import java.util.List;

 import java.util.Map;

 import java.util.Properties;

 import kafka.consumer.ConsumerConfig;

 import kafka.consumer.ConsumerIterator;

 import kafka.consumer.KafkaStream;

 import kafka.javaapi.consumer.ConsumerConnector;

 public class TestConsumer {

     public static void main(String[] args) {

         Properties props = new Properties();

         props.put("zookeeper.connect", "s102:2181,s103:2181,s104:2181");

         //设置组id名称

         props.put("group.id", "yzj");

         //ZooKeeper的最大超时时间,就是心跳的间隔,若是没有反映,那么认为已经死了,不易过大

         props.put("zookeeper.session.timeout.ms", "500");

         //定义ZooKeeper集群中leader和follower之间的同步时间

         props.put("zookeeper.sync.time.ms", "250");

         //consumer向zookeeper提交offset的频率,单位是毫秒

         props.put("auto.commit.interval.ms", "1000");

         //把props封装成一个ConsumerConfig对象

         ConsumerConfig conf = new ConsumerConfig(props);

         //创建出一个ConsumerConnector实例

         ConsumerConnector consumer = kafka.consumer.Consumer.createJavaConsumerConnector(conf);

         //定义一个集合,这个集合最终被被传入到consumer.createMessageStreams()方法中。

         Map<String, Integer> topicMap = new HashMap<String, Integer>();

         //topicMap中指定第一个参数是主题,第二个参数是指定线程个数。

         topicMap.put("yinzhengjie", new Integer(1));

         //通过consumer和topic获取到数据流,在Map中的第一个参数是:topic,第二个参数是:消息列表

         Map<String, List<KafkaStream<byte[], byte[]>>> consumerStreamsMap = consumer.createMessageStreams(topicMap);

         //通过topic返回所有消息列表

         List<KafkaStream<byte[], byte[]>> streamList = consumerStreamsMap.get("yinzhengjie");

         //迭代所有list,通过迭代器获取消息流中的k-v

         for (final KafkaStream<byte[], byte[]> stream : streamList) {

             ConsumerIterator<byte[], byte[]> consumerIte = stream.iterator();

             while (consumerIte.hasNext())

                 System.out.println("Message from Single Topic :: "+ new String(consumerIte.next().message()));

         }

     }

 }
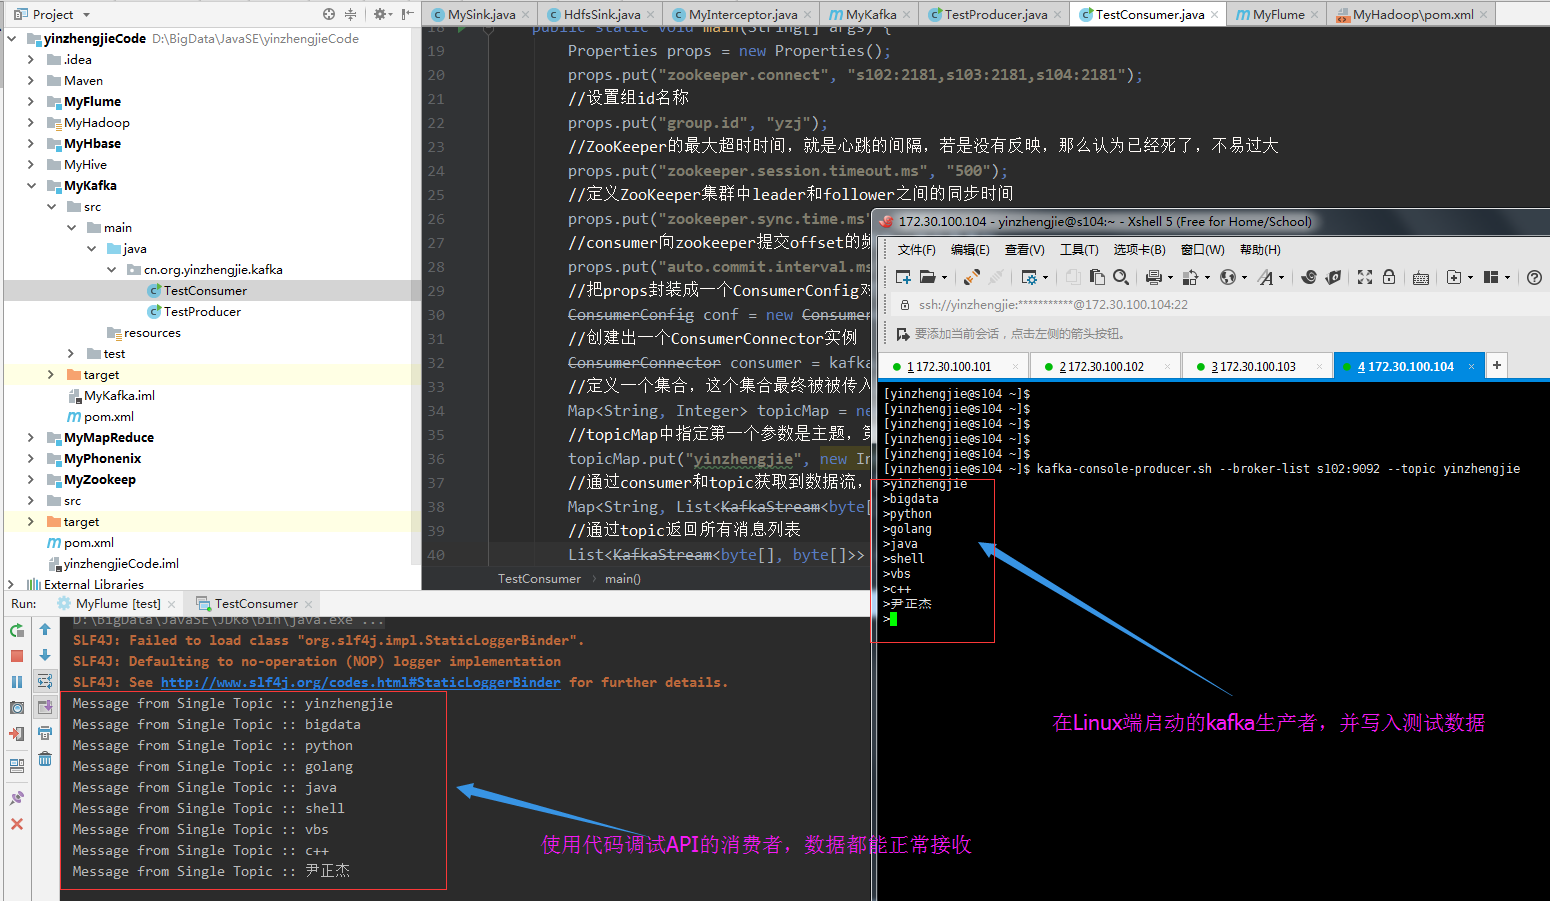
在Linux端启动生产者并运行以上代码,输出结果如下:
二.kafka的producer和Consumer配置(实战重点,调优手段)
1>.kafka的producer配置
>.metadata.broker.list

    答:kafka服务器地址,如果有多个就用逗号(",")分隔。

>.serializer.class

    答:指定message的数据类型。

>.key.serializer.class

    答:指定key的数据类型,key的作用,用作选择分区。默认kafka.serializer.DefaultEncoder(byte[]),常用的还有

"kafka.serializer.NullEncoder","kafka.serializer.NullEncoder","kafka.serializer.StringEncoder","kafka.serializer.IntegerEncoder"

"kafka.serializer.LongEncoder"。

>.producer.type

    答:指定消息应该如何发送。比如async和sync。

            //async    异步,将数据发在缓冲区,一并发送给broker,无序    100000条数据:3792

            //sync    同步,正常发送,有序    100000条数据:31939ms

>.batch.num.messages

    答:指定异步发送中一个批次含有多少条数据,默认200,超过此值就会发送。

>.queue.buffer.max.ms

    答:队列的毫秒数,到达此值数据也会发送。

>.request.required.acks

    答:获取回值,有三种回值方式(并对着三种方式处理100000条数据的所用时间):

            //0意味着 producer不等待broker的回执,适用于最低延迟,不保证数据的完整性(3559)

            //1意味着 只接收分区中的leader回执(4421)

            //-1意味着 接收所有in-sync状态下的节点回执(6792)

>.partitioner.class

    答:指定分区函数类。

>.compression.codec

    答:指定压缩编解码器none, gzip, and snappy.
2>.kafka的Consumer配置
重复消费的手段:

    设置从头消费        //--from-beginning

                //auto.offset.reset = smallest

    手动控制消费偏移量    //通过修改zk数据 consumer/groupid/offsets/topic/partition

>.group.id

    答:指定消费者组id,没有指定会自动创建。

>.consumer.id

    答:指定消费者的id,没有指定会自动创建。

>.zookeeper.connect

    答:指定zookeeper客户端地址。

>.client.id

    答:指定自己的客户端id,没有指定会和group.id一样。

>.zookeeper.session.timeout.ms

    答:zk会话超时则抛异常。

>.zookeeper.connection.timeout.ms

    答:zk连接超时则抛异常。

>.zookeeper.sync.time.ms

    答:控制zk同步数据的时间。

>.auto.commit.enable

    答:自动提交消息的偏移量到zk。

>.auto.commit.interval.ms

    答:自动提交偏移量的间隔。

>.auto.offset.reset

    答:设置从哪里读取数据

                //largest    读取最新数据

                //smallest    读取zk中偏移量的数据

>.consumer.timeout.ms

    答:consumer超时抛异常,并关闭连接
3>.以上部分参数测试代码如下
三.
Hadoop生态圈-Kafka的旧API实现生产者-消费者的更多相关文章
- Hadoop生态圈-Kafka的新API实现生产者-消费者
Hadoop生态圈-Kafka的新API实现生产者-消费者 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Kafka的完全分布式部署
Hadoop生态圈-Kafka的完全分布式部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客主要内容就是搭建Kafka完全分布式,它是在kafka本地模式(https:/ ...
- Hadoop生态圈-Kafka的本地模式部署
Hadoop生态圈-Kafka的本地模式部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Kafka简介 1>.什么是JMS 答:在Java中有一个角消息系统的东西,我 ...
- Hadoop生态圈-kafka事务控制以及性能测试
Hadoop生态圈-kafka事务控制以及性能测试 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-Kafka配置文件详解
Hadoop生态圈-Kafka配置文件详解 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.默认kafka配置文件内容([yinzhengjie@s101 ~]$ more /s ...
- Hadoop生态圈-使用phoenix的API进行JDBC编程
Hadoop生态圈-使用phoenix的API进行JDBC编程 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop日记Day15---MapReduce新旧api的比较
我使用hadoop的是hadoop1.1.2,而很多公司也在使用hadoop0.2x版本,因此市面上的hadoop资料版本不一,为了扩充自己的知识面,MapReduce的新旧api进行了比较研究. h ...
- 使用Win32 API实现生产者消费者线程同步
使用win32 API创建线程,创建信号量用于线程的同步 创建信号量 语法例如以下 HANDLE semophore; semophore = CreateSemaphore(lpSemaphoreA ...
- Hadoop生态圈-Kafka常用命令总结
Hadoop生态圈-Kafka常用命令总结 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.管理Kafka服务的命令 1>.开启kafka服务 [yinzhengjie@s ...
随机推荐
- 后端自动构建前端css和js
引子: 别的复杂前端开发技术不会,用得多的还是手写代码,手动处理. 3年前手写合并压缩js和css文件的asp脚本代码目前还能正常运行,也就没有多大使用别的技术的动力. 直到近期被一个问题纠结着,今天 ...
- .NET Core容器化开发系列(一)——Docker里面跑个.NET Core
前言 博客园中已经有很多如何在Docker里面运行ASP.NET Core的介绍了.本篇主要介绍一些细节,帮助初学的朋友更加深入地理解如何在Docker中运行ASP.NET Core. 安装Docke ...
- C#_父窗体跟子窗体的控件操作
很多人都苦恼于如何在子窗体中操作主窗体上的控件,或者在主窗体中操作子窗体上的控件.相比较而言,后面稍微简单一些,只要在主窗体中创建子窗体的时候,保留所创建子窗体对象即可. 下面重点介绍前一种,目前常见 ...
- Asp.Net_抓包解析xml文件为json
protected void Button1_Click(object sender, EventArgs e) { string Phone = this.Txt_Con.Text; string ...
- Asp.Net_Wcf跟Wpf的区别
摘要:WCF,你就先把它想成WebService的下一代也没什么问题.WCF为WindowsCommunicationFoundation,是Microsoft为构建面向服务的应用提供的分布式通信编程 ...
- docker 学习笔记(1)--常用命令
docker pull---- 获取image(镜像)docker build---- 创建image(镜像)docker images ----查询所有的image(镜像)docker run--- ...
- 【SE】Week1 : 四则运算题目生成器批改器程序总结
用户需求详见:http://www.cnblogs.com/jiel/p/4810756.html 1)PSP表格分析(预计耗时): PSP2.1 Personal Software Process ...
- [2017BUAA软工助教]剩余个人作业与deadline
软件工程剩余作业与deadline 标签(空格分隔): 软件工程 一.个人阅读作业+总结 对软件工程的学习做一个总结. 阅读下列关于软件开发本质和开发方法的博客/文章,结合自己在个人项目/结对编程/团 ...
- 更新pip10后 ImportError: cannot import name ‘main'
百度了几个回答都没有解决问题,有些回答明显是直接复制过来的一点价值都没有,然后google一下立马解决.很多时候不能怪搜索引擎,问题出在一些国内网友对知识的不负责任 解决:找到报错文件,也就是那个pi ...
- php四排序-冒泡排序
算法和数据结构是一个编程工作人员的内功,技术牛不牛,一般都会看这两点.作为php程序员, 提升技能当然也得学习算法. 下面介绍四种入门级排序算法: 冒泡排序.选择排序.插入排序.快速排序. 一 ...