
pandas.DataFrame的pivot()和unstack()实现行转列
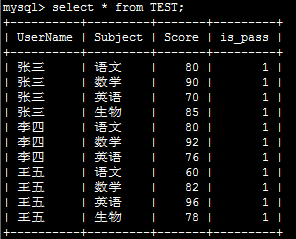
代码如下:
# -*- coding:utf-8 -*-

import pandas as pd

import MySQLdb

from warnings import filterwarnings

# 由于create table if not exists总会抛出warning,因此使用filterwarnings消除

filterwarnings('ignore', category = MySQLdb.Warning)

from sqlalchemy import create_engine

import sys

if sys.version_info.major<3:

  reload(sys)

  sys.setdefaultencoding("utf-8")

  # 此脚本适用于python2和python3

host,port,user,passwd,db,charset="192.168.1.193",3306,"leo","mysql","test","utf8"

def get_df():

  global host,port,user,passwd,db,charset

  conn_config={"host":host, "port":port, "user":user, "passwd":passwd, "db":db,"charset":charset}

  conn = MySQLdb.connect(**conn_config)

  result_df=pd.read_sql('select UserName,Subject,Score from TEST',conn)

  return result_df

def pivot(result_df):

  df_pivoted_init=result_df.pivot('UserName','Subject','Score')

  df_pivoted = df_pivoted_init.reset_index()  # 将行索引也作为DataFrame值的一部分,以方便存储数据库

  return df_pivoted_init,df_pivoted

  # 返回的两个DataFrame,一个是以姓名作index的,一个是以数字序列作index,前者用于unpivot,后者用于save_to_mysql

def unpivot(df_pivoted_init):

  # unpivot需要进行df_pivoted_init二维表格的行、列索引遍历,需要拼SQL因此不能使用save_to_mysql存数据,这里使用SQL和MySQLdb接口存

  insert_sql="insert into test_unpivot(UserName,Subject,Score) values "

  # 处理值为NaN的情况

  df_pivoted_init=df_pivoted_init.fillna(0)

  for col in df_pivoted_init.columns:

    for index in df_pivoted_init.index:

      value=df_pivoted_init.at[index,col]

      if value!=0:

        insert_sql=insert_sql+"('%s','%s',%s)" %(index,col,value)+','

  insert_sql = insert_sql.strip(',')

  global host, port, user, passwd, db, charset

  conn_config = {"host": host, "port": port, "user": user, "passwd": passwd, "db": db, "charset": charset}

  conn = MySQLdb.connect(**conn_config)

  cur=conn.cursor()

  cur.execute("create table if not exists test_unpivot like TEST")

  cur.execute(insert_sql)

  conn.commit()

  conn.close()

def save_to_mysql(df_pivoted,tablename):

  global host, port, user, passwd, db, charset

  """

  只有使用sqllite时才能指定con=connection实例,其他数据库需要使用sqlalchemy生成engine,engine的定义可以添加?来设置字符集和其他属性

  """

  conn="mysql://%s:%s@%s:%d/%s?charset=%s" %(user,passwd,host,port,db,charset)

  mysql_engine = create_engine(conn)

  df_pivoted.to_sql(name=tablename, con=mysql_engine, if_exists='replace', index=False)

# 从TEST表读取源数据至DataFrame结构

result_df=get_df()

# 将源数据行转列为二维表格形式

df_pivoted_init,df_pivoted=pivot(result_df)

# 将二维表格形式的数据存到新表test中

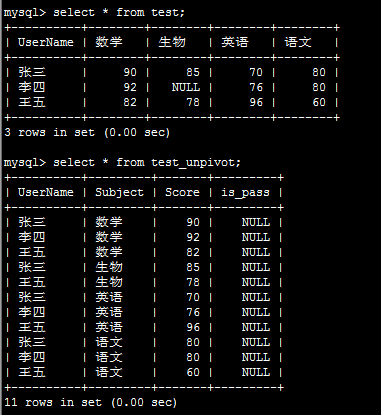
save_to_mysql(df_pivoted,'test')

# 将被行转列的数据unpivot,存入test_unpivot表中

unpivot(df_pivoted_init)
结果如下:
df=pd.DataFrame(np.random.randn(20).reshape(4,5),index=[['a','a','b','b'],[1,2,3,4]],columns=[10,20,30,40,50])

In [96]: df

Out[96]:

           10        20        30        40        50

a 1  0.945775  0.768337  0.851630 -1.050475 -1.102554

  2 -0.366129  0.353388 -0.722637 -0.056877  1.178270

b 3  0.885536  0.210911  2.067309  1.283721 -0.432906

  4  0.173504  1.263630  1.264698  0.913879  1.156815

In [98]: df.stack()

Out[98]:

a  1  10    0.945775

      20    0.768337

      30    0.851630

      40   -1.050475

      50   -1.102554

   2  10   -0.366129

      20    0.353388

      30   -0.722637

      40   -0.056877

      50    1.178270

b  3  10    0.885536

      20    0.210911

      30    2.067309

      40    1.283721

      50   -0.432906

   4  10    0.173504

      20    1.263630

      30    1.264698

      40    0.913879

      50    1.156815

In [99]: df.stack().unstack()

Out[99]:

           10        20        30        40        50

a 1  0.945775  0.768337  0.851630 -1.050475 -1.102554

  2 -0.366129  0.353388 -0.722637 -0.056877  1.178270

b 3  0.885536  0.210911  2.067309  1.283721 -0.432906

  4  0.173504  1.263630  1.264698  0.913879  1.156815
以上利用了Pandas的层次化索引,实际上这也是层次化索引一个主要的用途,结合本例我们可以把代码改成如下:
result_df=pd.read_sql('select UserName,Subject,Score from TEST',conn)

# 在从数据库中获取的数据格式是这样的:

        UserName Subject Score

0        张三      语文   80.0

1        张三      数学   90.0

2        张三      英语   70.0

3        张三      生物   85.0

4        李四      语文   80.0

5        李四      数学   92.0

6        李四      英语   76.0

7        王五      语文   60.0

8        王五      数学   82.0

9        王五      英语   96.0

10       王五      生物   78.0

# 如果要使用层次化索引,那么我们只需要把UserName和Subject列设置为层次化索引,Score为其对应的值即可,我们借用set_index()函数:

df=result_df.set_index(['UserName','Subject'])

In [112]: df.unstack()

Out[112]:

         Score

Subject     数学    生物    英语    语文

UserName

张三        90.0  85.0  70.0  80.0

李四        92.0   NaN  76.0  80.0

王五        82.0  78.0  96.0  60.0

# 使用stack可以将unstack的结果转回来,这样就也在形式上实现了行列互转,之后的操作基本一致了。
pandas.DataFrame的pivot()和unstack()实现行转列的更多相关文章
- [译]如何根据条件从pandas DataFrame中删除不需要的行?
问题来源:https://stackoverflow.com/questions/13851535/how-to-delete-rows-from-a-pandas-dataframe-based-o ...
- SqlServer 行转列,列转行 以及PIVOT函数快速实现行转列,UNPIVOT实现列转行
一 .列转行 创建所需的数据 CREATE TABLE [StudentScores]( [UserName] NVARCHAR(20), --学生姓名 [Subject] NVARCHAR(3 ...
- SqlServer PIVOT函数快速实现行转列,UNPIVOT实现列转行
我们在写Sql语句的时候没经常会遇到将查询结果行转列,列转行的需求,拼接sql字符串,然后使用sp_executesql执行sql字符串是比较常规的一种做法.但是这样做实现起来非常复杂,而在SqlSe ...
- SqlServer PIVOT函数快速实现行转列,UNPIVOT实现列转行(转)
我们在写Sql语句的时候没经常会遇到将查询结果行转列,列转行的需求,拼接sql字符串,然后使用sp_executesql执行sql字符串是比较常规的一种做法.但是这样做实现起来非常复杂,而在SqlSe ...
- [MSSQL]採用pivot函数实现动态行转列
环境要求:2005+ 在日常需求中常常会有行转列的事情需求处理.假设不是动态的行,那么我们能够採取case when 罗列处理. 在sql 2005曾经处理动态行或列的时候,通常採用拼接字符串的方法处 ...
- pandas DataFrame(4)-向量化运算
pandas DataFrame进行向量化运算时,是根据行和列的索引值进行计算的,而不是行和列的位置: 1. 行和列索引一致: import pandas as pd df1 = pd.DataFra ...
- SQL Server 2008 R2——PIVOT 行转列 以及聚合函数的选择
==================================声明================================== 本文原创,转载在正文中显要的注明作者和出处,并保证文章的完 ...
- Oracle 行转列pivot 、列转行unpivot 的Sql语句总结
这个比较简单,用||或concat函数可以实现 select concat(id,username) str from app_user select id||username str from ap ...
- sqlserver 行转列、字符串行转列、自动生产行转列脚本
行转列,老生常谈的问题.这里总结一下网上的方法. 1.生成测试数据: CREATE TABLE human( name ), --姓名 norm ), --指标 score INT , --分数 gr ...
随机推荐
- Java多线程与并发之面试常问题
JAVA多线程与并发 进程与线程的区别 进程是资源分配的最小单位,线程是CPU调度的最小单位 所有与进程相关的资源,都被记录在PCB(进程控制块)中 进程是抢占处理机的调度单位:线程属于某个进程,共享 ...
- 结合Mybatis源码看设计模式——外观模式
定义 提供了一个统一的接口,用来访问子系统中一群接口 适用场景 子系统复杂,增加外观模式提供简单调用接口 构建多层系统结构,用外观对象作为每层入口 详解 外观模式,主要理解外观.通俗一点可以认为这个模 ...
- VS2015编译GEOS的debug和release版本
目前GEOS最新的3.7.1版本支持camke进行编译.经过尝试发现通过cmake生成的工程在vs2015下面编译的时候还是存在问题,而且在中文网上也没找到解决方案. 所以还是采用了nmake进行编译 ...
- Linux下Zookeeper安装使用
1. 下载 下载地址,选择稳定的版本,比如3.4.13,beta为在测版本 2. 复制到任意的目录,解压 3. 修改配置文件 配置文件位于conf目录下,原配置文件为zoo_sample.cfg,更改 ...
- Java遍历List集合的4种方式
public class Test { public static void main(String[] args) { // 循环遍历List的4中方法 List<String> str ...
- java配置环境及安装
1.安装JDK开发环境 首先登陆https://www.oracle.com 第一步:Products ---- Java ---- Download java(JDK) for Developers ...
- 【Android Studio安装部署系列】十五、Android studio添加Assets目录
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 Android Studio新建项目时是没有assets目录,需要自己手动创建. app右键——New——Folder——Asset ...
- 【Android Studio安装部署系列】四十、Android Studio安装Statistic插件(统计项目总行数)
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 Android Studio 是没有提提供统计代码全部行数的功能的,但是对于开发者来说,这个功能确实必备的,Statistic统计代 ...
- 学习ASP.NET Core Razor 编程系列十一——把新字段更新到数据库
学习ASP.NET Core Razor 编程系列目录 学习ASP.NET Core Razor 编程系列一 学习ASP.NET Core Razor 编程系列二——添加一个实体 学习ASP.NET ...
- SQL自动生成java实体类POJO
前言 当我们设计完成数据库之后,通常需要创建对应的实体类,有的称为Entity,有的称为DO,都是一个意思,而自己一个个去写非常的麻烦,所以麻烦的时候就需要相应的自动工具类解决这样的麻烦.超级方便~ ...