
R 分组计算描述性统计量
统计学区内各个小区的房价均值
数据格式
|
id|community_name|house_area|house_structure|house_total|house_avg|agency_name|house_floor_curr|house_floor_total|house_floor_type 6328500962692431872|尚东花园|77.0|3室2厅|285.0|37013.0|利众置业|5|5|多层 6328500979813580800|赛世香樟园|93.0|2室2厅|265.0|28495.0|苏商房产仙林店|9|11|小高层 |
导入数据
|
house<- read.table("house_data.txt", header = TRUE, sep='|',fileEncoding ="UTF-8", stringsAsFactors = FALSE, colClasses = c("character","character","numeric", "character","numeric","numeric","character", "numeric","numeric","character")) houseXQ<- sqldf("select * from house where community_name!='东郊小镇' ",row.names=TRUE) |
选择列
|
selectedColumns<- c("community_name","house_avg") |
将小区名转换成因子
communityFactor<- factor(houseXQ$community_name, order=FALSE) |
将因子列整合到数据框中
houseXQ <-cbind(houseXQ, communityFactor) |
重新选择列
selectedColumns<- c("communityFactor","house_avg")
|
看一下数据
head(houseXQ[selectedColumns]) |
按小区名分组计算均值
aggregate(houseXQ[selectedColumns], by=list(communityFactor=houseXQ$communityFactor),mean) |
结果:
自定义函数计算统计量
|
funcMystats<- function(x, na.omit= FALSE){ if(na.omit){ x<- x[!is.na(x)] } m<- mean(x) n<- length(x) s<- sd(x) skew<- sum((x-m)^3/s^3)/n kurt<- sum((x-m)^4/s^4)/n-3 return (c(n=n,mean=m, stdev=s, skew=skew, kurtosis=kurt)) } funcDstats <- function(x) sapply(x, funcMystats)#对于每个X调用 funcMystats 函数 by(houseXQ[selectedColumns], houseXQ$community_name, funcDstats) |
结果(部分)
houseXQ$community_name: 东方天郡 communityFactor house_avg n 51 51.0000000 mean NA 38255.8039216 stdev 0 2145.6443696 skew NA -0.4395676 kurtosis NA 0.6015383 ------------------------------------------------------------ houseXQ$community_name: 康桥圣菲 communityFactor house_avg n 9 9.0000000 mean NA 34359.0000000 stdev 0 1567.1059313 skew NA -0.9804274 kurtosis NA -0.8342473 ------------------------------------------------------------ houseXQ$community_name: 南师大茶苑 communityFactor house_avg n 1 1 mean NA 31691 stdev NA NA skew NA NA kurtosis NA NA ------------------------------------------------------------ houseXQ$community_name: 赛世香樟园 communityFactor house_avg n 3 3.0000000 mean NA 28938.3333333 stdev 0 1654.1733081 skew NA 0.2487582 kurtosis NA -2.3333333 ------------------------------------------------------------ houseXQ$community_name: 三味公寓 communityFactor house_avg n 2 2.0000 mean NA 28662.0000 stdev 0 576.9991 skew NA 0.0000 kurtosis NA -2.7500 ------------------------------------------------------------ houseXQ$community_name: 尚东花园 communityFactor house_avg n 1 1 mean NA 37013 stdev NA NA skew NA NA kurtosis NA NA ------------------------------------------------------------ |
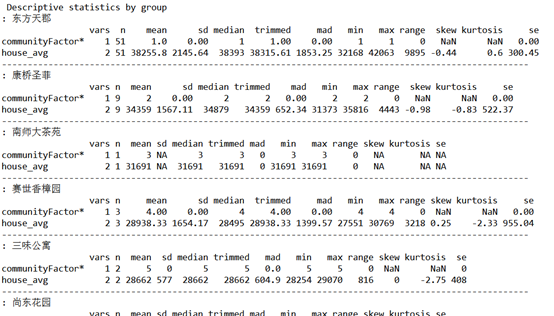
使用 psych 包中的 describeBy()分组计算概述统计量
library(psych) selectedColumns<- c("communityFactor","house_avg")
describeBy(houseXQ[selectedColumns], list(houseXQ$communityFactor)) |
结果如下(部分)
R 分组计算描述性统计量的更多相关文章
- R语言笔记006——分组获取描述性统计量
方法一:使用aggregate()分组获取描述性统计量 aggregate(mtcars[vars],by=list(am=mtcars$am),mean) aggregate(mtcars[vars ...
- R语言笔记005——计算描述性统计量
数据的分布特征: 分布的集中趋势,反应各数据向其中心值靠拢或聚集的程度(平均数,中位数,四分位数,众数) 分布的离散程度,反应各数据远离其中心值的趋势(极差,四分位差,方差,标准差,离散系数) 分布的 ...
- spark 例子groupByKey分组计算
spark 例子groupByKey分组计算 例子描述: [分组.计算] 主要为两部分,将同类的数据分组归纳到一起,并将分组后的数据进行简单数学计算. 难点在于怎么去理解groupBy和groupBy ...
- R语言计算IV值
更多大数据分析.建模等内容请关注公众号<bigdatamodeling> 在对变量分箱后,需要计算变量的重要性,IV是评估变量区分度或重要性的统计量之一,R语言计算IV值的代码如下: Ca ...
- devexpress表格gridcontrol实现分组,并根据分组计算总计及平均值
1.devexpress表格控件gridcontrol提供了强大的分组功能,你几乎不用写什么代码就可以实现一个分组功能,并且可根据分组计算总计和平均值.这里我例举了一个实现根据班级分组计算班级总人数, ...
- R语言计算moran‘I
R语言计算moran‘I install.packages("maptools")#画地图的包 install.packages("spdep")#空间统计,m ...
- spark 例子groupByKey分组计算2
spark 例子groupByKey分组计算2 例子描述: 大概意思为,统计用户使用app的次数排名 原始数据: 000041b232,张三,FC:1A:11:5C:58:34,F8:E7:1E:1E ...
- R语言计算相关矩阵然后将计算结果输出到CSV文件
R语言计算出一个N个属性的相关矩阵(),然后再将相关矩阵输出到CSV文件. 读入的数据文件格式如下图所示: R程序采用如下语句: data<-read.csv("I:\\SB\land ...
- python库学习笔记——分组计算利器:pandas中的groupby技术
最近处理数据需要分组计算,又用到了groupby函数,温故而知新. 分组运算的第一阶段,pandas 对象(无论是 Series.DataFrame 还是其他的)中的数据会根据你所提供的一个或多个键被 ...
随机推荐
- Codeforces Round #369 (Div. 2) C. Coloring Trees 动态规划
C. Coloring Trees 题目连接: http://www.codeforces.com/contest/711/problem/C Description ZS the Coder and ...
- CentOS安装openvpn报错:error: route utility is required but missing
centos7特有,直接安装net-tools即可. 参考: https://forums.openvpn.net/viewtopic.php?t=21432
- Oracle绝对值函数
1.绝对值:abs() select abs(-2) value from dual; 2.取整函数(大):ceil() select ceil(-2.001) value from dual;(-2 ...
- WebService使用实例
近期刚刚開始学习使用WebService的方法进行server端数据交互,发现网上的资料不是非常全, 眼下就结合收集到的一些资料做了一个小样例和大家分享一下~ 我们在PC机器javaclient中.须 ...
- [Asp.net]web.config customErrors 如何设置?
摘要 customErrors也经常在开发部署中看到<customErrors mode="Off" />,设置这样可以在页面上看到详细的错误信息.但也为黑客提供了攻击 ...
- [Winform]关闭窗口使其最小化
摘要 在用户操作关闭窗口的时候,而不是真正的关闭,使其最小化到任务栏,或者托盘. 核心代码 关闭操作,使其最小化到任务栏. private void Form1_Load(object sender, ...
- .net连mysql数据库汇总
另外MySql官方出了一个在csharp里面连接MySql的Connector,可以试试 http://dev.mysql.com/downloads/#connector-net <add n ...
- Cesium中的地形和坐标转换说明
1 Cesium中的地形 Cesium中的地形系统是一种由流式瓦片数据生成地形mesh的技术,厉害指出在于其可以自动模拟出地面.海洋的三维效果.创建地形图层的方式如下: var terrainProv ...
- springMVC中HTTP PUT请求该如何传输请求参数呢?
对于表单提交,tomcat默认只解析POST的表单,对于PUT和DELETE的不处理,所以Spring拿不到.解决方案:1.修改tomcat的server.xml: <Connector p ...
- 根据ImageView的大小来压缩Bitmap,避免OOM
Bitmap是引起OOM的罪魁祸首之一,当我们从网络上下载图片的时候无法知道网络图片的准确大小,所以为了节约内存,一般会在服务器上缓存一个缩略图,提升下载速度.除此之外,我们还可以在本地显示图片前将图 ...