
【解决】elasticsearch:Could not parse aggregation keyed as [%s]问题
背景
在做elasticsearch集群从原来的2.x版本升级到更新版本如6.x过程中,由于需要在原来的应用中,同时连接2.x的集群以及6.x的集群来做在线动态灰度切流量,保证流量平滑切换,有问题可随时回切;一般在应用侧比较常规的做法是使用elasticsearch提供rest的sdk:Java High Level REST Client,可以最大程度的保证多版本的兼容性;但在切换过程中也遇到了比较一些兼容性的问题,今天主要来讨论一下关于聚合结果处理的问题;
直方图统计2.x集群返回结果无法解决的问题
在应用中有一个根据价格区间的直方图统计服务,统计查询语句如下:
//POST /my-index/my-type/_search

{

 "from": 0,

 "size": 0,

 "timeout": "10000ms",

 "aggregations": {

   "statPrice": {

     "histogram": {

       "field": "price",

       "interval": 10000,

       "min_doc_count": 1

     }

   }

 }

}
正常的出参数据如下:
{

    "_shards":{

        "total":16,

        "failed":0,

        "successful":16,

        "skipped":0

    },

    "hits":{

        "hits":[

        ],

        "total":243399987,

        "max_score":0

    },

    "took":539,

    "timed_out":false,

    "aggregations":{

        "statPrice":{

            "buckets":[

                {

                    "doc_count":123,

                    "key":0.0

                },

                {

                    "doc_count":345,

                    "key":1000.0

                },

                {

                    "doc_count":780,

                    "key":2000.0

                }

            ]

        }

    }

}
在应用中通过rest api调用,6.x集群可以正常的获取数据,没有任务问题,这里因为我们使用的elasticsearch-rest-high-level-client的版本就是6.x的,这个跟es服务的版本是一样;但是在2.x的老集群上调用时,返回异常; 提示Could not parse aggregation keyed as [statPrice],详细异常如下
Caused by: org.elasticsearch.common.ParsingException: Could not parse aggregation keyed as [statPrice]

	at org.elasticsearch.search.aggregations.Aggregations.fromXContent(Aggregations.java:146) ~[elasticsearch-6.3.2.jar:6.3.2]

	at org.elasticsearch.action.search.SearchResponse.innerFromXContent(SearchResponse.java:289) ~[elasticsearch-6.3.2.jar:6.3.2]

	at org.elasticsearch.action.search.SearchResponse.fromXContent(SearchResponse.java:248) ~[elasticsearch-6.3.2.jar:6.3.2]

	at org.elasticsearch.client.RestHighLevelClient.parseEntity(RestHighLevelClient.java:653) ~[elasticsearch-rest-high-level-client-6.3.2.jar:6.3.2]

	at org.elasticsearch.client.RestHighLevelClient.lambda$performRequestAndParseEntity$2(RestHighLevelClient.java:508) ~[elasticsearch-rest-high-level-client-6.3.2.jar:6.3.2]

	at org.elasticsearch.client.RestHighLevelClient.performRequest(RestHighLevelClient.java:539) ~[elasticsearch-rest-high-level-client-6.3.2.jar:6.3.2]

	at org.elasticsearch.client.RestHighLevelClient.performRequestAndParseEntity(RestHighLevelClient.java:508) ~[elasticsearch-rest-high-level-client-6.3.2.jar:6.3.2]

	at org.elasticsearch.client.RestHighLevelClient.search(RestHighLevelClient.java:404) ~[elasticsearch-rest-high-level-client-6.3.2.jar:6.3.2]

	at com.jd.b2b.ware.admin.compare.core.support.IncrementSyncHandler.statCount(IncrementSyncHandler.java:133) ~[b2b-ware-admin-compare-0.0.1-SNAPSHOT.jar:?]

	... 48 more
类:org.elasticsearch.search.aggregations.Aggregations.fromXContent的部分代码
 public static Aggregations fromXContent(XContentParser parser) throws IOException {

        final List<Aggregation> aggregations = new ArrayList<>();

        XContentParser.Token token;

        while ((token = parser.nextToken()) != XContentParser.Token.END_OBJECT) {

            if (token == XContentParser.Token.START_OBJECT) {

                SetOnce<Aggregation> typedAgg = new SetOnce<>();

                String currentField = parser.currentName();

                // TYPED_KEYS_DELIMITER为#, 使用 typed_keys 参数在聚合名称前面加上聚合名称类型前缀时使用的分隔符

                parseTypedKeysObject(parser, Aggregation.TYPED_KEYS_DELIMITER, Aggregation.class, typedAgg::set);

                if (typedAgg.get() != null) {

                    aggregations.add(typedAgg.get());

                } else {

                    throw new ParsingException(parser.getTokenLocation(),

                            String.format(Locale.ROOT, "Could not parse aggregation keyed as [%s]", currentField));

                }

            }

        }

        return new Aggregations(aggregations);

    }
通过对报错处的代码debug以及分析,这里会对结果的聚合名称根据#号,取到对应的聚合类型的名称;先是翻看了官方文档,了解了一下typed_keys Aggregations 参数的说明;该参数就是指定返回聚合类型;官方文档最早出现是在7.x的版本,但我们在6.x的集群上同样支持该参数;并且增加该参数与比2.x,出参结果除了在集合名称中有聚合类型外,其他都是一样的;
POST /my-index/my-type/_search?typed_keys (或则typed_keys=true 都可以)
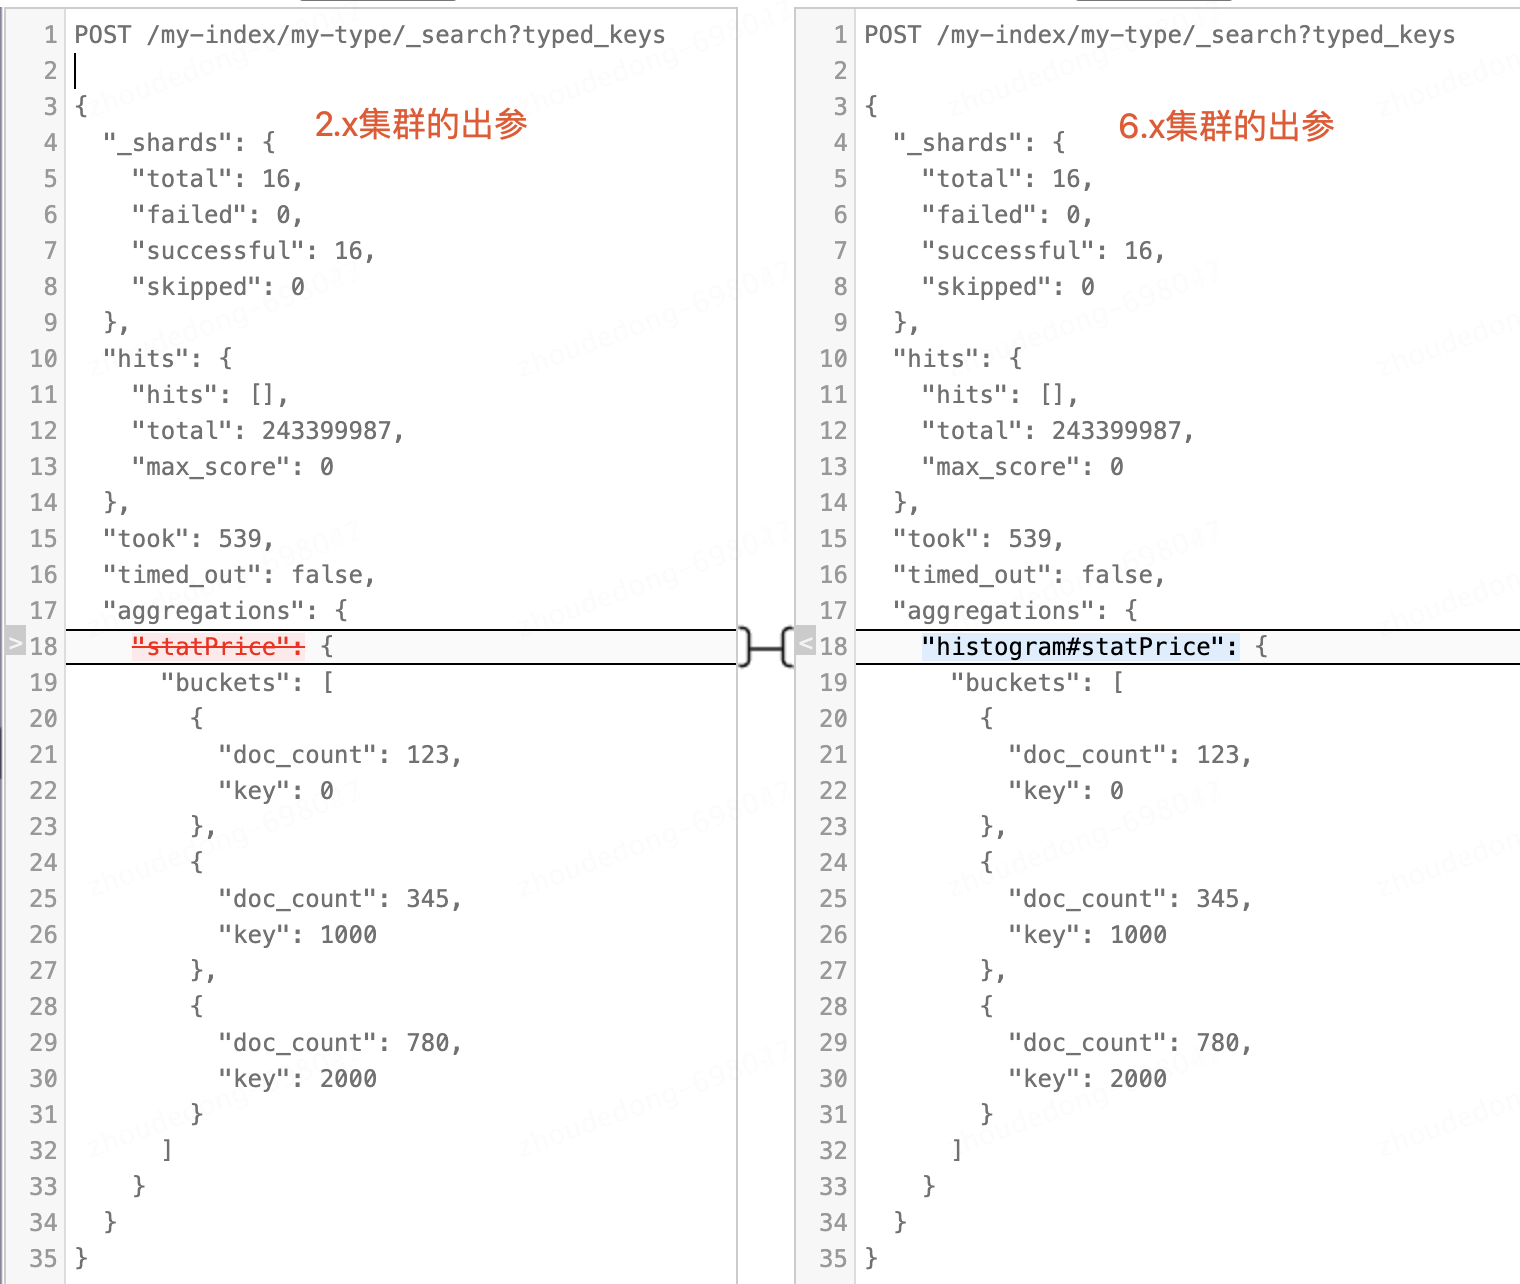
这里又仔细回去检查了我们自己的代码,并没有设置typed_keys参数;本着刨根问底的精神,进行了详细debug,在org.elasticsearch.client.Request#search找到了该参数的设置;这个参数是固定给入的,并且没有参数可以进行覆盖修改;
static Request search(SearchRequest searchRequest) throws IOException {

        String endpoint = endpoint(searchRequest.indices(), searchRequest.types(), "_search");

        Params params = Request.Params.builder();

        params.putParam("typed_keys", "true");

        params.withRouting(searchRequest.routing());

        ........
到此问题原因基本以找到,解决方案就比较如搞;
方案一:使用LowLevelClient
使用LowLevelClient应该是解决这类兼容性问题最通用的办法,因为这个LowLevelClient就是个httpClient,通过给服务端送查询DSL,再获取到出参字符串,基本简单的json字符串解析即可;代码片段如下:
SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();

searchSourceBuilder.from(0).size(0).timeout(TimeValue.timeValueMillis(10000L));

//数据聚合

searchSourceBuilder.query(queryBuilder);

AggregationBuilder aggregationBuilder = AggregationBuilders

        .histogram("statPrice")

        .field("price")

        .interval(1000)

        .minDocCount(1);

searchSourceBuilder.aggregation(aggregationBuilder);

log.info("入参:{}", searchSourceBuilder.toString());

//从highLevelClient中获取到LowLevelClient

RestClient client = highLevelClient.getLowLevelClient();

Map<String, String> params = new HashMap<>();

HttpEntity entity = new NStringEntity(searchSourceBuilder.toString(), ContentType.APPLICATION_JSON);

Response response = client.performRequest("POST","/my-index/my-type/_search",

        params, entity);

String responseBody = EntityUtils.toString(response.getEntity());

//后续的业务处理
方案二:聚合名称前缀聚合类型
针对这个场景,还有一个比较简便的办法;在访问2.x集群时,查询的DSL语句的聚合名字前加上他们需要的前缀即可;查询入参的原来聚合名称是statPrice,现在改成histogram#statPrice即可;
// 2.x集群

//POST /my-index/my-type/_search

 {

  "from": 0,

  "size": 0,

  "timeout": "10000ms",

  "aggregations": {

    "histogram#statPrice": {

      "histogram": {

        "field": "price",

        "interval": 10000,

        "min_doc_count": 1

      }

    }

  }

}
后续的处理就跟6.x集群一样的,也是通过statPrice去取聚合的结果;具体还有哪么前缀可以参考 org.elasticsearch.client.RestHighLevelClient#getDefaultNamedXContents这里的注册信息,可以在6.x等更高的版本中加入typed_keys=true参数,执行一下查询,查看返回的前缘是什么,即可;
参考
- [1] How do you convert an Elasticsearch JSON String Response, with an Aggregation, to an Elasticsearch SearchResponse Object
- [2] 官方 Aggregations 文档
【解决】elasticsearch:Could not parse aggregation keyed as [%s]问题的更多相关文章
- 解决 Elasticsearch 超过 10000 条无法查询的问题
解决 Elasticsearch 超过 10000 条无法查询的问题 问题描述 分页查询场景,当查询记录数超过 10000 条时,会报错. 使用 Kibana 的 Dev Tools 工具查询 从第 ...
- 解决Elasticsearch问题的一些心得体会
在开始前先来介绍下背景:我的日志采集系统采用ELK(logstash(收集).elasticsearch(存储+搜索).kibana(展示)三个软件的简称)开源架构,在elasticsearch搭建了 ...
- 解决离线Could not parse configuration:hibernate.cfg.xml错误
离线使用hibernate tool 生成反向工程,在配置 配置文件完,生成配置文件后,会报出org.hibernate.HibernateException: Could not parse con ...
- 解决Elasticsearch索引只读
今天添加索引时发现kibana添加索引不生效,页面也没有报错,没有创建成功只是一闪而过. 另外发现各项目日志与当前时间差异很大,filebeat一直报错io timeout 具体报错如下: fileb ...
- Elasticsearch:significant terms aggregation
在本文中,我们将重点关注significant terms和significant text聚合.这些聚合旨在搜索数据集中有趣和/或不寻常的术语,这些术语可以告诉您有关数据的隐藏属性的更多信息.此功能 ...
- elasticsearch in docker/ and aggregation,,performance tune ;throughout
Docker环境中Elasticsearch的安装 ]https://wenchao.ren/archives/category/elasticsearch/page/2 [ElasticSearch ...
- Java代码解决ElasticSearch的Result window is too large问题
调用ElasticSearch做分页查询时报错: QueryPhaseExecutionException[Result window is too large, from + size must b ...
- elasticsearch 深入 —— Top Hits Aggregation
Top Hits Aggregation top_hits指标聚合器跟踪正在聚合的最相关文档. 此聚合器旨在用作子聚合器,以便可以按桶聚合最匹配的文档. top_hits聚合器可以有效地用于通过桶聚合 ...
- [待解决]报错:JSON parse error: Unexpected character
{"code":"9999","message":"JSON parse error: Unexpected character ...
- 速看,ElasticSearch如何处理空值
大家好,我是咔咔 不期速成,日拱一卒 在MySQL中,十分不建议大家给表的默认值设置为Null,这个后期咔咔也会单独出一期文章来说明这个事情. 但你进入一家新公司之前的业务中存在大量的字段默认值为Nu ...
随机推荐
- 1.6 编写双管道ShellCode后门
本文将介绍如何将CMD绑定到双向管道上,这是一种常用的黑客反弹技巧,可以让用户在命令行界面下与其他程序进行交互,我们将从创建管道.启动进程.传输数据等方面对这个功能进行详细讲解.此外,本文还将通过使用 ...
- k3s 基础 —— 配置 loki
官方文档 核心组件 3 个 chart: promtail 这是一个 agent 代理客户端,用于收集日志,将日志传送给 loki loki 核心组件,主要功能是日志数据的写入与分析.包含 gatew ...
- Redis的设计与实现(5)-整数集合
整数集合(intset)是集合键的底层实现之一: 当一个集合只包含整数值元素, 并且这个集合的元素数量不多时, Redis 就会使用整数集合作为集合键的底层实现. 整数集合 (intset) 是 Re ...
- Android 妙用TextView实现左边文字,右边图片
原文: Android 妙用TextView实现左边文字,右边图片 - Stars-One的杂货小窝 有时候,需要文字在左边,右边有个箭头,我个人之前会有两种做法: 使用线性布局来实现 或者使用约束布 ...
- 2021-7-11 Vue的自定义指令简单实例
获取焦点简单实例,用Vue.directive(ps:指令)定义,命名不要是关键字,用v-加自定义指令名称调用,而内部用钩子函数inserted来实现 <!DOCTYPE html> &l ...
- vlunhub笔记(二)earth
(一)信息收集 开始扫描目标机ip,目标机ip:192.168.241.135 arp-scan -l 直接访问目标 ip 192.168.241.135 发现400报错 只能先去考虑扫一下信息 ...
- python教程 入门学习笔记 第4天 数据类型 获取数据类型 字符串拼接
数据类型 1.能直接处理的基本数据类型有5个:整型.浮点型.字符串.布尔值.空 1)整型(int)=整数,例如0至9,-1至-9,100,-8180等,人数.年龄.页码.门牌号等 没有小数位的数字,是 ...
- 从浅入深了解.NET Core MVC 2.x全面教程
一.基础 1.默认配置 使用Kestrel Web Server ASP.NET Core内置--跨平台 IIS集成 UseIIS() UseIISIntergration() Log IConfig ...
- 解决linux系统的kdump服务无法启动的问题
**问题:项目麒麟系统服务器的kdump服务无法启动,没有相关日志无法定位问题.** 1.查看服务状态是关闭的,重启系统也无法启动 systemctl status kdump 2.修改grub参数 ...
- Vue源码学习(二):<templete>渲染第一步,模板解析
好家伙, 1.<template>去哪了 在正式内容之前,我们来思考一个问题, 当我们使用vue开发页面时,<tamplete>中的内容是如何变成我们网页中的内容的? 它会经历 ...