
[转帖]Innodb存储引擎-锁(数据库锁的查看、快照读&当前读、MVCC、自增长与锁、外键与锁、行锁、并发事务的问题、阻塞、死锁、锁升级、锁的实现)
文章目录
锁
锁是数据库系统区别于文件系统的一个关键特性。锁机制用于管理对共享资源的并发访问,InnoDB 存储引擎会在行级别上对表数据上锁,这固然不错。不过InnoDB 存储引擎也会在数据库内部其他多个地方使用锁,从而允许对多种不同资源提供并发访问。
数据库系统使用锁是为了支持对共享资源进行并发访问,提供数据的完整性和一致性。对于锁,用户可能对某个特定的关系数据库系统的锁定模型有一定的经验,但这并不意味着知道其他数据库。也就是说,它们各自对于锁的实现完全不同。
对于MyISAM 引擎,其锁是表锁设计。并发情况下的读没有问题,但是并发插入时的性能就要差一些了,若插入是在“底部", MyISAM 存储引擎还是可以有一定的并发写入操作。
InnoDB 存储引擎锁的实现和 Oracle 数据库非常类似,提供一致性的非锁定读、行级锁支持。行级锁没有相关额外的开销,并可以同时得到并发性和一致性。
lock 与latch
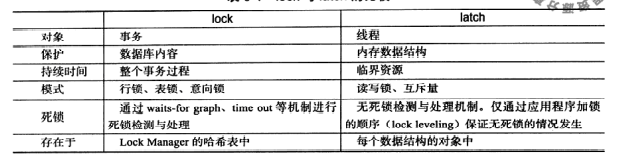
在数据库中, lock 与 latch 都可以被称为"锁"。但是两者有着截然不同的含义:
- latch 一般称为门锁(轻量级的锁),因为其要求锁定的时间必须非常短。若持续的时间长,则应用的性能会非常差。在InnoDB 存储引擎中, latch 又可以分为 mutex (互斥量)和rwlock (读写锁)。其目的是用来保证并发线程操作 临界资源 的正确性,并且通常没有死锁检测的机制;
- lock 的对象是事务,用来锁定的是数据库中的对象,如表、页、行。并且一般lock的对象仅在事务commit 或rollback 后进行释放(不同事务隔离级别释放的时间可能不同)。此外, lock, 正如在大多数数据库中一样,是有 死锁 机制的。
对于InnoDB 存储引擎中的latch, 可以通过命令SHOW ENGINE INNODB MUTEX 来进行查看:
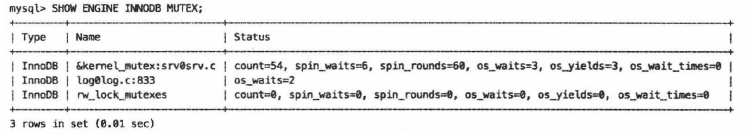
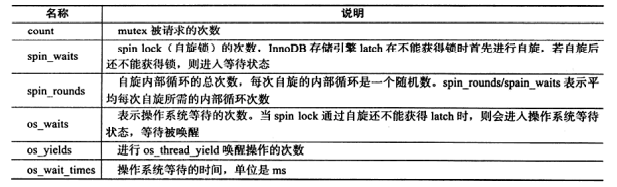
列 Type 显示的总是InnoDB, 列Name 显示的是latch 的信息以及所在源码的位置(行数)。列Status 比较复杂,在Debug 模式下,除了显示os_waits,还会显示count、spin_waits 、spin_rounds 、os_yields 、os_ wait_ times 等信息。
相对于latch 的查看, lock 信息就显得直观多了。用户可以通过命令 SHOW ENGINE INNODB STATUS 及information_schema 架构下的表INNODB_TRX 、INNODB_LOCKS 、INNODB_LOCK_WAITS 来观察锁的信息。(后面会介绍)
读锁/写锁/意向锁
InnoDB 存储引擎实现了如下两种标准的行级锁:
- 读锁(共享锁 S):允许事务去读一行,阻止其他事务获得相同数据集的排他锁。若事务T对数据对象A加上S锁,则事务T可以读A但不能修改A,其他事务只能再对A加S锁,而不能加X锁,直到T释放A上的S锁。这保证了其他事务可以读A,但在T释放A上的S锁之前不能对A做任何修改。InnoDB通过使用lock in share mode加读锁,但是注意
只锁覆盖索引 - 写锁(互斥锁 X):允许获取排他锁的事务更新数据,阻止其他事务取得相同的数据集共享读锁和排他写锁。若事务T对数据对象A加上X锁,事务T可以读A也可以修改A,其他事务不能再对A加任何锁,直到T释放A上的锁。InnoDB所有的DML操作默认加写锁。select可以通过for update加写锁,并且会锁住所有索引,不仅仅是索引覆盖的索引。
对于UPDATE、DELETE和INSERT语句,InnoDB会自动给涉及数据集加排他锁(X);对于普通SELECT语句,InnoDB不会加任何锁,因为MVCC机制。
事务可以通过以下语句显式给记录集加共享锁或排他锁:
- 共享锁(S):
SELECT * FROM table_name WHERE ... LOCK IN SHARE MODE。 - 排他锁(X):
SELECT * FROM table_name WHERE ... FOR UPDATE。
用SELECT ... LOCK IN SHARE MODE获得共享锁,主要用在需要数据依存关系时来确认某行记录是否存在,并确保没有人对这个记录进行UPDATE或者DELETE操作。但是如果当前事务也需要对该记录进行更新操作,则很有可能造成死锁,对于锁定行记录后需要进行更新操作的应用,应该使用SELECT… FOR UPDATE方式获得排他锁。
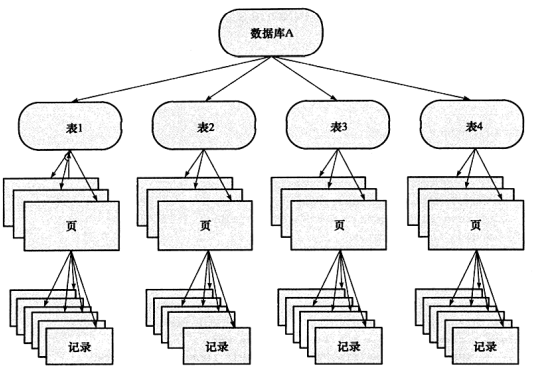
为了允许行锁和表锁共存,实现多粒度锁机制,InnoDB还有两种内部使用的意向锁(Intention Locks),这两种意向锁都是表锁。意向锁是将锁定的对象分为多个层次,意向锁意味着事务希望在更细粒度(fine granularity) 上进行加锁。
如下图:若将上锁的对象看成一棵树,那么对最下层的对象上锁,也就是对最细粒度的对象进行上锁,那么首先需要对粗粒度的对象上锁。如果需要对页上的记录r 进行上X 锁,那么分别需要对数据库A 、表、页上意向锁 IX, 最后对记录 r 上X 锁。若其中任何一个部分导致等待,那么该操作需要等待粗粒度锁的完成。
- 意向共享锁(IS):事务打算给数据行共享锁,事务在给一个数据行加共享锁前必须先取得该表的IS锁。
- 意向排他锁(IX):事务打算给数据行加排他锁,事务在给一个数据行加排他锁前必须先取得该表的IX锁。
当向一个表添加表级X锁或者S锁时,如果没有意向锁的话,则需要遍历所有整个表判断是否有不兼容的行锁的存在,以免发生冲突。
如果有了意向锁,只需要判断该意向锁与即将添加的表级锁是否兼容即可,因为意向锁的存在代表了有行级锁的存在或者即将有行级锁的存在,因而无需遍历整个表,即可获取结果。
InnoDB行锁模式兼容性列表:
| S | IS | X | IX | |
|---|---|---|---|---|
| S | 兼容 | 兼容 | 冲突 | 冲突 |
| IS | 兼容 | 兼容 | 冲突 | 兼容 |
| X | 冲突 | 冲突 | 冲突 | 冲突 |
| IX | 冲突 | 兼容 | 冲突 | 兼容 |
注意:这里的排他 / 共享锁指的都是表锁!!!意向锁不会与行级的共享 / 排他锁互斥!!!
如果一个事务请求的锁模式与当前的锁兼容,InnoDB就请求的锁授予该事务;反之,如果两者两者不兼容,该事务就要等待锁释放。
意向锁是InnoDB自动加的,不需用户干预。
事务在更新某一行数据时,需要申请对这行数据加行级别的锁排斥锁X,在申请X锁之前会申请IX。
意向锁之间是兼容的,IS锁和IX是兼容,因为可能我们对第一行数据加S锁,那么会申请IS锁,对第二行数据加X锁,此时跟第一行的数据的S锁不冲突,所以也会先申请IX锁,由此可见,IS锁和IX之间不冲突,IS锁,IX锁与行级别的S,行级别的X之间也不冲突。意向锁只是跟表级别的S,X锁可能会冲突。
INNODB_TRX/INNODB_LOCKS/INNODB_LOCK_WAITS
在InnoDB 1 . 0 版本之前,用户只能通过命令SHOW FULL PROCESSLIST, SHOW ENGINE INNODB STATUS 等来查看当前数据库中锁的请求,然后再判断事务锁的情况。从InnoDBl.O 开始,在 INFORMATION_SCHEMA 架构下添加了表INNODB_TRX 、INNODB_LOCKS 、INNODB_LOCK_WAITS 。通过这三张表,用户可以更简单地监控当前事务并分析可能存在的锁问题。
(1)INNODB_TRX
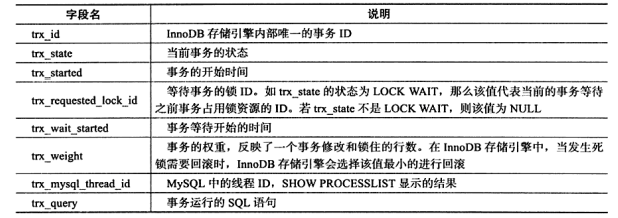
看一个例子:
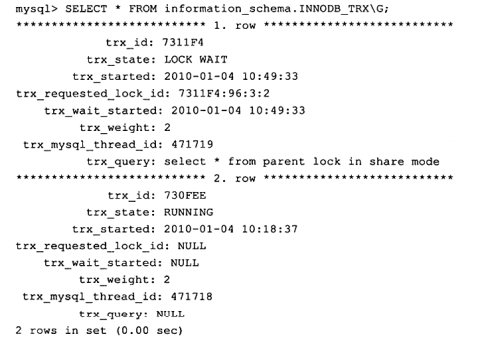
通过列state可以观察到trx_ id 为730FEE的事务当前正在运行,而trx_id内7314F4的事务目前处于“LOCK WAIT”状态,且运行的SQL语句是select * from parent lock in share mode,该表只是显示了当前运行的InnoDB事务,并不能直接判断锁的一些情况。如果需要查看锁,则还需要访问表INNODB_LOCKS。
(2)INNODB_LOCKS
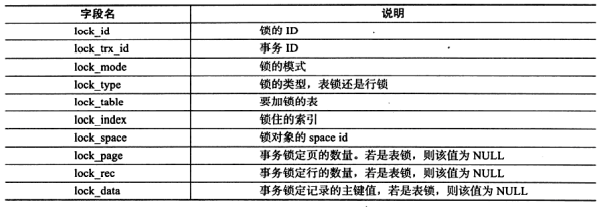
接着上面的例子:
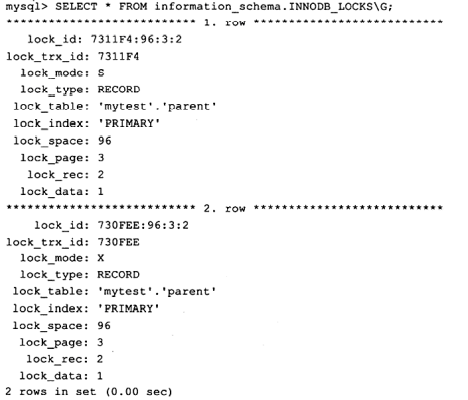
这次用户可以清晰地看到当前锁的信息。trx_id 为730FEE的事务向表parent加了一个X的行锁,ID为7311F4的事务向表parent申请了一个S的行锁。lock_data都是
1,申请相同的资源,因此会有等待。这也可以解释INNODB_TRX中为什么一个事务的tx_ state 是“RUNNING",另一个是“LOCK WAIT”了。
另外需要特别注意的是,我发现lock_data 这个值并非是“可信”的值。例如当用户运行一个范围查找时,lock_data可能只返回第一行的主键值。与此同时,如果当前资源被锁住了,若锁住的页因为InnoDB存储引擎缓冲池的容量,导致该页从缓冲池中被刷出,则查看INNODB_LOCKS表时,该值同样会显示为NULL,即InnoDB存储引擎不会从磁盘进行再一次的查找。
(3)INNODB_LOCK_WAITS
在通过表INNODB_LOCKS查看了每张表上锁的情况后,用户就可以来判断由此引发的等待情况了。当事务较小时,用户就可以人为地、直观地进行判断了。但是当事务量非常大,其中锁和等待也时常发生,这个时候就不这么容易判断。但是通过表INNODB_LOCK_WAITS,可以很直观地反映当前事务的等待。
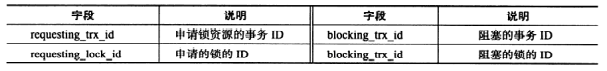
接着上面的例子:
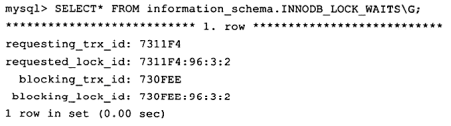
如果可以的话,用户可以根据这三个表进行联合查询,来得到更直观的信息。
一致性非锁定读(快照读)
一致性的非锁定读 ( consistent nonlocking read) 是指 InnoDB 存储引擎通过行多版本控制(multi versioning) 的方式来读取当前执行时间数据库中行的数据。
如果读取的行正在执行DELETE 或UPDATE 操作,这时读取操作不会因此去等待行上锁的释放。相反地, InnoDB 存储引擎会去读取行的一个快照数据。如下图:
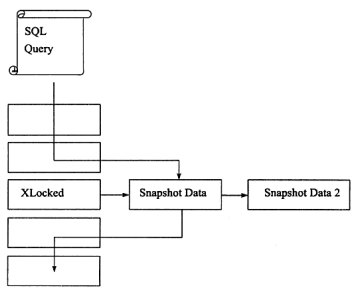
之所以称其为非锁定读,因为不需要等待访问的行上 X 锁的释放。快照数据是指该行的之前版本的数据,该实现是通过 undo 段来完成。而 undo 用来在事务中回滚数据,因此快照数据本身是没有额外的开销。此外,读取快照数据是不需要上锁的,因为没有事务需要对历史的数据进行修改操作。
非锁定读机制极大地提高了数据库的并发性。在InnoDB 存储引擎的默认设置下,这是默认的读取方式,即读取不会占用和等待表上的锁。 但是在不同事务隔离级别下,读取的方式不同,并不是在每个事务隔离级别下都是采用非锁定的一致性读。此外,即使都是使用非锁定的一致性读,但是对于快照数据的定义也各不相同。
一致性锁定读(当前读)
在默认配置下,即事务的隔离级别为REPEATABLE READ模式下, InnoDB 存储引擎的SELECT 操作使用一致性非锁定读。但是在某些情况下,用户需要显式地对数据库读取操作进行加锁以保证数据逻辑的一致性(比如在有外键时,插入或更新需要查找父表的指定字段)。而这要求数据库支待加锁语句,即使是对于SELECT 的只读操作。InnoDB 存储引擎对于SELECT 语句支持两种一致性的锁定读(locking read) 操作:
- SELECT…FOR UPDATE :对读取的行记录加一个X 锁,其他事务不能对已锁定的行加上任何锁;
- SELECT…LOCK IN SHARE MODE:对读取的行记录加一个S 锁,其他事务可以向被锁定的行加S 锁,但是如果加X 锁,则会被阻塞。
对于一致性非锁定读,即使读取的行已被执行了SELECT … FOR UPDATE, 也是可以进行读取的,这和之前讨论的情况一样。此外, SELECT … FOR UPDATE, SELECT… LOCK IN SHARE MODE 必须在一个事务中,当事务提交了,锁也就释放了。因此在使用上述两句SELECT 锁定语句时,务必加上BEGIN, START TRANSACTION 或者SET AUTOCOMMIT=0 。
MVCC
MVCC,即Multi-Version Concurrency Control (多版本并发控制)。它是一种并发控制的方法,一般在数据库管理系统中,实现对数据库的并发访问,在编程语言中实现事务内存。由read view+undo log版本链条实现。
通俗的讲,数据库中同时存在多个版本的数据,并不是整个数据库的多个版本,而是某一个行记录可能有不止一个版本数据,在某个事务对其进行操作的时候,需要查看这一条记录的隐藏列事务版本id,比对read view中的id并根据事物隔离级别去判断读取哪个版本的数据。一般称这种技术为行多版本技术。由此带来的并发控制,称之为多版本并发控制(Multi Version Concurrency Control, MVCC),
数据库隔离级别读已提交、可重复读 都是基于MVCC实现的,相对于加锁简单粗暴的方式,它用更好的方式去处理读写冲突,能有效提高数据库并发性能。
- 在 READ COMMITTED 事务隔离级别下,对于快照数据,非一致性读总是读取被锁定行的最新一份快照数据(注意是已提交数据)(解决了读已提交,但没有解决不可重复读);
- 在 REPEATABLE READ 事务隔离级别下,对于快照数据,非一致性读总是读取事务开始时的行数据版本(解决了不可重复读问题)。
版本链
对于InnoDB存储引擎,每一行记录都有两个隐藏列trx_id、roll_pointer,如果表中没有主键和非NULL唯一键时,则还会有第三个隐藏的主键列row_id。
| 列名 | 是否必须 | 描述 |
|---|---|---|
| row_id | 否 | 单调递增的行ID,不是必需的,占用6个字节。 |
| trx_id | 是 | 记录操作该数据事务的事务ID |
| roll_pointer | 是 | 这个隐藏列就相当于一个指针,指向回滚段的undo日志 |
多个事务并行操作某一行数据时,不同事务对该行数据的修改会产生多个版本,然后通过回滚指针(roll_pointer),连成一个链表,这个链表就称为版本链。如下:
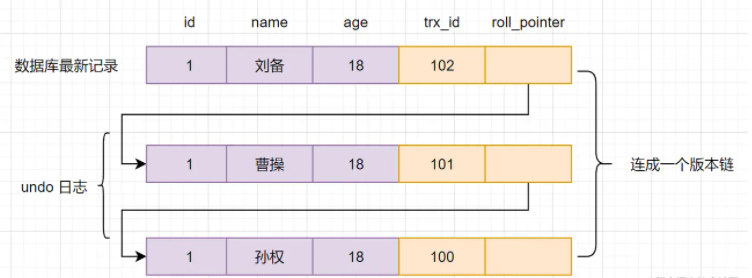
其实,通过版本链,我们就可以看出事务版本号、表格隐藏的列和undo log它们之间的关系。
Read View
- Read View是什么呢? 它就是事务执行SQL语句时,产生的读视图。实际上在innodb中,每个SQL语句执行前都会得到一个Read View。
- Read View有什么用呢? 它主要是用来做可见性判断的,即判断当前事务可见哪个版本的数据~
Read View是如何保证可见性判断的呢?我们先看看Read view 的几个重要属性
- m_ids:当前系统中那些活跃(未提交)的读写事务ID, 它数据结构为一个List。
- min_limit_id:表示在生成ReadView时,当前系统中活跃的读写事务中最小的事务id,即m_ids中的最小值。
- max_limit_id:表示生成ReadView时,系统中应该分配给下一个事务的id值。
- creator_trx_id: 创建当前read view的事务ID
Read view 匹配条件规则如下:
- 如果数据事务ID
trx_id < min_limit_id,表明生成该版本的事务在生成Read View前,已经提交(因为事务ID是递增的),所以该版本可以被当前事务访问。 - 如果
trx_id>= max_limit_id,表明生成该版本的事务在生成ReadView后才生成,所以该版本不可以被当前事务访问。 - 如果
min_limit_id <= trx_id,需要分3种情况讨论
- (1)如果
m_ids包含trx_id,则代表Read View生成时刻,这个事务还未提交,但是如果数据的trx_id等于creator_trx_id的话,表明数据是自己生成的,因此是可见的。- (2)如果
m_ids包含trx_id,并且trx_id不等于creator_trx_id,则Read View生成时,事务未提交,并且不是自己生产的,所以当前事务也是看不见的;- (3)如果
m_ids不包含trx_id,则说明你这个事务在Read View生成之前就已经提交了,修改的结果,当前事务是能看见的。
流程
- 获取事务自己的版本号,即事务ID
- 获取Read View
- 查询得到的数据,然后Read View中的事务版本号进行比较。
- 如果不符合Read View的可见性规则, 即就需要Undo log中历史快照;
- 最后返回符合规则的数据
InnoDB 实现MVCC,是通过 Read View+ Undo Log 实现的,Undo Log 保存了历史快照,Read View可见性规则帮助判断当前事务可见哪个版本的数据。
自增长与锁
自增长 在数据库中是非常常见的一种属性,也是很多DBA 或开发人员首选的主键方式。在InnoDB 存储引擎的内存结构中,对每个含有自增长值的表都有一个自增长计数器 (auto-increment counter) 。
当对含有自增长的计数器的表进行插入操作时,这个计数器会被初始化,执行如下的语句来得到计数器的值:
SELECT MAX(auto inc col) FROM t FOR UPDATE;
- 1
插入操作会依据这个自增长的计数器值加 1 赋予自增长列。这个实现方式称做AUTO-INC Locking 。这种锁其实是采用一种特殊的表锁机制,为了提高插入的性能,锁不是在一个事务完成后才释放,而是在完成对自增长值插入的SQL 语句后立即释放。
虽然AUTO-INC Locking 从一定程度上提高了并发插入的效率,但还是存在一些性能上的问题。首先,对于有自增长值的列的并发插入性能较差,事务必须等待前一个插入的完成(虽然不用等待事务的完成)。其次,对于INSERT … SELECT 的大数据量的插入会影响插入的性能,因为另一个事务中的插入会被阻塞。
从MySQL 5.1.22 版本开始, InnoDB 存储引擎中提供了一种轻量级互斥量的自增长实现机制,这种机制大大提高了自增长值插入的性能。并且从该版本开始, InnoDB 存储引擎提供了一个参数innodb_autoinc_lock_mode 来控制自增长的模式,该参数的默认值为1。
在继续讨论新的自增长实现方式之前,需要对自增长的插入进行分类:
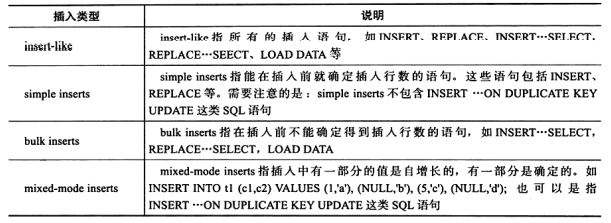
接着来分析参数innodb__autoinc_lock_mode以及各个设置下对自增的影响,其总共有三个有效值可供设定:
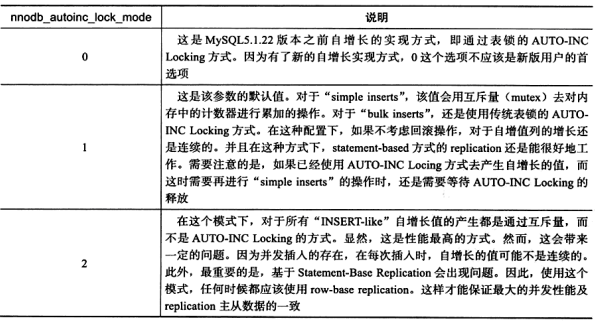
InnoDB 存储引擎中自增长的实现和MyISAM 不同,MyISAM 存储引擎是表锁设计,自增长不用考虑并发插入的问题。因此在 master 上用InnoDB 存储引擎,在slave 上用MyISAM 存储引擎的 replication 架构下,用户必须考虑这种情况。
在lnnoDB 存储引擎中,自增长值的列必须是索引,同时必须是索引的第一个列。如果不是第一个列,则MySQL 数据库会抛出异常,而MylSAM 存储引擎没有这个问题。
外键和锁
外键主要用于引用完整性的约束检查。在InnoDB 存储引擎中,对于一个外键列,如果没有显式地对这个列加索引, InnoDB 存储引擎自动对其加一个索引,因为这样可以避免表锁,这比Oracle 数据库做得好, Oracle 数据库不会自动添加索引,用户必须自己手动添加,这也导致了Oracle 数据库中可能产生死锁。
对于外键值的插入或更新,首先需要查询父表中的记录,即SELECT 父表。 但是对于父表的SELECT 操作,不是使用一致性非锁定读的方式,因为这样会发生数据不一致的问题,因此这时使用的是SELECT … LOCK IN SHARE MODE 方式,即主动对父表加一个S 锁。如果这时父表上已经这样加X 锁,子表上的操作会被阻塞。
行锁类型
InnoDB 存储引擎有3 种行锁 的算法,其分别是:
- Record Lock: 单个行记录上的锁;
- Gap Lock: 间隙锁,锁定一个范围,但不包含记录本身;
- Next-Key Lock : Gap Lock+Record Lock,锁定一个范围,并且锁定记录本身
记录锁(record lock)
记录锁(Record Locks)也称为行锁,记录锁定是对单条索引记录的锁定,如果InnoDB 存储引擎表在建立的时候没有设置任何一个索引,那么这时InnoDB 存储引擎会使用 隐式的主键 来进行锁定。。例如, SELECT c1 FROM t WHERE c1 = 10 FOR UPDATE; 可以防止从插入,更新或删除行。
间隙锁(gap lock)
间隙锁就会对记录之间的间隙加锁,防止数据插入。就是我们在使用实时读(SELECT FOR … UPDATE)或者更新,为了防止读的过程中有新的数据插入,会对我们读的数据的左右区间进行加锁,防止其他事务插入数据,所以间隙锁之间是不排斥的,间隙锁排斥的只是插入数据的操作。
下一键锁(next-key lock)
next-key lock就是记录锁和间隙锁的组合,会锁记录以及记录之间的间隙,就是对要更新的数据的左右两个端点加间隙锁。主要是用来解决幻读问题。
原则 1:加锁的基本单位是 next-key lock。希望你还记得,next-key lock 是前开后闭区间。
原则 2:查找过程中访问到的对象才会加锁。
优化 1:索引上的等值查询,给唯一索引加锁的时候,next-key lock 退化为行锁。
优化 2:索引上的等值查询,向右遍历时且最后一个值不满足等值条件的时候,next-key lock 退化为间隙锁。
一个 bug:唯一索引上的范围查询会访问到不满足条件的第一个值为止。
在默认的事务隔离级别下,即REPEATABLE READ 下, InnoDB 存储引擎采用Next-Key Locking 机制来避免Phantom Problem (幻读问题)。
例如:num是一个普通索引,非唯一性索引,已有数据是1,5,10,20,30
那么 next-key lock可以锁定的区间是
(负无穷,1]

(1,5]

(5,10]

(10,20]

(20,30]

(30,正无穷)
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
//更新操作

update table set note = '1' where num = 10;

//或者是使用实时读

SELECT * FROM table WHERE num = 10 for UPDATE;
- 1
- 2
- 3
- 4
如果num是唯一性索引,那么只需要对num为10的这条索引加锁就行了(就加一个Record lock锁),因为不用担心其他事务再插入一条num为10的数据,因为会有唯一性判断。但是如果num是非唯一性索引,为了防止事务执行过程中有num为10的数据插入,那么会对(5,10]和(10,20]这两个区间加锁。
除了next-key locking, 还有 previous-key locking 技术。对索引10 、11 、13 和20,若采用previous-key locking 技术,那么可锁定的区间为:(-∞,10),[10,11),[11,13),[13,20),[20, +∞)。
例子1(加锁):
创建表:
CREATE TABLE z (a INT, b INT, PRIMARY KEY(a) , KEY(b));

INSERT INTO z SELECT 1,1;

INSERT INTO z SELECT 3,1;

INSERT INTO z SELECT 5,3;

INSERT INTO z SELECT 7,6;

INSERT INTO z SELECT 10,8;
- 1
- 2
- 3
- 4
- 5
- 6
表z 的列b 是辅助索引,若在会话A 中执行下面的SQL 语句:
SELECT* FROM z WHERE b=3 FOR UPDATE
- 1
这时SQL 语句通过索引列 b 进行查询,因此其使用传统的Next-Key Locking 技术加锁,并且由于有两个索引,其需要分别进行锁定:
- 对于聚集索引,其仅对列a 等于 5 的索引加上 Record Lock ;
- 而对于辅助索引,其加上的是 Next-Key Lock,锁定的范围是(1, 3], 特别需要注意的是, InnoDB 存储引擎还会对辅助索引下一个键值加上gap lock, 即还有一个辅助索引范围为(3, 6) 的锁。
因此,若在新会话B 中运行下面的SQL 语句,都会被阻塞:
SELECT * FROM z WHERE a= 5 LOCK IN SHARE MODE;

INSERT INTO z SELECT 4, 2 ;

INSERT INTO z SELECT 6, 5 ;
- 1
- 2
- 3
- 第一个SQL 语句不能执行,因为在会话A 中执行的SQL 语句已经对聚集索引中列a=5 的值加上 X 锁,因此执行会被阻塞;
- 第二个SQL 语句,主键插入4, 没有问题,但是插入的辅助索引值2 在锁定的范围 (1, 3] 中,因此执行同样会被阻塞;
- 第三个SQL 语句,插入的主键6 没有被锁定, 5 也不在范围 (1, 3] 之间。但插入的值5 在另一个锁定的范围 (3, 6) 中,故同样需要等待。
而下面的SQL 语句,不会被阻塞,可以立即执行:
INSERT INTO z SELECT 8,6;

INSERT INTO z SELECT 2,0;

INSERT INTO z SELECT 6,7;
- 1
- 2
- 3
例子2(幻读):
事务 T1 执行如下的SQL 语句:
SELECT * FROM t WHERE a > 2 FOR UPDATE;
- 1
注意这时事务 T1 并没有进行提交操作,上述应该返回 5 这个结果。若与此同时,另一个事务T2 插入了4 这个值,并且数据库允许该操作,那么事务T1 再次执行上述 SQL 语句会得到结果4 和5 。这与第一次得到的结果不同,违反了事务的隔离性,即当前事务能够看到其他事务的结果。
lnnoDB 存储引擎采用Next-Key Locking 的算法避免 Phantom Problem 。对于上述的SQL 语句SELECT * FROM t WHERE a>2 FOR UPDATE, 其锁住的不是5 这单个值,而是对(2, +∞)这个范围加了X 锁。因此任何对于这个范围的插入都是不被允许的,从而避免Phantom Problem 。InnoDB 存储引擎默认的事务隔离级别是REPEATABLE READ, 在该隔离级别下,其采用Next-Key Locking 的方式来加锁。而在事务隔离级别READ COMMITTED 下,其仅采用Record Lock, 因此在上述的示例中,会话A 需要将事务的隔离级别设置为READ COMMITTED。
并发事务带来的问题
相对于串行处理来说,并发事务处理能大大增加数据库资源的利用率,提高数据库系统的事务吞吐量,从而可以支持可以支持更多的用户。但并发事务处理也会带来一些问题,主要包括以下几种情况。
脏读(Dirty Reads):一个事务正在对一条记录做修改,在这个事务并提交前,这条记录的数据就处于不一致状态;这时,另一个事务也来读取同一条记录,如果不加控制,第二个事务读取了这些“脏”的数据,并据此做进一步的处理,就会产生未提交的数据依赖关系。这种现象被形象地叫做“脏读”。简单来说就是读取了未提交的数据。
不可重复读(Non-Repeatable Reads):一个事务在读取某些数据已经发生了改变、或某些记录已经被删除了!这种现象叫做“不可重复读”。简单来说就是两次读取时数据不一样。
幻读(Phantom Reads):一个事务按相同的查询条件重新读取以前检索过的数据,却发现其他事务插入了满足其查询条件的新数据,这种现象就称为“幻读”。简单来说就是两次读取的数据总数不一样。
更新丢失(Lost Update):当两个或多个事务选择同一行,然后基于最初选定的值更新该行时,由于每个事务都不知道其他事务的存在,就会发生丢失更新问题——最后的更新覆盖了其他事务所做的更新。一般有两类:回滚丢失和覆盖丢失。
看了例子:
- 事务T1查询一行数据,放入本地内存,并显示给一个终端用户User1。
- 事务T2 也查询该行数据,并将取得的数据显示给终端用户User2 。
- User1 修改这行记录,更新数据库并提交。
- User2 修改这行记录,更新数据库并提交。
显然,这个过程中用户 User1 的修改更新操作 “丢失” 了。
脏读、不可重复读、幻读三个问题都是由事务A对数据进行修改、增加,事务B总是在做读操作。如果两事务都在对数据进行修改则会导致更新丢失。
阻塞
因为不同锁之间的兼容性关系,在有些时刻一个事务中的锁需要等待另一个事务中的锁释放它所占用的资源,这就是阻塞。阻塞并不是一件坏事,其是为了确保事务可以并发且正常地运行。
在InnoDB 存储引擎中,参数 innodb_lock_wait_timeout 用来控制等待的时间(默认是50 秒), innodb_rollback_on_timeout 用来设定是否在等待超时时对进行中的事务进行回滚操作(默认是OFF, 代表不回滚)。参数innodb_lock_wait_timeout 是 动态的,可以在MySQL 数据库运行时进行调整。而innodb_rollback_on_timeout 是 静态 的,不可在启动时进行修改。当发生超时, MySQL 数据库会抛出一个1205 的错误。
在默认情况下InnoDB 存储引擎不会回滚超时引发的错误异常。其实InnoDB 存储引擎在大部分情况下都不会对异常进行回滚。
死锁
死锁是指两个或两个以上的事务在执行过程中,因争夺锁资源而造成的一种互相等待的现象。若无外力作用,事务都将无法推进下去。
死锁问题的解决方法:
解决死锁问题最简单的方式是不要有等待,将任何的等待都转化为 回滚,并且事务重新开始。毫无疑问,这的确可以避免死锁问题的产生。然而在线上环境中,这可能导致 并发性能的下降,甚至任何一个事务都不能进行。而这所带来的问题远比死锁问题更为严重,因为这很难被发现并且浪费资源。
解决死锁问题最简单的一种方法是 超时,即当两个事务互相等待时,当一个等待时间超过设置的某一阙值时,其中一个事务进行回滚,另一个等待的事务就能继续进行。在 InnoDB 存储引擎中,参数innodb_lock_wait_ timeout 用来设置超时的时间。
超时机制虽然简单,但是其仅通过超时后对事务进行回滚的方式来处理,或者说其是根据 FIFO 的顺序选择回滚对象。但若超时的事务所占权重比较大,如事务操作更新了很多行,占用了较多的undo log,这时采用FIFO 的方式,就显得不合适了,因为回滚这个事务的时间相对另一个事务所占用的时间可能会很多。因此,除了超时机制,当前数据库还都普遍采用 wait-for graph (等待图)的方式来进行死锁检测。较之超时的解决方案,这是一种更为主动的死锁检测方式。InnoDB 存储引擎也采用的这种方式。
wait-for graph(等待图) :这是一种更为主动的死锁检测方式,要求数据库保存以下两种信息:锁的信息链表、事务等待链表。通过上述链表可以构造出一张图,而在这个图中若存在回路,就代表存在死锁,因此资源间相互发生等待。
在wait-for graph 中,事务为图中的节点。而在图中,事务 T1 指向 T2 边的定义为:事务 T1 等待事务T2 所占用的资源,事务 T1 最终等待 T2 所占用的资源,也就是事务之间在等待相同的资源,而事务 T1 发生在事务 T2 的后面。如下图:
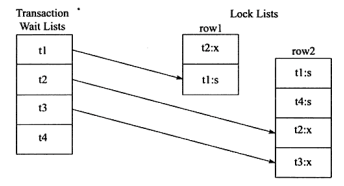
在事务等待列表中可以看到共有4 个事务 t1 、t2 、t3 、t4, 故在 wait-for graph 中应有4 个节点。而事务t2 对row1 占用x 锁,事务 t1 对row2 占用s 锁。事务 t1 需要等待事务t2 中 row1 的资源,因此在wait-for graph 中有条边从节点t1 指向节点t2 。事务t2 需要等待事务t1 、t4 所占用的row2 对象,故而存在节点t2 到节点t1 、t4 的边。同样,存在节点t3 到节点t1 、t2 、t4 的边,因此最终的wait-for graph 如下图:
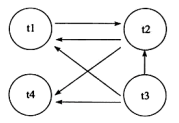
通过图上图可以发现存在回路(t1, t2), 因此存在死锁。通过上述的介绍,可以发现wait-for graph 是一种较为主动的死锁检测机制,在每个事务请求锁并发生等待时都会判断是否存在回路,若存在则有死锁,通常来说InnoDB 存储引擎选择回滚undo 量最小的事务。
wait-for graph 的死锁检测通常采用 深度优先 的算法实现,在InnoDBl.2 版本之前,都是采用递归方式实现。而从1.2 版本开始,对wait-for graph 的死锁检测进行了优化,将递归用非递归的方式实现,从而进一步提高了InnoDB 存储引擎的性能。
锁升级
锁升级(Lock Escalation) 是指 将当前锁的粒度降低。举例来说,数据库可以把一个表的1000 个行锁升级为一个页锁,或者将页锁升级为表锁。如果在数据库的设计中认为锁是一种稀有资源,而且想避免锁的开销,那数据库中会频繁出现锁升级现象。
Microsoft SQL Server 数据库的设计认为 锁是一种稀有的资源,在适合的时候会自动地将行、键或分页锁 升级为更粗粒度的表级锁。这种升级保护了系统资源,防止系统使用太多的内存来维护锁,在一定程度上提高了效率。
即使在Microsoft SQL Server 2005 版本之后, SQL Server 数据库支持了行锁,但是其设计和lnnoDB 存储引擎完全不同,在以下情况下依然可能发生锁升级:
- 由一句单独的SQL 语句在一个对象上持有的锁的数量超过了阙值,默认这个阙值为5000 。值得注意的是,如果是不同对象,则不会发生锁升级;
- 锁资源占用的内存超过了激活内存的40% 时就会发生锁升级。
在Microsoft SQL Server 数据库中,由于锁是一种稀有的资源,因此 锁升级会带来一定的效率提高。但是锁升级带来的一个问题却是因为锁粒度的降低(行或者页锁---->表锁)而导致 并发性能的降低。
InnoDB 存储引擎不存在锁升级的问题。因为其不是根据每个记录来产生行锁的,相反,其根据每个事务访问的每个页对锁进行管理的,采用的是 位图 的方式。因此不管一个事务锁住页中一个记录还是多个记录,其开销通常都是一致的。
假设一张表有3 000 000 个数据页,每个页大约有100 条记录,那么总共有300 000 000条记录。若有一个事务执行全表更新的SQL 语句,则需要对所有记录加X 锁。若根据每行记录产生锁对象进行加锁,并且每个锁占用10 字节,则仅对锁管理就需要差不多需要3GB 的内存。而InnoDB 存储引擎根据页进行加锁,并采用位图(使用比特位标记(映射)这些数据,一般用数组表示)方式,假设每个页存储的锁信息占用30 个字节,则锁对象仅需90MB 的内存。由此可见两者对于锁资源开销的差距之大。
锁的实现
行锁在InnoDB中的数据结构如下:
typedef struct lock_rec_struct		lock_rec_t

struct lock_rec_struct{

	ulint space;	/*space id*/

	ulint page_no;	/*page number*/

	unint n_bits;	/*number of bits in the lock bitmap*/

}
- 1
- 2
- 3
- 4
- 5
- 6
InnoDB中根据页的组织形式进行锁管理,并使用位图记录锁信息。
n_bits变量表示位图占用的字节数,它后面紧跟着一个bitmap,bitmap占用的字节为:1 + (nbits-1)/8,bitmap中的每一位标识对应的行记录是否加锁。
因此,lock_rec_struct占用的实际存储空间为:sizeof(lock_rec_struct) + 1 + (nbits-1)/8
表级锁的数据结构(用于表的意向锁和自增锁):
typedef struct lock_table_struct lock_table_t;

struct lock_table_struct {

	dict_table_t*          table;	/*database table in dictionary cache*/

	UT_LIST_NODE_T(lock_t) locks;	/*list of locks on the same table*/

}
- 1
- 2
- 3
- 4
- 5
而事务中关联如下锁结构:
typedef struct lock_struct      lock_t;

struct lock_struct{

	trx_t*		            trx;		/* transaction owning the lock */

	UT_LIST_NODE_T(lock_t)	trx_locks;	/* list of the locks of the transaction */

	ulint		            type_mode;	/* lock type, mode, gap flag, and wait flag, ORed */

	hash_node_t         	hash;		/* hash chain node for a record lock */

	dict_index_t*           index;		/* index for a record lock */

	union {

		lock_table_t	tab_lock; /* table lock */

		lock_rec_t	    rec_lock; /* record lock */

	} un_member;

};
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
index变量指向一个索引,行锁本质是索引记录锁。
lock_struct是根据一个事务的每个页(或每个表)进行定义的。但一个事务可能在不同页上有多个行锁,trx_locks变量将一个事务所有的锁信息进行链接,这样就可以快速查询一个事务所有锁信息。
UT_LIST_NODE_T定义如下,典型的链表结构:
#define UT_LIST_NODE_T(TYPE)

struct {

       TYPE *   prev;       /* pointer to the previous node,NULL if start of list */

       TYPE *   next;       /* pointer to next node, NULL if end of list */

}
- 1
- 2
- 3
- 4
- 5
lock_struct中type_mode变量是一个无符号的32位整型,从低位排列,第1字节为lock_mode,定义如下;
/* Basic lock modes */

enum lock_mode {

	LOCK_IS = 0,	/* intention shared */

	LOCK_IX,	/* intention exclusive */

	LOCK_S,		/* shared */

	LOCK_X,		/* exclusive */

	LOCK_AUTO_INC,	/* locks the auto-inc counter of a table

			in an exclusive mode */

	LOCK_NONE,	/* this is used elsewhere to note consistent read */

	LOCK_NUM = LOCK_NONE, /* number of lock modes */

	LOCK_NONE_UNSET = 255

};
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
第2字节为lock_type,目前只用前两位,大小为 16 和 32 ,表示 LOCK_TABLE 和 LOCK_REC:
#define LOCK_TABLE      16

#define LOCK_REC        32
- 1
- 2
剩下的高位 bit 表示行锁的类型record_lock_type:
#define LOCK_WAIT   256		/* 表示正在等待锁 */

#define LOCK_ORDINARY 0 	/* 表示 Next-Key Lock ,锁住记录本身和记录之前的 Gap*/

#define LOCK_GAP    512		/* 表示锁住记录之前 Gap(不锁记录本身) */

#define LOCK_REC_NOT_GAP 1024	/* 表示锁住记录本身,不锁记录前面的 gap */

#define LOCK_INSERT_INTENTION 2048	/* 插入意向锁 */

#define LOCK_CONV_BY_OTHER 4096		/* 表示锁是由其它事务创建的(比如隐式锁转换) */
- 1
- 2
- 3
- 4
- 5
- 6
另外,除了查询某个事务所有锁信息,系统还需要查询某个具体记录的锁信息。如记录id=3是否有锁? 而InnoDB使用哈希表映射行数据和锁信息:
struct lock_sys_struct{

	hash_table_t* rec_hash;

}
- 1
- 2
- 3
每次新建一个锁对象,都要插入到lock_sys->rec_hash中。lock_sys_struct中的key通过页的space和page_no计算得到,而value则是锁对象lock_rec_struct。
因此若需查询某一行记录是否有锁,首先根据行所在页进行哈希查询,然后根据查询得到的lock_rec_struct,查找lock bitmap,最终得到该行记录是否有锁。
可以看出,根据页进行对行锁的查询并不是高效设计,但这种方式的资源开销非常小。某一事务对一个页任意行加锁开销都是一样的(不管锁住多少行)。因此也不需要支持锁升级的功能。
如果根据每一行记录进行锁信息管理,所需的开销会非常巨大。当一个事务占用太多的锁资源时,需要进行锁升级,将行锁升级为更粗粒度的锁,如页锁或表锁。
[转帖]Innodb存储引擎-锁(数据库锁的查看、快照读&当前读、MVCC、自增长与锁、外键与锁、行锁、并发事务的问题、阻塞、死锁、锁升级、锁的实现)的更多相关文章
- MySQL InnoDB存储引擎中的锁机制
1.隔离级别 Read Uncommited(RU):这种隔离级别下,事务间完全不隔离,会产生脏读,可以读取未提交的记录,实际情况下不会使用. Read Committed (RC):仅能读取到已提交 ...
- InnoDB存储引擎的锁
InnoDB存储引擎的锁 锁的类型 锁的类型包括: 1. 共享锁(S lock),允许事务读取一行数据 2. 排他锁(X lock),允许事务删除或更新一行数据 锁的兼容性a X S ...
- 《MySQL技术内幕:InnoDB存储引擎》读书笔记
一.Mysql体系结构和存储引擎 1. 概念: 数据库:物理操作系统文件或其他形式文件类型的集合.(是文件的集合,是依照某种数据模型组织起来并存放于二级存储器中的数据集合.) ...
- MySQL内核:InnoDB存储引擎 卷1
MySQL内核:InnoDB存储引擎卷1(MySQL领域Oracle ACE专家力作,众多MySQL Oracle ACE力捧,深入MySQL数据库内核源码分析,InnoDB内核开发与优化必备宝典) ...
- InnoDB 存储引擎的主要知识点介绍
本文转载自:Draveness,略有修改 原文链接:『浅入浅出』MySQL 和 InnoDB · 面向信仰编程 作为一名开发人员,在日常的工作中会难以避免地接触到数据库,无论是基于文件的 sqlite ...
- 一文带你读懂 Mysql 和 InnoDB存储引擎
作为一名开发人员,在日常的工作中会难以避免地接触到数据库,无论是基于文件的 sqlite 还是工程上使用非常广泛的 MySQL.PostgreSQL,但是一直以来也没有对数据库有一个非常清晰并且成体系 ...
- MySQL InnoDB存储引擎事务的ACID特性
1.前言 相信工作了一段时间的同学肯定都用过事务,也都听说过事务的4大特性ACID.ACID表示原子性.一致性.隔离性和持久性.一个很好的事务处理系统,必须具备这些标准特性: 原子性(Atomicit ...
- MySQL数据库InnoDB存储引擎中的锁机制
MySQL数据库InnoDB存储引擎中的锁机制 http://www.uml.org.cn/sjjm/201205302.asp 00 – 基本概念 当并发事务同时访问一个资源的时候,有可能 ...
- 三分钟入门 InnoDB 存储引擎中的表锁和行锁
各位对 "锁" 这个概念应该都不是很陌生吧,Java 语言中就提供了两种锁:内置的 synchronized 锁和 Lock 接口,使用锁的目的就是管理对共享资源的并发访问,保证数 ...
- (转)Mysql技术内幕InnoDB存储引擎-表&索引算法和锁
表 原文:http://yingminxing.com/mysql%E6%8A%80%E6%9C%AF%E5%86%85%E5%B9%95innodb%E5%AD%98%E5%82%A8%E5%BC% ...
随机推荐
- 文心一言 VS 讯飞星火 VS chatgpt (44)-- 算法导论6.1 1题
一.在高度为h的堆中,元素个数最多和最少分别是多少? 文心一言: 在高度为 h 的二叉搜索树(BST)中,元素个数最多和最少的情况分别如下: 1.最多情况:当每个节点都包含两个子节点时,BST 中的元 ...
- 火山引擎VeDI最新分享:消费行业的数据飞轮从“四更”开始
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 数据飞轮,正在为消费行业的数字化升级提供一套全新模式. 在刚刚结束的<全链路增长:数据飞轮转动消费新生力 ...
- 火山引擎DataLeap联合DataFun发布《数据治理知识地图》
近期,火山引擎DataLeap和技术社区DataFun联合发布<数据治理知识地图专业版V1>(以下简称"地图"),地图将数据治理的领域.流程.技术.工具等内容进行系统化 ...
- PPT 玩转形状
形状 https://www.cnblogs.com/vipsoft/p/16943810.html 形状也可以非常复杂 形状的神奇功能--合并形状 编辑顶点 https://www.cnblogs. ...
- Java 网络编程 —— 基于 UDP 的数据报和套接字
UDP 简介 UDP(User Datagram Protocol,用户数据报协议)是传输层的另一种协议,比 TCP 具有更快的传输速度,但是不可靠.UDP 发送的数据单元被称为 UDP 数据报,当网 ...
- flask自定义参数校验、序列化和反序列化
项目总体结构 我的工厂函数factory.py from settings import setting from flask import Flask from models.models impo ...
- 【Docker】docker介绍 什么是虚拟化 容器与虚拟机比较 Docker 概念 docker安装
目录 docker介绍 什么是虚拟化 docker是什么 容器与虚拟机比较 Docker 概念 docker安装 docker介绍 什么是虚拟化 在计算机中,虚拟化(英语:Virtualization ...
- CJ88 DUMP The ASSERT condition was violated
一.CJ88运行某个项目时DUMP,其他项目正常 The ASSERT condition was violated. 源代码位置为交易货币为空导致DUMP 经过长时间的源码调试,也只定位在查询语句这 ...
- PS 独立集中标识下修改项目采购类型增强
1.当物料独立集中标识为2,采购类型通过BAPI:BAPI_NETWORK_COMP_ADD,type_of_pur_resv传入'7',则报错"组件分配并不是未销售订单或项目库存而设的&q ...
- MIGO生产订单入库写入批次特性增强
一.生产订单入库 MIGO根据生产订单入库时,将生产订单中的字段,写入到批次特性中 二.BADI:MB_MIGO_BADI 调用BADI中的IF_EX_MB_MIGO_BADI~POST_DOCUME ...