
ASCII,Unicode,UTF-8
ASCII
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码)是基于拉丁字母的一套电脑编码系统,主要用于显示现代英语和其他西欧语言。它是现今最通用的单字节编码系统,并等同于国际标准ISO/IEC 646。
共有128个字符(十进制:0-127, 二进制:00000000-01111111)
在计算机中,所有的数据在存储和运算时都要使用二进制数表示(因为计算机用高电平和低电平分别表示1和0),例如,像a、b、c、d这样的52个字母(包括大写)、以及0、1等数字还有一些常用的符号(例如*、#、@等)在计算机中存储时也要使用二进制数来表示,而具体用哪些二进制数字表示哪个符号,当然每个人都可以约定自己的一套(这就叫编码),而大家如果要想互相通信而不造成混乱,那么大家就必须使用相同的编码规则,于是美国有关的标准化组织就出台了ASCII编码,统一规定了上述常用符号用哪些二进制数来表示。
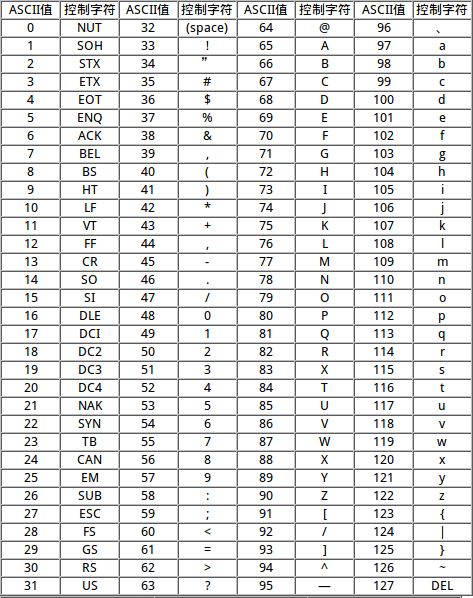
从128 到255这一页的字符集被称”扩展字符集“;
GB2312
GB2312 是对 ASCII 的中文扩展。
两个大于127的字符连在一起时,就表示一个汉字,前面的一个字节(他称之为高字节)从0xA1用到0xF7,后面一个字节(低字节)从0xA1到0xFE,这样我们就可以组合出大约7000多个简体汉字了。在这些编码里,我们还把数学符号、罗马希腊的字母、日文的假名们都编进去了,连在 ASCII 里本来就有的数字、标点、字母都统统重新编了两个字节长的编码,这就是常说的”全角”字符,而原来在127号以下的那些就叫”半角”字符了。
GBK
只要第一个字节是大于127就固定表示这是一个汉字的开始,不管后面跟的是不是扩展字符集里的内容。结果扩展之后的编码方案被称为 GBK 标准,GBK包括了GB2312 的所有内容,同时又增加了近20000个新的汉字(包括繁体字)和符号。
GB18030
后来少数民族也要用电脑了,于是我们再扩展,又加了几千个新的少数民族的字,GBK扩成了 GB18030
Unicode
Unicode(统一码、万国码、单一码)是计算机科学领域里的一项业界标准,包括字符集、编码方案等。Unicode 是为了解决传统的字符编码方案的局限而产生的,它为每种语言中的每个字符设定了统一并且唯一的二进制编码,以满足跨语言、跨平台进行文本转换、处理的要求。1990年开始研发,1994年正式公布。
UTF-8
|
Unicode编码(十六进制)
|
UTF-8 字节流(二进制)
|
|
000000-00007F
|
0xxxxxxx
|
|
000080-0007FF
|
110xxxxx 10xxxxxx
|
|
000800-00FFFF
|
1110xxxx 10xxxxxx 10xxxxxx
|
| 010000-10FFFF | 11110xxx10xxxxxx10xxxxxx10xxxxxx |
UTF-8的特点是对不同范围的字符使用不同长度的编码。对于0x00-0x7F之间的字符,UTF-8编码与ASCII编码完全相同。UTF-8编码的最大长度是6个字节。从上表可以看出,6字节模板有31个x,即可以容纳31位二进制数字。Unicode的最大码位0x7FFFFFFF也只有31位。
Unicode和UTF-8的区别:
简单来说:
- Unicode 是「字符集」
- UTF-8 是「编码规则」
其中:
- 字符集:为每一个「字符」分配一个唯一的 ID(学名为码位 / 码点 / Code Point)
- 编码规则:将「码位」转换为字节序列的规则(编码/解码 可以理解为 加密/解密 的过程)
ASCII,Unicode,UTF-8的更多相关文章
- 字符编码的故事(ASCII,ANSI,Unicode,Utf-8区别)转载
http://www.imkevinyang.com/2009/02/字符编解码的故事(ascii,ansi,unicode,utf-8区别).html 很久很久以前,有一群人,他们决定用8个可以开合 ...
- ASCII,Unicode,GBK和UTF-8字符编码的区别和联系
如果经常写python2,肯定会遇到各种“奇怪”的字符编码问题,每次都通过谷歌解决了,但是为什么会造成这种乱码.decode/encode失败等等,本文就字符和字符编码做一个总结,更加清晰区分诸多的编 ...
- 字符编码的故事:ASCII,GB2312,Unicode,UTF-8,UTF-16
http://blog.csdn.net/longintchar/article/details/51079340 ****************************************** ...
- ASCII,Unicode,UTF-8,GBK 区别
编码历史与区别 很久很久以前,有一群人,他们决定用8个可以开合的晶体管来组合成不同的状态,以表示世界上的万物.他们看到8个开关状态是好的,于是他们把这称为"字节". 再后来,他们又 ...
- 字符编码简介:ASCII,Unicode,UTF-8,GB2312
字符编码简介:ASCII,Unicode,UTF-8,GB2312 1. ASCII码 我们知道,在计算机内部,所有的信息最终都表示为一个二进制的字符串.每一个二进制位(bit)有0和 1两种状态,因 ...
- 文字编码ASCII,GB2312,GBK,GB18030,UNICODE,UCS,UTF的解析
众所周知,一个文字从输入到显示到存储是有一个固定过程的,其过程为:输入码(根据输入法不同而不同)→机内码(根据语言环境不同而不同,不同的系统语言编码也不一样)→字型码(根据不同的字体而不同)→存储码( ...
- 字符编解码的故事(ASCII,ANSI,Unicode,Utf-8区别)
(关于字符编码的深入解释,请参见我的原创文章<关于字符编码,你所需要知道的>.) 此文为转载,有少许修订,原文出处不详. 很久很久以前,有一群人,他们决定用8个可以开合的晶体管来组合成不同 ...
- 字符编解码的故事(ASCII,ANSI,Unicode,Utf-8)
很久很久以前,有一群人,他们决定用8个可以开合的晶体管来组合成不同的状态,以表示世界上的万物.他们认为8个开关状态作为原子单位很好,于是他们把这称为"字节". 再后来,他们又做了一 ...
- 字符编解码的故事–ASCII,ANSI,Unicode,Utf-8区别(转)
很久很久以前,有一群人,他们决定用8个可以开合的晶体管来组合成不同的状态,以表示世界上的万物.他们认为8个开关状态作为原子单位很好,于是他们把这称为”字节”. 再后来,他们又做了一些可以处理这些字节的 ...
随机推荐
- 应用安全 - 无文件式攻击 - 潜伏型攻击 - WMI - 汇总
wbemtest.exe Windows XP Windows 10
- [Web 前端] 025 js 的对象、数组和数学对象
1. Javascript 对象 1.1 创建对象 1.1.1 使用原始的方式创建内置对象 var myObject = new Object(); myObject.name = "lij ...
- [AGC040B]Two Contests
Description 给出若干条线段 \((L[i], R[i])\) ,把他们分成两个非空的集合,最大化集合内线段交的和. \(n\le 10 ^ 5\) Solution 考虑最小的一个右端点 ...
- javascript中的继承-寄生组合式继承
前文说过,组合继承是javascript最常用的继承模式,不过,它也有自己的不足:组合继承无论在什么情况下,都会调用两次父类构造函数,一次是在创建子类原型的时候,另一次是在子类构造函数内部.子类最终会 ...
- vue+element ui 时间格式化
<el-table-column prop="startTime" label="日期" width="200" align=&quo ...
- 2019长安大学ACM校赛网络同步赛 B Trial of Devil (递归)
链接:https://ac.nowcoder.com/acm/contest/897/B来源:牛客网 Trial of Devil 时间限制:C/C++ 1秒,其他语言2秒 空间限制:C/C++ 32 ...
- RMQ 区间最大值最小值 最频繁次数
区间的最大值和最小值 #include <cstdio> #include <cstring> #include <cmath> #include <iost ...
- C#基础知识之正则表达式
正则表达式 是一种匹配输入文本的模式..Net 框架提供了允许这种匹配的正则表达式引擎.模式由一个或多个字符.运算符和结构组成. 实例 下面的实例匹配了以 'S' 开头的单词: using Syste ...
- MySQL新增用户及赋予权限
创建用户 USE mysql; #创建用户需要操作 mysql 表 # 语法格式为 [@'host'] host 为 'localhost' 表示本地登录用户,host 为 IP地址或 IP 地址区间 ...
- windows 安装php
php各个版本下载地址:https://www.apachelounge.com/viewtopic.php?t=6359 https://museum.php.net/ https://www.fu ...