
Spark-Core RDD依赖关系
scala> var rdd1 = sc.textFile("./words.txt")

rdd1: org.apache.spark.rdd.RDD[String] = ./words.txt MapPartitionsRDD[16] at textFile at <console>:24

scala> val rdd2 = rdd1.flatMap(_.split(" "))

rdd2: org.apache.spark.rdd.RDD[String] = MapPartitionsRDD[17] at flatMap at <console>:26

scala> val rdd3 = rdd2.map((_, 1))

rdd3: org.apache.spark.rdd.RDD[(String, Int)] = MapPartitionsRDD[18] at map at <console>:28

scala> val rdd4 = rdd3.reduceByKey(_ + _)

rdd4: org.apache.spark.rdd.RDD[(String, Int)] = ShuffledRDD[19] at reduceByKey at <console>:30
1、查看 RDD 的血缘关系
scala> rdd1.toDebugString

res1: String =

(2) ./words.txt MapPartitionsRDD[1] at textFile at <console>:24 []

| ./words.txt HadoopRDD[0] at textFile at <console>:24 []
scala> rdd2.toDebugString

res2: String =

(2) MapPartitionsRDD[2] at flatMap at <console>:26 []

| ./words.txt MapPartitionsRDD[1] at textFile at <console>:24 []

| ./words.txt HadoopRDD[0] at textFile at <console>:24 []
scala> rdd3.toDebugString

res3: String =

(2) MapPartitionsRDD[3] at map at <console>:28 []

| MapPartitionsRDD[2] at flatMap at <console>:26 []

| ./words.txt MapPartitionsRDD[1] at textFile at <console>:24 []

| ./words.txt HadoopRDD[0] at textFile at <console>:24 []
scala> rdd4.toDebugString

res4: String =

(2) ShuffledRDD[4] at reduceByKey at <console>:30 []

+-(2) MapPartitionsRDD[3] at map at <console>:28 []

| MapPartitionsRDD[2] at flatMap at <console>:26 []

| ./words.txt MapPartitionsRDD[1] at textFile at <console>:24 []

| ./words.txt HadoopRDD[0] at textFile at <console>:24 []
说明:
圆括号(2): 2表示RDD的并行度,几个分区
2、查看RDD的依赖关系
scala> rdd1.dependencies

res28: Seq[org.apache.spark.Dependency[_]] = List(org.apache.spark.OneToOneDependency@70dbde75)

scala> rdd2.dependencies

res29: Seq[org.apache.spark.Dependency[_]] = List(org.apache.spark.OneToOneDependency@21a87972)

scala> rdd3.dependencies

res30: Seq[org.apache.spark.Dependency[_]] = List(org.apache.spark.OneToOneDependency@4776f6af)

scala> rdd4.dependencies

res31: Seq[org.apache.spark.Dependency[_]] = List(org.apache.spark.ShuffleDependency@4809035f)
RDD之间的关系可以从两个维度来理解:
(1)一个是RDD从哪些RDD转换而来,也就是RDD的parent RDD(s)是什么
(2)另一个是RDD依赖于parent RDD(s)的哪些 Partitions(s),这种关系称为RDD之间的依赖
RDD依赖的 2 中策略:
(1)窄依赖(transformations with narrow dependencies)
(2)宽依赖(transformations with wide dependencies)
宽依赖对 Spark 去评估一个 transformations 有更加重要的影响, 比如对性能的影响.
3、窄依赖
如果 B-RDD 是由 A-RDD 计算得到的, 则 B-RDD 就是Child RDD, A-RDD 就是 parent RDD.
如果依赖关系在设计的时候就可以确定,而不需要考虑父RDD分区中的记录。并且如果父RDD中的每个分区最多只有一个分区,这样的依赖就是窄依赖
总结:父RDD的每个分区最多被一个RDD的分区使用
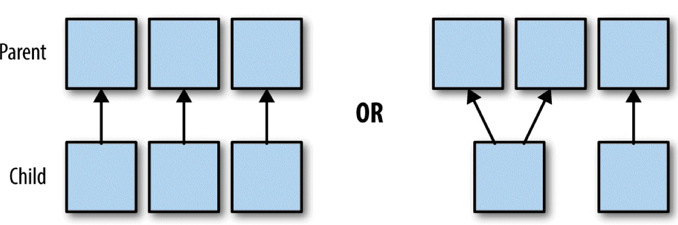
具体来说,窄依赖的时候,子RDD中的分区要么只依赖一个父RDD中的一个分区(map,filter),要么在设计的时候就能确定子RDD是父RDD的一个子集(coalesce)
所以, 窄依赖的转换可以在任何的的一个分区上单独执行, 而不需要其他分区的任何信息.
4、宽依赖
如果 父 RDD 的分区被不止一个子 RDD 的分区依赖, 就是宽依赖.
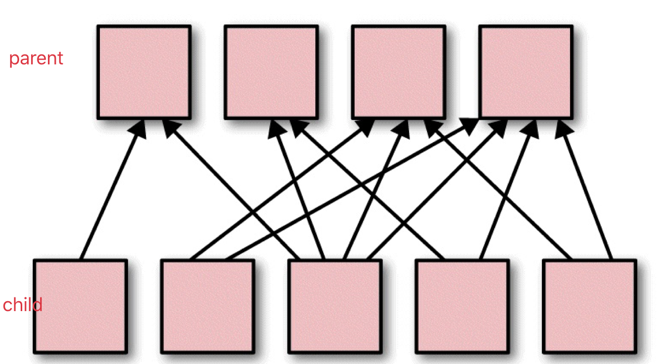
宽依赖工作的时候, 不能随意在某些记录上运行, 而是需要使用特殊的方式(比如按照 key)来获取分区中的所有数据.
例如: 在排序(sort)的时候, 数据必须被分区, 同样范围的 key 必须在同一个分区内. 具有宽依赖的 transformations 包括: sort, reduceByKey, groupByKey, join, 和调用rePartition函数的任何操作.
Spark-Core RDD依赖关系的更多相关文章
- Spark之RDD依赖关系及DAG逻辑视图
RDD依赖关系为成两种:窄依赖(Narrow Dependency).宽依赖(Shuffle Dependency).窄依赖表示每个父RDD中的Partition最多被子RDD的一个Partition ...
- RDD算子、RDD依赖关系
RDD:弹性分布式数据集, 是分布式内存的一个抽象概念 RDD:1.一个分区的集合, 2.是计算每个分区的函数 , 3.RDD之间有依赖关系 4.一个对于key-value的RDD的Partit ...
- (摘)使用 .NET Core 实现依赖关系注入
为什么使用依赖关系注入? 使用 .NET,通过 new 运算符(即,new MyService 或任何想要实例化的对象类型)调用构造函数即可轻松实现对象实例化.遗憾的是,此类调用会强制实施客户端(或应 ...
- Spark RDD概念学习系列之rdd的依赖关系彻底解密(十九)
本期内容: 1.RDD依赖关系的本质内幕 2.依赖关系下的数据流视图 3.经典的RDD依赖关系解析 4.RDD依赖关系源码内幕 1.RDD依赖关系的本质内幕 由于RDD是粗粒度的操作数据集,每个Tra ...
- [转]Spark学习之路 (三)Spark之RDD
Spark学习之路 (三)Spark之RDD https://www.cnblogs.com/qingyunzong/p/8899715.html 目录 一.RDD的概述 1.1 什么是RDD? ...
- Spark学习之路 (三)Spark之RDD
一.RDD的概述 1.1 什么是RDD? RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据抽象,它代表一个不可变.可分区.里面的元素 ...
- 大数据技术之_27_电商平台数据分析项目_02_预备知识 + Scala + Spark Core + Spark SQL + Spark Streaming + Java 对象池
第0章 预备知识0.1 Scala0.1.1 Scala 操作符0.1.2 拉链操作0.2 Spark Core0.2.1 Spark RDD 持久化0.2.2 Spark 共享变量0.3 Spark ...
- Spark之RDD的定义及五大特性
RDD是分布式内存的一个抽象概念,是一种高度受限的共享内存模型,即RDD是只读的记录分区的集合,能横跨集群所有节点并行计算,是一种基于工作集的应用抽象. RDD底层存储原理:其数据分布存储于多台机器上 ...
- Spark之RDD
Spark学习之路Spark之RDD 目录 一.RDD的概述 1.1 什么是RDD? RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数 ...
随机推荐
- CodeForces-449B(单源最短路,思维)
链接: https://vjudge.net/problem/CodeForces-449B 题意: Jzzhu is the president of country A. There are n ...
- 【leetcode】Max Area of Island
国庆中秋长假过完,又要开始上班啦.先刷个题目找找工作状态. Given a non-empty 2D array grid of 0's and 1's, an island is a group o ...
- Pycharm中文显示异常
pycharm2019,中文显示乱码异常,配置了encoding为utf8还是不行,需要设置备用字体 原因是某些英文字体库不支持非英文字符,无法显示 设置fallback字体 File-setting ...
- sql 查询 某字段是否重复
select count(*) from ( select * from 客户 )C GROUP BY 客户编码 select * from ( select count(*)num from ( s ...
- android stadio gradle问题
https://www.jianshu.com/p/2bb0b6a7b479 https://www.jianshu.com/p/d175bef9770c Unable to resolve depe ...
- Selenium 多表单(frame/iframe)切换
frame标签有frameset.frame.iframe三种,frameset跟其他普通标签没有区别,不会影响到正常的定位,而frame与iframe需要切换进去才能定位到其中的元素 比如下面这个网 ...
- C和C++中的副本机制
函数的形参.return 都有副本机制.数组没有副本机制 (为了节约内存) 函数形参和局部变量的生命周期.函数调用结束后就会被回收.
- [BZOJ4456][ZJOI2016]旅行者:分治+最短路
分析 类似于点分治的思想,只统计经过分割线的最短路,然后把地图一分为二. 代码 #include <bits/stdc++.h> #define rin(i,a,b) for(regist ...
- 在一个tomcat中配置多个tomcat服务器 111
<Service name="Tomcat_1"> <Connector port="8888" protocol="HTT ...
- Python爬取中文页面的时候出现的乱码问题(续)
我在上一篇博客中说明了在爬取数据的时候,把数据写入到文件的乱码问题 在这一篇里面我做一个总结: 1.首先应该看一个案例 我把数据写在.py文件中: #coding:utf-8 s = 'hehe测试中 ...