
R_Studio(关联)使用apriori函数简单查看数据存在多少条关联规则,并按支持度降序排序输出
查看数据menu_orders.txt文件存在多少条关联规则,并按支持度降序排序输出
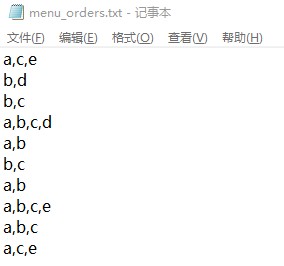
#导入arules包

install.packages("arules")

library ( arules )

setwd('D:\\data')

Gary<- read.transactions("menu_orders.txt", format = "basket", sep=",")

summary(Gary)

#查看部分规则

inspect(Gary)

#支持度0.2,置信度0.5

rules0=apriori(Gary,parameter=list(support=0.2,confidence=0.5))

#按支持度降序排序输出

rules0.sorted_sup = sort(rules0, by="support")

#读取rules0中存在多少条数据

rules0

inspect(rules0)
Gary.R
apriori函数
apriori(data, parameter = NULL, appearance = NULL, control = NULL)
data:数据
parameter 设置参数,默认情况下parameter=list(supp=0.1,conf=0.8,maxlen=10,minlen=1,target=”rules”)
supp: 支持度(support)
conf: 置信度(confidence)
maxlen,minlen: 每个项集所含项数的最大最小值(lhs+rhs的长度)
target: “rules”或“frequent itemsets”(输出关联规则/频繁项集)
apperence: 对先决条件X(lhs),关联结果Y(rhs)中具体包含哪些项进行限制,如:设置lhs=beer,将仅输出lhs含有beer这一项的关联规则。默认情况下,所有项都将无限制出现。
control: 控制函数性能,如可以设定对项集进行升序sort=1或降序sort=-1排序,是否向使用者报告进程(verbose=F/T)
排序:
通过支持度控制:rules.sorted_sup = sort(rules, by=”support”)
通过置信度控制:rules.sorted_con = sort(rules, by=”confidence”)
通过提升度控制:rules.sorted_lift = sort(rules, by=”lift”)
read.transactions(file, format =c("basket", "single"), sep = NULL,

           cols = NULL, rm.duplicates =FALSE, encoding = "unknown")

file:文件名,对应click_detail中的“click_detail.txt”

format:文件格式,可以有两种,分别为“basket”,“single”,click_detail.txt中用的是basket。basket: basket就是篮子,一个顾客买的东西都放到同一个篮子,所有顾客的transactions就是一个个篮子的组合        结果。如下形式,每条交易都是独立的。single: single的意思,顾名思义,就是单独的交易,简单说,交易记录为:顾客1买了产品1, 顾客1买了产品2,顾客2买了产品3……(产品1,产品2,产品3中可以是单个产品,也可以是多个产品)

sep:文件中数据是怎么被分隔的,默认为空格,click_detail里面用逗号分隔

cols:对basket, col=1,表示第一列是数据的transaction ids(交易号),如果col=NULL,则表示数据里面没有交易号这一列;对single,col=c(1,2)表示第一列是transaction ids,第二列是item ids

rm.duplicates:是否移除重复项,默认为FALSE

encoding:写到这里研究了encoding是什么意思,发现前面txt可以不是”ANSI”类型,如果TXT是“UTF-8”,写encoding=”UTF-8”。
read.transactions函数
实现过程
读取数据并展示
> setwd('D:\\data')

> Gary<- read.transactions("menu_orders.txt", format = "basket", sep=",")

> summary(Gary)

transactions as itemMatrix in sparse format with

 10 rows (elements/itemsets/transactions)                  #10行(元素/项集/事务)

 5 columns (items) and a density of 0.54            #5列(项)和0.54的密度

most frequent items:

      b       a       c       e       d (Other)

      8       7       7       3       2       0

element (itemset/transaction) length distribution:      #元素(项集/事务)长度分布

sizes

2 3 4

5 3 2

   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.

    2.0     2.0     2.5     2.7     3.0     4.0

includes extended item information - examples:

  labels

1      a

2      b

3      c
查看部分规则
> inspect(Gary)

     items

[1]  {a,c,e}

[2]  {b,d}

[3]  {b,c}

[4]  {a,b,c,d}

[5]  {a,b}

[6]  {b,c}

[7]  {a,b}

[8]  {a,b,c,e}

[9]  {a,b,c}

[10] {a,c,e}
支持度0.2,置信度0.5
> rules0=apriori(Gary,parameter=list(support=0.2,confidence=0.5))

Apriori

Parameter specification:

 confidence minval smax arem  aval originalSupport maxtime support minlen maxlen target   ext

        0.5    0.1    1 none FALSE            TRUE       5     0.2      1     10  rules FALSE

Algorithmic control:                    #算法控制:

 filter tree heap memopt load sort verbose       #过滤树堆

    0.1 TRUE TRUE  FALSE TRUE    2    TRUE

Absolute minimum support count: 2             #绝对最小支持计数:2

set item appearances ...[0 item(s)] done [0.00s].

set transactions ...[5 item(s), 10 transaction(s)] done [0.00s].

sorting and recoding items ... [5 item(s)] done [0.00s].

creating transaction tree ... done [0.00s].

checking subsets of size 1 2 3 done [0.00s].

writing ... [18 rule(s)] done [0.00s].

creating S4 object  ... done [0.00s].
按支持度降序排序输出
> rules0.sorted_sup = sort(rules0, by="support")

> rules0

set of 18 rules
#根据支持度对求得的关联规则子集进行查看

> inspect(rules0)

     lhs      rhs support confidence lift      count

[1]  {}    => {c} 0.7     0.7000000  1.0000000 7

[2]  {}    => {b} 0.8     0.8000000  1.0000000 8

[3]  {}    => {a} 0.7     0.7000000  1.0000000 7

[4]  {d}   => {b} 0.2     1.0000000  1.2500000 2

[5]  {e}   => {c} 0.3     1.0000000  1.4285714 3

[6]  {e}   => {a} 0.3     1.0000000  1.4285714 3

[7]  {c}   => {b} 0.5     0.7142857  0.8928571 5

[8]  {b}   => {c} 0.5     0.6250000  0.8928571 5

[9]  {c}   => {a} 0.5     0.7142857  1.0204082 5

[10] {a}   => {c} 0.5     0.7142857  1.0204082 5

[11] {b}   => {a} 0.5     0.6250000  0.8928571 5

[12] {a}   => {b} 0.5     0.7142857  0.8928571 5

[13] {c,e} => {a} 0.3     1.0000000  1.4285714 3

[14] {a,e} => {c} 0.3     1.0000000  1.4285714 3

[15] {a,c} => {e} 0.3     0.6000000  2.0000000 3

[16] {b,c} => {a} 0.3     0.6000000  0.8571429 3

[17] {a,c} => {b} 0.3     0.6000000  0.7500000 3

[18] {a,b} => {c} 0.3     0.6000000  0.8571429 3
R_Studio(关联)使用apriori函数简单查看数据存在多少条关联规则,并按支持度降序排序输出的更多相关文章
- C++ 排序函数 sort(),qsort()的含义与用法 ,字符串string 的逆序排序等
上学时我们很多学了很多种排序算法,不过在c++stl中也封装了sort等函数,头文件是#include <algorithm> 函数名 功能描述 sort 对给定区间所有元素进行排序 st ...
- vuejs通过filterBy,orderBy实现搜索筛选,降序排序数据实例
直接贴代码了: 先上输入前的样子: <style> #example{margin:100px auto;width:600px;} .show{margin:10px;} #search ...
- 关联分析Apriori算法和FP-growth算法初探
1. 关联分析是什么? Apriori和FP-growth算法是一种关联算法,属于无监督算法的一种,它们可以自动从数据中挖掘出潜在的关联关系.例如经典的啤酒与尿布的故事.下面我们用一个例子来切入本文对 ...
- 数据挖掘-关联分析 Apriori算法和FP-growth 算法
•1.关联分析概念 关联分析是从大量数据中发现项集之间有趣的关联和相关联系. •定义:1.事务:每一条交易称为一个事务,如上图包含5个事务.2.项:交易的每一个物品称为一个项,例如豆奶,啤酒等. ...
- 大数据作业之利用MapRedeuce实现简单的数据操作
Map/Reduce编程作业 现有student.txt和student_score.txt.将两个文件上传到hdfs上.使用Map/Reduce框架完成下面的题目 student.txt 20160 ...
- R_Studio(关联)对dvdtrans.csv数据进行关联规则分析
dvdtrans.csv数据:该原始数据仅仅包含了两个字段(ID, Item) 用户ID,商品名称(共30条) #导入arules包 #install.packages("arules&qu ...
- 【新人赛】阿里云恶意程序检测 -- 实践记录10.13 - Google Colab连接 / 数据简单查看 / 模型训练
1. 比赛介绍 比赛地址:阿里云恶意程序检测新人赛 这个比赛和已结束的第三届阿里云安全算法挑战赛赛题类似,是一个开放的长期赛. 2. 前期准备 因为训练数据量比较大,本地CPU跑不起来,所以决定用Go ...
- VC API常用函数简单例子大全(1-89)
第一个:FindWindow根据窗口类名或窗口标题名来获得窗口的句柄,该函数返回窗口的句柄 函数的定义:HWND WINAPI FindWindow(LPCSTR lpClassName ,LPCST ...
- R_Studio(关联)对Groceries数据集进行关联分析
RGui的arules程序包里含有Groceries数据集,该数据集是某个杂货店一个月真实的交易记录,共有9835条消费记录,169个商品 #install.packages("arules ...
随机推荐
- 通过PlayBook部署Zabbix
编写Linux初始化剧本 初始化剧本环节,主要用户实现关闭Selinux关闭防火墙,一起配置一下阿里云的YUM源地址,和安装EPEL源,为后期的zabbix安装做好铺垫工作. 1.在安装Zabbix之 ...
- Bicolored RBS CodeForces - 1167D (括号)
建树, 然后高度最大值的最小值显然为$\lceil \frac{dep}{2}\rceil$, 将$>\frac{dep}{2}$的全部分出去即可. #include <sstream&g ...
- Echarts饼图将数据显示在 legend 旁边
不多废话,笔记如下 var myEcharts = echarts.init(document.getElementById('doughnut')); option = { tooltip: { t ...
- 动态表和C++ vector
动态表和C++ vector 最近课上刚刚学了可以根据表中元素的插入和删除动态调整表大小的动态表(dynamic table),就想看一下它有什么实际的应用,第一个想起来的就是C++的vector,直 ...
- |、&、||、&&、^符号含义
|和&为计算机中二进制之间的位运算 在计算机中二进制的0表示false,1表示true. |为位运算中的或运算:它的运算逻辑为一真则真,全假则假 &为位运算中的并运算:它的运算逻辑为一 ...
- 13 UA池和代理池
一. 下载中间件 框架图 下载中间件(Downloader Middlewares) 位于scrapy引擎和下载器之间的一层组件. - 作用: (1)引擎将请求传递给下载器过程中, 下载中间件可以对请 ...
- postMessage解决iframe跨域问题
转:https://juejin.im/post/5b8359f351882542ba1dcc31 https://juejin.im/post/590c3983ac502e006531df11 ht ...
- 快速入门 Pandas
先po几个比较好的Pandas入门网站十分钟入门:http://www.codingpy.com/article/a-quick-intro-to-pandas/手册前2章:http://pda.re ...
- java并发编程:锁的相关概念介绍
理解同步,最好先把java中锁相关的概念弄清楚,有助于我们更好的去理解.学习同步.java语言中与锁有关的几个概念主要是:可重入锁.读写锁.可中断锁.公平锁 一.可重入锁 synchronized和R ...
- HashMap原理探究
一.写随笔的原因:HashMap我们在平时都会用,一般面试题也都会问,借此篇文章分析下HashMap(基于JDK1.8)的源码. 二.具体的内容: 1.简介: HashMap在基于数组+链表来实现的, ...