
Python+Selenium练习篇之1-摘取网页上全部邮箱
前面已经介绍了Python+Selenium基础篇,通过前面几篇文章的介绍和练习,Selenium+Python的webUI自动化测试算是入门了。接下来,我计划写第二个系列:练习篇,通过一些练习,了解和掌握一些Selenium常用的接口或者方法。
练习场景:在某一个网页上有些字段是我们感兴趣的,我们希望摘取出来,进行其他操作。但是这些字段可能在一个网页的不同地方。例如,我们需要在关于百度页面-联系我们,摘取全部的邮箱。
思路拆分:
1. 首先,需要得到当前页面的source内容,就像,打开一个页面,右键-查看页面源代码。
2. 找出规律,通过正则表达式去摘取匹配的字段,存储到一个字典或者列表。
3. 循环打印字典或列表中内容,Python中用 for 语句实现。
技术角度实现相关方法:
1. 查看页面的源代码,在Selenium中有driver.page_source 这个方法得到
2. Python中利用正则,需要导入re模块
3. for email in emails :
print email
想法技术角度方法都找到,我们新建一个extract_email.py 文件,输入如下代码:
# coding=utf-8
from selenium import webdriver
import re
driver = webdriver.Chrome()
driver.maximize_window()
driver.implicitly_wait(6)
driver.get("http://home.baidu.com/contact.html")
# 得到页面源代码
doc = driver.page_source
emails = re.findall(r'[\w]+@[\w\.-]+',doc) # 利用正则,找出 xxx@xxx.xxx 的字段,保存到emails列表
# 循环打印匹配的邮箱
for email in emails:
print (email)
解释:
在python正则表达式语法中,Python中字符串前面加上 r 表示原生字符串,用\w表示匹配字母数字及下划线。re模块下findall方法返回的是一个匹配子字符串的列表。
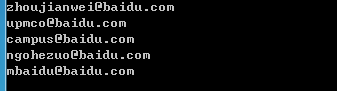
运行结果:
Python+Selenium练习篇之1-摘取网页上全部邮箱的更多相关文章
- Python+Selenium之摘取网页上全部邮箱
本文转载:http://blog.csdn.net/u011541946/article/details/68485981 练习场景:在某一个网页上有些字段是我们感兴趣的,我们希望摘取出来,进行其他操 ...
- Python+Selenium练习篇之18-获取元素上面的文字
本文介绍如何通过Selenium方法来获取某一个元素的text属性值.在很多自动化测试脚本中,需要多次获取元素的text值,拿过来进行对比和匹配.例如,在一个登陆界面,如果不输入用户名和密码,直接点击 ...
- Python+Selenium练习篇之11-浏览器上前进和后退操作
本文来介绍上如何,利用webdriver中的方法来演示浏览器中地址栏旁边的前进和后退功能. 相关脚本代码如下: # coding=utf-8import timefrom selenium impor ...
- Python+Selenium中级篇之8-Python自定义封装一个简单的Log类《转载》
Python+Selenium中级篇之8-Python自定义封装一个简单的Log类: https://blog.csdn.net/u011541946/article/details/70198676
- Python+Selenium基础篇之4-XPath的使用
开始写自动化脚本之前,我们先学习几个概念,在完全掌握了这几个概念之后,有助于我们快速上手,如何去编写自动化测试脚本. 元素,在这个教程系列,我们说的元素之网页元素(web element).在网页上面 ...
- Python+Selenium基础篇之1-环境搭建
Python + Selenium 自动化环境搭建过程 1. 所需组建 1.1 Selenium for python 1.2 Python 1.3 Notepad++ 作为刚初学者,这里不建议使用P ...
- Python——零基础向-四行代码下载网页上的一张图片
一.确保安装了requests模块 还没安装的可以百度一下如何安装,很简单的. 这里简单的说一下方法:win+R,输入cmd,打开命令行窗口,输入命令:pip install requests ,即可 ...
- python+selenium基础篇,网页截图
代码如下: from selenium import webdriver dr=webdriver.Firefox() dr.get("https://www.baidu.com" ...
- Python+Selenium练习篇之2-利用ID定位元素
在前面一篇文章,我们介绍了如何摘取页面字段,通过正则进行匹配符合要求的字段.如果感觉有点困难,不能立马理解,没有关系.把字符串摘取放到第一篇,是因为自动化测试脚本,经常要利用字符串操作,字符串切割,查 ...
随机推荐
- 汶川大地震中的SAP成都研究院
5·12汶川地震,发生于北京时间(UTC+8)2008年5月12日(星期一)14时28分04秒,此次地震的面波震级 里氏震级达8.0Ms.矩震级达8.3Mw,地震烈度达到11度.地震波及大半个中国及亚 ...
- PHP:php遍历数组 foreach echo() list()总结
php中可以用来遍历数组的方法有很多,如有:foreach语句.list().each(),这几个也是主要的方法,现总结如下: foreach语句遍历数组 foreach语句用于循环遍历数组,每进行一 ...
- vim 编辑器的使用方法
vim 命令模式 默认打开文件为命令模式 命令行模式 shift+: 命令行模式 编辑模式 i 编辑模式 Esc 切换命令模式 命令模式 -----字符操作 i 当 ...
- Problem A: 李白打酒
Problem A: 李白打酒 Time Limit: 1 Sec Memory Limit: 128 MBSubmit: 825 Solved: 373[Submit][Status][Web ...
- 《剑指offer》【调整数组顺序使奇数位于偶数前面】(python版)
题目描述: 输入一个整数数组,实现一个函数来调整该数组中数字的顺序,使得所有的奇数位于数组的前半部分,所有的偶数位于位于数组的后半部分 思路: 我认真看了一下,题目应该是要求在原地调整,所以这里不能再 ...
- solr数据分片相关
solr操作url 使用正常的core,使用命令生成coillection solr create_collection -c students2 -d ../server/solr/my/conf ...
- 5-15 笔记 jtopo使用
Jtopo的核心对象有6个,分别是Stage(舞台对象),Scene(场景对象),Node(节点对象),Link(连线对象),Container(容器对象),Effect.Animate(动画效果) ...
- install ipython-notebook
http://it.010lm.com/os/LINUX/182036.html ipython[notebook]安装(Linux平台) 1. 环境 操作系统:ubuntukylin 2. 操作步骤 ...
- .NET AJAX实例
引用地址:http://blog.csdn.net/qianjiu/article/details/7524228 5.2 Ajax基础http://book.csdn.net/bookfiles/6 ...
- Java基础面试操作题: 获取 1-20 之间的随机数,共计 20 个,要求不能重复 获取 1-20 之间的随机数,共计 10 个,要求不能重
package com.swift; import java.util.HashSet; import java.util.Random; import java.util.Set; public c ...