
[ DLPytorch ] 线性回归&Softmax与分类模型&多层感知机
线性回归
基础知识

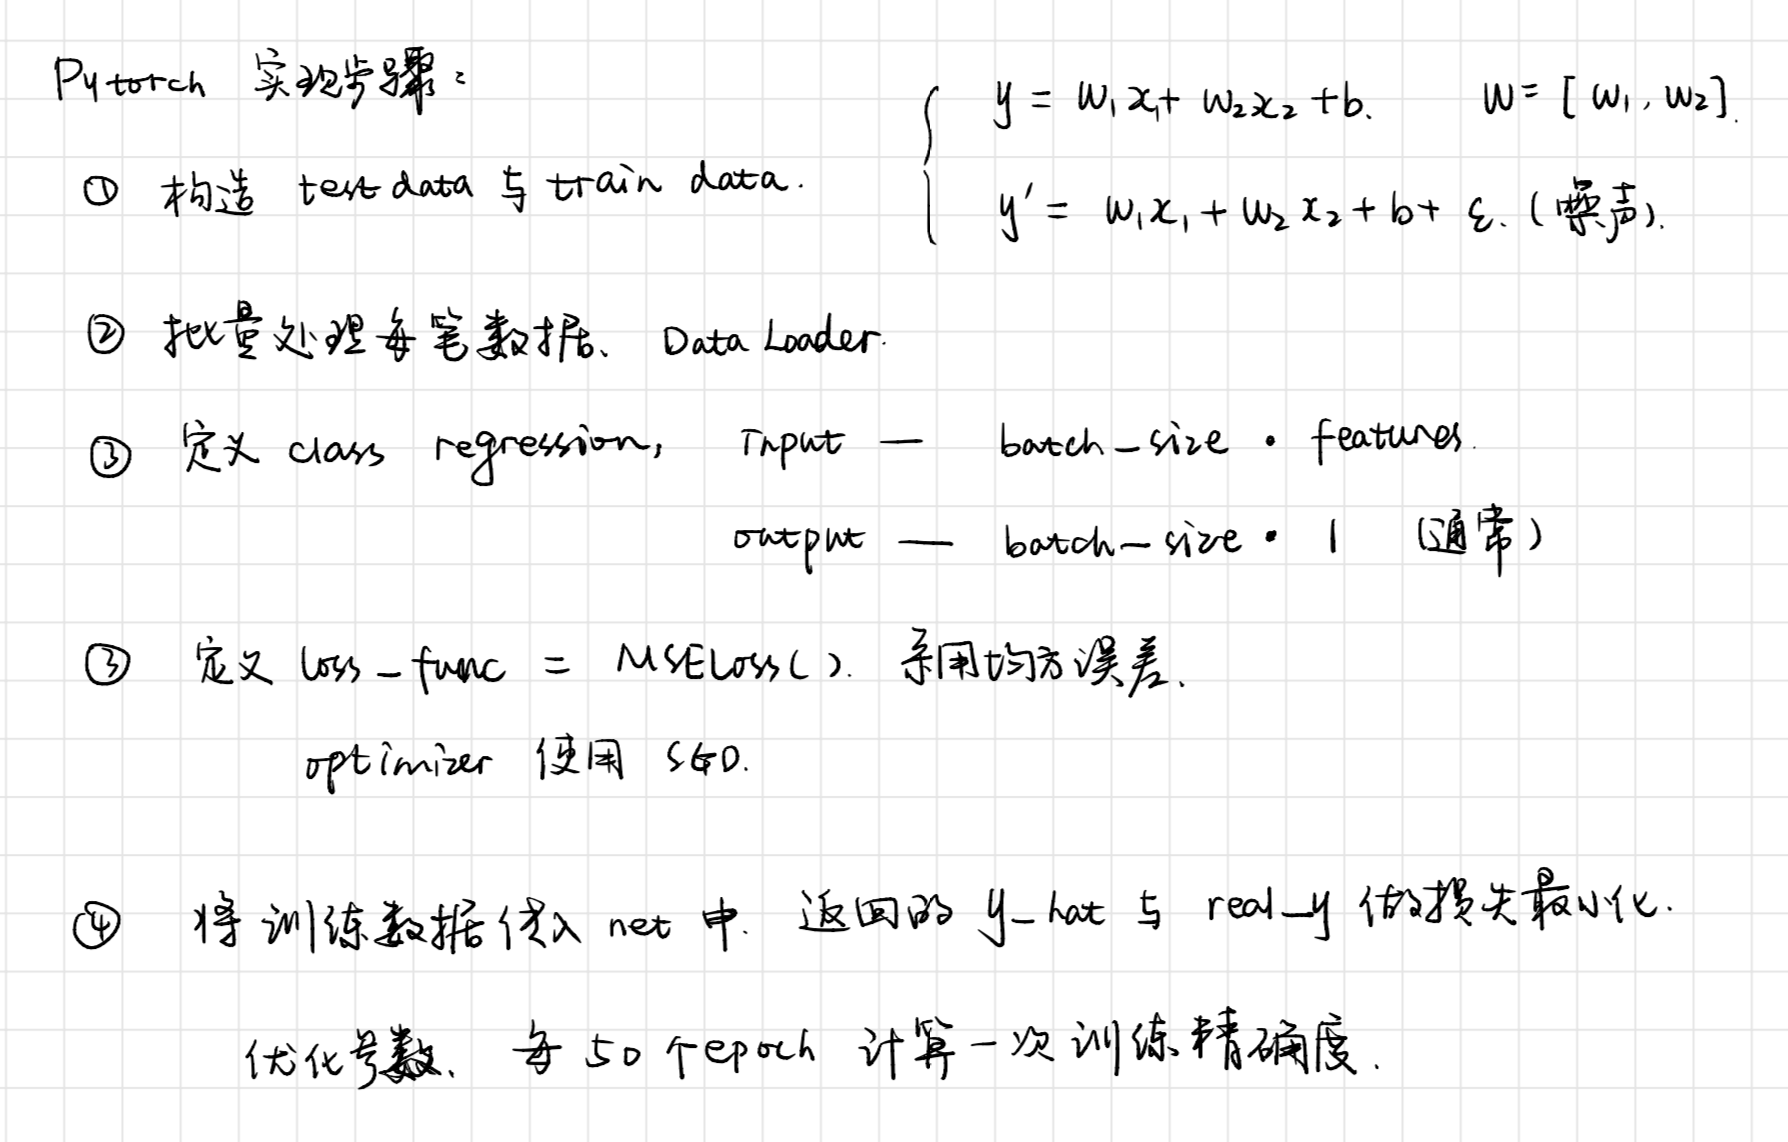
####实现过程
####学习笔记
**批量读取**
```python
torch_data = Data.TensorDataset(features, labels)
dataset = Data.DataLoader(torch_data, batch_size, shuffle=True)
```
**定义模型的两种常见写法**
这两种方法是我比较喜欢的方法。
其中有两点需要注意:
1. 虽说他们在定义时,输入和输出的神经元个数是一样的,但`print(net)`结果是不同的,法二有Sequential外层。
2. 由于第一点的原因,这也导致了在初始化参数时,`net[0].weight`应改为`net.linear.weight`,`bias`亦然。因为`net[0]`这样根据下标访问子模块的写法只有当`net`是个`ModuleList`或者`Sequential`实例时才可以
```python
#方法一
class LinearNet(nn.Module):
def __init__(self):
super(LinearNet, self).__init__()
self.l1 = nn.Linear(2,1)
def forward(self, x):

    out = self.l1(x)

    return out
net = LinearNet()
方法二
net = nn.Sequential(
nn.Linear(num_inputs, 16)
# 此处还可以传入其他层
nn.Linear(16, 1)
)
**两种方法的参数设置**
Sequential下定义一层: net.xx(层名).xx
同时也适用于法一(每层都命名)
init.normal_(net.linear.weight, mean=0, std=0.01)
init.constant_(net.linear.bias, val=0)
Sequential下定义二层: net.xx(layername)[i].xx
init.normal_(net.linearNet[0].weight, mean=0, std=0.01)
init.constant_(net.linearNet[0].bias, val=0)
**参数设置原则**

将权重初始化成均值为0、标准差为0.01的正态随机数,偏差则初始化成0。

**学习率设置**

当我们定义了多个不同的子网络时,如果有需要,也可以设置不同的学习率。

```python

optimizer =optim.SGD([

                # 如果对某个参数不指定学习率,就使用最外层的默认学习率

                {'params': net.subnet1(如:l1).parameters()}, # lr=0.03

                {'params': net.subnet2(如:l2).parameters(), 'lr': 0.01}

            ], lr=0.03)

print(optimizer)
softmax与分类模型
基础知识
####实现过程

####学习笔记
**数据下载**
因为国外网站下载特别慢,所以我直接修改了FashionMNIST的下载地址,修改成了本地,不然总是报错。
```python
train_data = torchvision.datasets.FashionMNIST(
root='./FashionMNIST',
download=DOWNLOAD_MNIST,
train=True,
transform=transforms.ToTensor()
)
```
**几个概念**
分类准确率:正确预测数量与总预测数量之比。
定义初始化模型:这里迷糊了一下,不知道为什么是[batch, 784],不过[ x ]好像就是横向的。[x1, x2, x3,x4 ...]这样。把784个像素拉长了。这样的话,输入的维度就是宽,就像压扁了一样。
遇到的问题
本次模型属于线性模型,中间没有其他的hiddenlayer。
输入为28 * 28,输出是10,是典型的多分类问题。要学习本次代码中展示样例的方法。
BATCH_SIZE 取的是256,有60000个数据,回合数是230多。
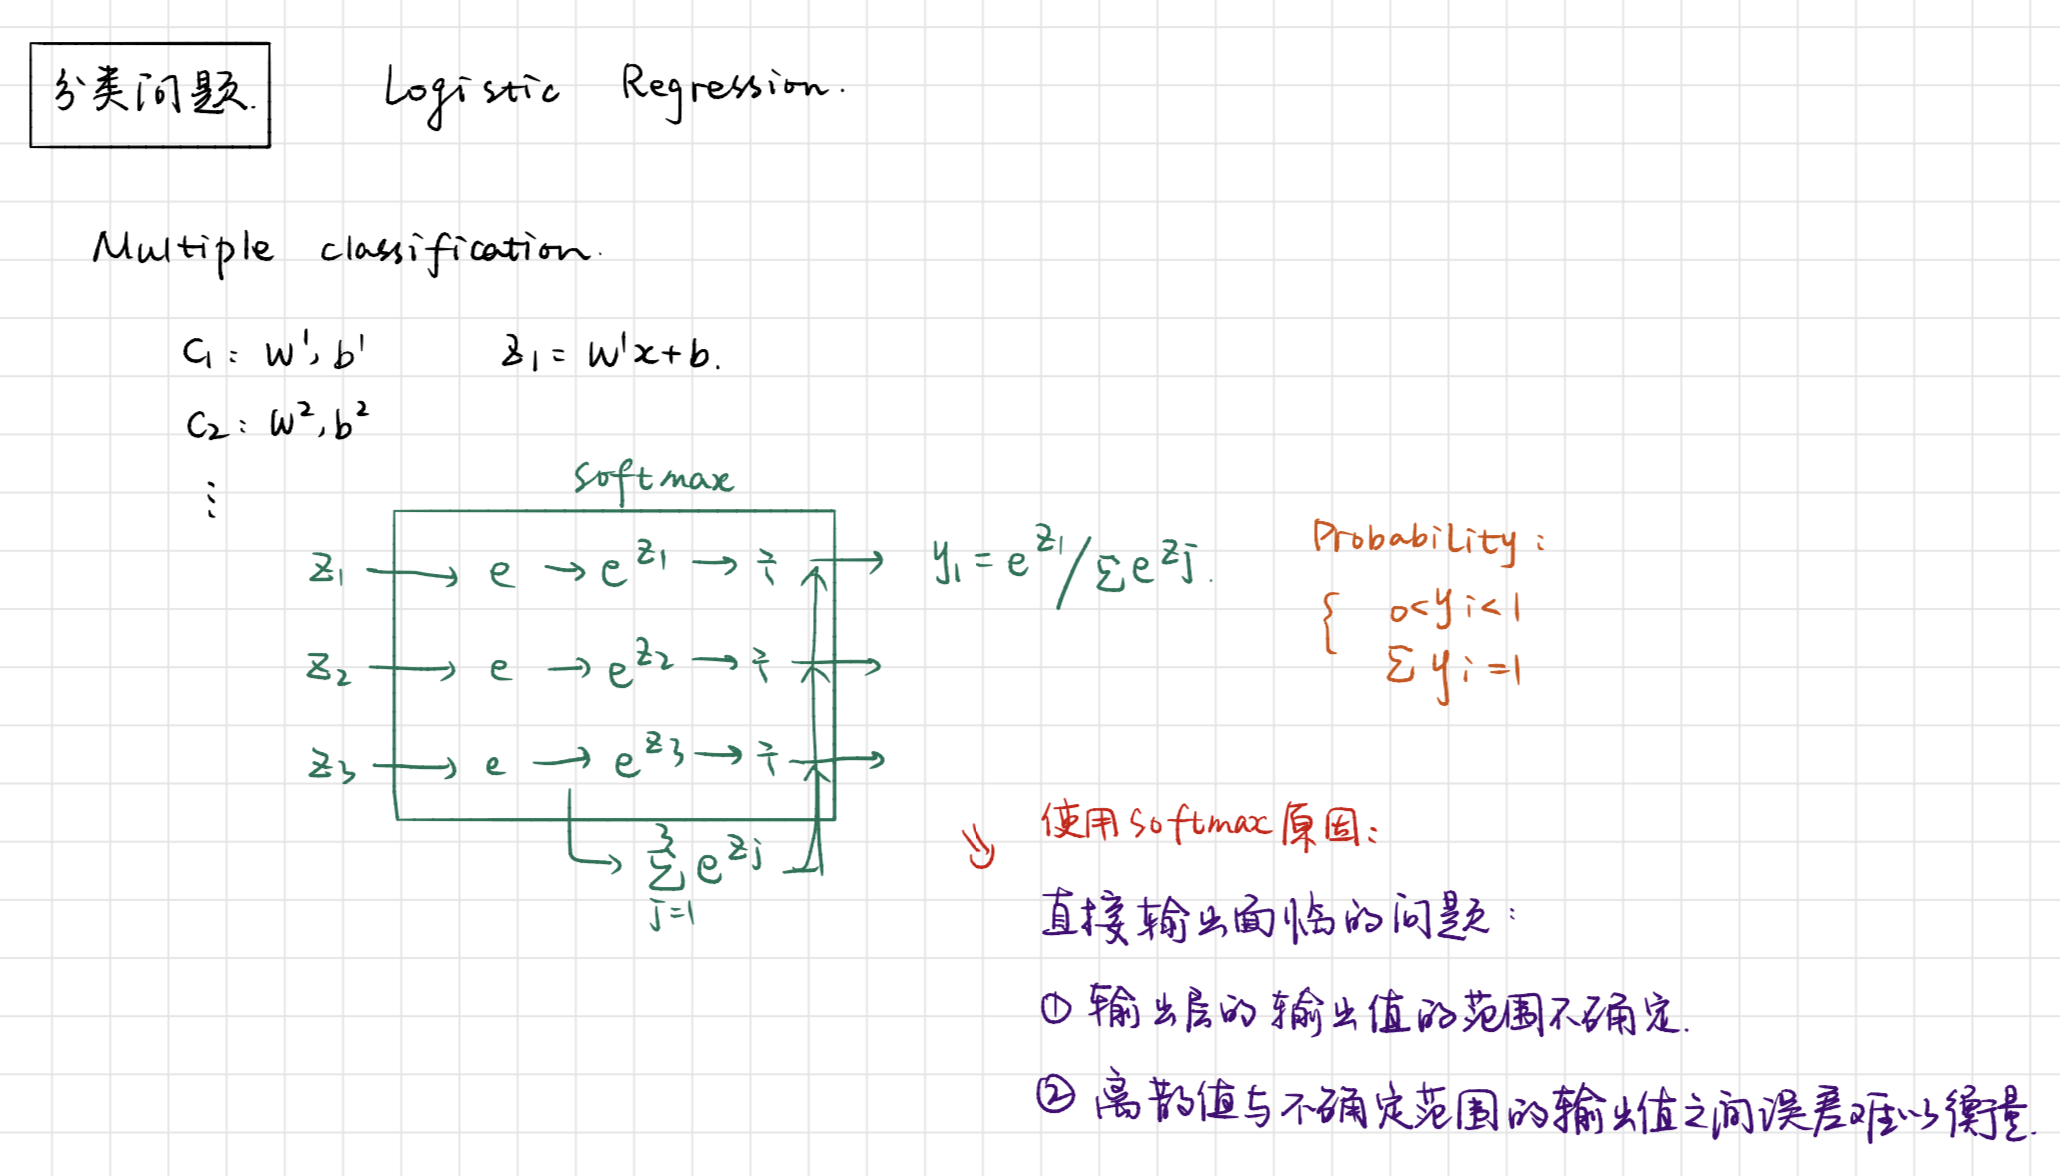
相较于连续预测不同的是,将数据x[ 256, 1, 28, 28]传入net中,输出的是[256, 10]的结果,crossentropy的计算是torch内定的。传入的数据维度是[batch, num_type]。
然后将out中的每一行通过softmax转化为和为1的矩阵,再选出每行中值最大的index与真实的y进行匹配,统计每个batch中总共有多少个正确的预测,并记录总数据元素。在一个epoch结束的时候,计算训练数据的准确度。最后的准确率大概是84%左右。
(out.argmax(dim=1) == batch_y).float().sum().item()

sum_train += batch_y.shape[0]
多层感知机
基础知识
多层感知机在单层神经网络的基础上引入了一到多个隐藏层(hidden layer)。隐藏层位于输入层和输出层之间。
实现过程
在定义net时,多加几层的Linear,神经元个数可调整。当数据量较小时,防止过拟合问题。
学习笔记
激活函数的选择
ReLu函数是一个通用的激活函数,目前在大多数情况下使用。但是,ReLU函数只能在隐藏层中使用。
用于分类器时,sigmoid函数及其组合通常效果更好。由于梯度消失问题,有时要避免使用sigmoid和tanh函数。
在神经网络层数较多的时候,最好使用ReLu函数,ReLu函数比较简单计算量少,而sigmoid和tanh函数计算量大很多。
在选择激活函数的时候可以先选用ReLu函数如果效果不理想可以尝试其他激活函数。
感知机小结
本次的测试代码大部分沿用了多分类问题的代码段。只做了少许的修改。
定义网络层结构:(之前的方法不能说错,但是可能比较适合于CNN吧
net = nn.Sequential(

        d2l.FlattenLayer(),

        nn.Linear(784, 256),

        nn.ReLU(),

        nn.Linear(256, 10),

)

print(net)
然后初始化weight和bias
init.normal_(net[1].weight, mean=0, std=0.01)

init.constant_(net[1].bias, val=0)

init.normal_(net[3].weight, mean=0, std=0.01)

init.constant_(net[3].bias, val=0)
其他地方未做改动,最后的正确率有86%左右。估计多加几层会好一些。
记录的是一些学习时候的心得,不是那么整洁。
[ DLPytorch ] 线性回归&Softmax与分类模型&多层感知机的更多相关文章
- softmax和分类模型
softmax和分类模型 内容包含: softmax回归的基本概念 如何获取Fashion-MNIST数据集和读取数据 softmax回归模型的从零开始实现,实现一个对Fashion-MNIST训练集 ...
- L2 Softmax与分类模型
softmax和分类模型 内容包含: softmax回归的基本概念 如何获取Fashion-MNIST数据集和读取数据 softmax回归模型的从零开始实现,实现一个对Fashion-MNIST训练集 ...
- 动手学习pytorch——(2)softmax和分类模型
内容太多,捡重要的讲. 在分类问题中,通常用离散的数值表示类别,这里存在两个问题.1.输出值的范围不确定,很难判断值的意义.2.真实标签是离散值,这些离散值与不确定的范围的输出值之间的误差难以衡量. ...
- Alink漫谈(十五) :多层感知机 之 迭代优化
Alink漫谈(十五) :多层感知机 之 迭代优化 目录 Alink漫谈(十五) :多层感知机 之 迭代优化 0x00 摘要 0x01 前文回顾 1.1 基本概念 1.2 误差反向传播算法 1.3 总 ...
- TensorFlow实现多层感知机MINIST分类
TensorFlow实现多层感知机MINIST分类 TensorFlow 支持自动求导,可以使用 TensorFlow 优化器来计算和使用梯度.使用梯度自动更新用变量定义的张量.本文将使用 Tenso ...
- python实现感知机线性分类模型
前言 感知器是分类的线性分类模型,其中输入为实例的特征向量,输出为实例的类别,取+1或-1的值作为正类或负类.感知器对应于输入空间中对输入特征进行分类的超平面,属于判别模型. 通过梯度下降使误分类的损 ...
- Theano3.4-练习之多层感知机
来自http://deeplearning.net/tutorial/mlp.html#mlp Multilayer Perceptron note:这部分假设读者已经通读之前的一个练习 Classi ...
- 学习笔记TF026:多层感知机
隐含层,指除输入.输出层外,的中间层.输入.输出层对外可见.隐含层对外不可见.理论上,只要隐含层节点足够多,只有一个隐含层,神经网络可以拟合任意函数.隐含层越多,越容易拟合复杂函数.拟合复杂函数,所需 ...
- (数据科学学习手札44)在Keras中训练多层感知机
一.简介 Keras是有着自主的一套前端控制语法,后端基于tensorflow和theano的深度学习框架,因为其搭建神经网络简单快捷明了的语法风格,可以帮助使用者更快捷的搭建自己的神经网络,堪称深度 ...
随机推荐
- 8.10-Day2T1最小值
题目大意 裴蜀定理 题解 很简单... 我这个蒟蒻都猜的出来... 就求所有数的最大公约数 但注意 要加绝对值 因为gcd里面不能传负数 #include<cstdio> #inc ...
- frm、myd、myi、opt、par文件
.frm 表结构文件 .myd 表数据文件 .myi 表索引文件 .opr 储存数据库的默认字符集 .par 储存分区信息 mysql 5.6版本分区表有一个文件:表名.par, 该文件在5.7.6版 ...
- AcWing 858. Prim算法求最小生成树 稀疏图
//稀疏图 #include <cstring> #include <iostream> #include <algorithm> using namespace ...
- 线段树+扫描线 NAIPC 2019 Intersecting Rectangles
你看看你有多菜,一点线段树的小小的运用,就不会写了: 题意:如果矩阵有交集,输出1,否则输出0(不包含内嵌): 思路:本题求交集,还得不包括内嵌的情况: 做过一道是求面积的题.跟这道类似,但在这里定义 ...
- glog与gflags的windows编译
参考博客:https://kezunlin.me/post/bb64e398/
- Mysql数据库内置功能之函数
一 函数 MySQL中提供了许多内置函数,例如: 一.数学函数 ROUND(x,y) 返回参数x的四舍五入的有y位小数的值 RAND() 返回0到1内的随机值,可以通过提供一个参数(种子)使RAND( ...
- git和github的关系以及简单易懂的理解
git和github的关系 写在前面:我身边好多人问我git和github的区别,想必对于好多人没学过的大佬们恐怕也是一脸懵逼,但是不知道也是不行的,所以我今天就来讲一讲这二者的区别和联系. 用一 ...
- 刷题10. Regular Expression Matching
一.题目说明 这个题目是10. Regular Expression Matching,乍一看不是很难. 但我实现提交后,总是报错.不得已查看了答案. 二.我的做法 我的实现,最大的问题在于对.*的处 ...
- .NET基础拾遗(1)类型语法基础和内存管理基础【转】
http://www.cnblogs.com/edisonchou/p/4787775.html Index : (1)类型语法.内存管理和垃圾回收基础 (2)面向对象的实现和异常的处理 (3)字符串 ...
- 前端开发CSS清除浮动的方法有哪些?
在前端开发过程中,非IE浏览器下,当容器的高度自动,并且容器内容中有浮动元素(float为left或right),此时如果容器的高度不能自适应内容的高度,从而使得内容溢出破坏整体布局,这种现象叫做浮动 ...