
Sqoop 结合多种系统的具体应用
Sqoop与HDFS结合
下面我们结合 HDFS,介绍 Sqoop 从关系型数据库的导入和导出。
Sqoop import
它的功能是将数据从关系型数据库导入 HDFS 中,其流程图如下所示。
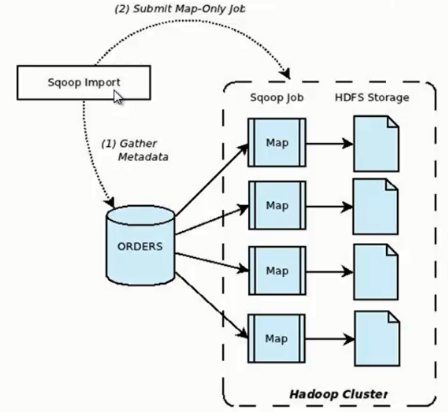
我们来分析一下 Sqoop 数据导入流程,首先用户输入一个 Sqoop import 命令,Sqoop 会从关系型数据库中获取元数据信息,比如要操作数据库表的 schema是什么样子,这个表有哪些字段,这些字段都是什么数据类型等。它获取这些信息之后,会将输入命令转化为基于 Map 的 MapReduce作业。这样 MapReduce作业中有很多 Map 任务,每个 Map 任务从数据库中读取一片数据,这样多个 Map 任务实现并发的拷贝,把整个数据快速的拷贝到 HDFS 上。
下面我们看一下 Sqoop 如何使用命令行来导入数据的,其命令行语法如下所示
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--target-dir /junior/sqoop/ \        //可选,不指定目录,数据默认导入到/user下

--where "sex='female'" \    //可选

--as-sequencefile \        //可选,不指定格式,数据格式默认为 Text 文本格式

--num-mappers 10 \        //可选,这个数值不宜太大

--null-string '\\N' \        //可选

--null-non-string '\\N' \        //可选
--connect:指定 JDBC URL。
--username/password:mysql 数据库的用户名。
--table:要读取的数据库表。
--target-dir:将数据导入到指定的 HDFS 目录下,文件名称如果不指定的话,会默认数据库的表名称。
--where:过滤从数据库中要导入的数据。
--as-sequencefile:指定数据导入数据格式。
--num-mappers:指定 Map 任务的并发度。
--null-string,--null-non-string:同时使用可以将数据库中的空字段转化为'\N',因为数据库中字段为 null,会占用很大的空间。
下面我们介绍几种 Sqoop 数据导入的特殊应用。
1、Sqoop 每次导入数据的时候,不需要把以往的所有数据重新导入 HDFS,只需要把新增的数据导入 HDFS 即可,下面我们来看看如何导入新增数据。
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--incremental append \        //代表只导入增量数据

--check-column id \            //以主键id作为判断条件

--last-value 999        //导入id大于999的新增数据
上述三个组合使用,可以实现数据的增量导入。
2、Sqoop 数据导入过程中,直接输入明码存在安全隐患,我们可以通过下面两种方式规避这种风险。
1)-P:sqoop 命令行最后使用 -P,此时提示用户输入密码,而且用户输入的密码是看不见的,起到安全保护作用。密码输入正确后,才会执行 sqoop 命令。
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--table user \

-P
2)--password-file:指定一个密码保存文件,读取密码。我们可以将这个文件设置为只有自己可读的文件,防止密码泄露。
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--table user \

--password-file my-sqoop-password
Sqoop export
它的功能是将数据从 HDFS 导入关系型数据库表中,其流程图如下所示。
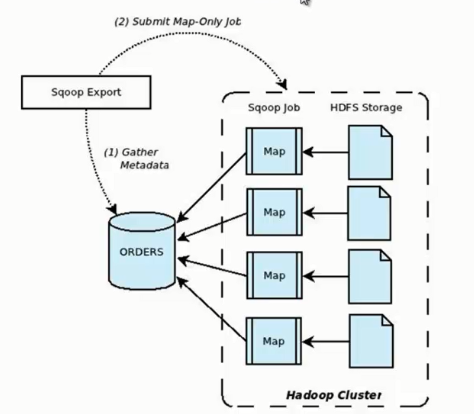
我们来分析一下 Sqoop 数据导出流程,首先用户输入一个 Sqoop export 命令,它会获取关系型数据库的 schema,建立 Hadoop 字段与数据库表字段的映射关系。 然后会将输入命令转化为基于 Map 的 MapReduce作业,这样 MapReduce作业中有很多 Map 任务,它们并行的从 HDFS 读取数据,并将整个数据拷贝到数据库中。
下面我们看一下 Sqoop 如何使用命令行来导出数据的,其命令行语法如下所示。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--export-dir user
--connect:指定 JDBC URL。
--username/password:mysql 数据库的用户名和密码。
--table:要导入的数据库表。
--export-dir:数据在 HDFS 上的存放目录。
下面我们介绍几种 Sqoop 数据导出的特殊应用。
1、Sqoop export 将数据导入数据库,一般情况下是一条一条导入的,这样导入的效率非常低。这时我们可以使用 Sqoop export 的批量导入提高效率,其具体语法如下。
sqoop export \

--Dsqoop.export.records.per.statement=10 \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--export-dir user \

--batch
--Dsqoop.export.records.per.statement:指定每次导入10条数据,--batch:指定是批量导入。
2、在实际应用中还存在这样一个问题,比如导入数据的时候,Map Task 执行失败, 那么该 Map 任务会转移到另外一个节点执行重新运行,这时候之前导入的数据又要重新导入一份,造成数据重复导入。 因为 Map Task 没有回滚策略,一旦运行失败,已经导入数据库中的数据就无法恢复。Sqoop export 提供了一种机制能保证原子性, 使用--staging-table 选项指定临时导入的表。Sqoop export 导出数据的时候会分为两步:第一步,将数据导入数据库中的临时表,如果导入期间 Map Task 失败,会删除临时表数据重新导入;第二步,确认所有 Map Task 任务成功后,会将临时表名称为指定的表名称。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--staging-table staging_user
3、在 Sqoop 导出数据过程中,如果我们想更新已有数据,可以采取以下两种方式。
1)通过 --update-key id 更新已有数据。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--update-key id
2)使用 --update-key id和--update-mode allowinsert 两个选项的情况下,如果数据已经存在,则更新数据,如果数据不存在,则插入新数据记录。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--update-key id \

--update-mode allowinsert
4、如果 HDFS 中的数据量比较大,很多字段并不需要,我们可以使用 --columns 来指定插入某几列数据。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--column username,sex
5、当导入的字段数据不存在或者为null的时候,我们使用--input-null-string和--input-null-non-string 来处理。
sqoop export \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--input-null-string '\\N' \

--input-null-non-string '\\N'
Sqoop与其它系统结合
Sqoop 也可以与Hive、HBase等系统结合,实现数据的导入和导出,用户需要在 sqoop-env.sh 中添加HBASE_HOME、HIVE_HOME等环境变量。
1、Sqoop与Hive结合比较简单,使用 --hive-import 选项就可以实现。
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--hive-import
2、Sqoop与HBase结合稍微麻烦一些,需要使用 --hbase-table 指定表名称,使用 --column-family 指定列名称。
sqoop import \

--connect jdbc:mysql://db.dajiangtai.net:3306/djtdb_hadoop \

--username sqoop \

--password sqoop \

--table user \

--hbase-table user \

--column-family city
Sqoop 结合多种系统的具体应用的更多相关文章
- Hadoop数据收集与入库系统Flume与Sqoop
Hadoop提供了一个中央化的存储系统,其有利于进行集中式的数据分析与数据共享. Hadoop对存储格式没有要求.可以存储用户访问日志.产品信息以及网页数据等数据. 常见的两种数据来源.一种是分散的数 ...
- Sqoop与HDFS、Hive、Hbase等系统的数据同步操作
Sqoop与HDFS结合 下面我们结合 HDFS,介绍 Sqoop 从关系型数据库的导入和导出. Sqoop import 它的功能是将数据从关系型数据库导入 HDFS 中,其流程图如下所示. 我们来 ...
- Sqoop简介
一 Sqoop是什么 Sqoop:SQL-to-Hadoop 连接传统关系型数据库和Hadoop的桥梁 把关系型数据库的数据导入到 Hadoop 系统 ( 如 HDFS.HBase 和 Hive) ...
- 数据迁移之Sqoop
一 简介 Apache Sqoop(TM)是一种用于在Apache Hadoop和结构化数据存储(如关系数据库)之间高效传输批量数据的工具 . 官方下载地址:http://www.apache.org ...
- 为什么我会认为SAP是世界上最好用最牛逼的ERP系统,没有之一?
为什么我认为SAP是世界上最好用最牛逼的ERP系统,没有之一?玩过QAD.Tiptop.用友等产品,深深觉得SAP是贵的有道理! 一套好的ERP系统,不仅能够最大程度承接适配企业的管理和业务流程,在技 ...
- linux系统运维常用基本命令详解
1.ls 文件属性: -:普通文件 d:目录文件 b:块设备 c:字符设备文件 l:符号连接文件 p:命令管道 s:套接字文件 文件权限: 9位数字,每3位一组 文件硬链接次数 ...
- Oracle系统学习摘要
对于企业级大型系统,Oracle数据库的重要性不言而喻,作为长期使用Sql server的developer,花了点时间学习了一个Oracle的系列课程,总结一下. 1.oracle一些基础命令 sq ...
- 转 系统级编程语言性能PK
http://www.solidot.org/story?sid=35754 看了此文,为什么我现在如此看好Rust C/C++已经统治系统编程很久,除了ObjectiveC之外语言都无法获得很高的关 ...
- zz Windows 10安装教程:硬盘安装Win10 系统步骤(适合32位和64位)
Windows 10安装教程:硬盘安装Win10 系统步骤(适合32位和64位) Posted on 2015年01月28日 by 虾虾 22 Comments 最新的Windows 10 MSD ...
随机推荐
- 如何在程序中给word文档加上标和下标
如何在程序中给word文档加上标和下标 上标或下标是一个小于普通行格式的数字,图形,标志或者指示通常它的设置与行相比偏上或偏下.下标通常显示于或者低于基准线,而上标则高于.上标和下标通常被用于表达公式 ...
- 【转】 个人认为,这是最详细的 android------HttpURLConnection 类用法详解。一些教材没讲到的,它讲到了
站在巨人的肩膀上,渐渐进步. 原文链接:http://www.blogjava.net/supercrsky/articles/247449.html 针对JDK中的URLConnection连接Se ...
- C#设置文件权限
在开发中,我们经常会使用IO操作,例如创建,删除文件等操作.在项目中这样的需求也较多,我们也会经常对这些操作进行编码,但是对文件的权限进行设置,这样的操作可能会手动操作,现在介绍一种采用代码动态对文件 ...
- Epplus
简介:Epplus是一个使用Open Office XML(Xlsx)文件格式,能读写Excel 2007/2010文件的开源组件 功效:支持对excel文档的汇入汇出,图表(excel自带的图表基本 ...
- [Asp.net 5] Logging-日志系统的基本架构(上)
本节主要介绍解决方案中的Microsoft.Framework.Logging.Abstractions.Microsoft.Framework.Logging俩个工程. 这俩个工程中所有类的关系如下 ...
- C#开发微信门户及应用(43)--微信各个项目模块的定义和相互关系
我们在开发微信相关的应用的时候,一般需要完善的基础模块支持,包括微信公众号,微信企业号,以及一些业务模块的支持,一般随着功能的增多,我们需要非常清晰的界定他们的关系.模块的分拆以及合并往往需要考虑的代 ...
- 【Win10开发】Toast通知——后台激活
前篇文章我们写了关于Toast的前台激活,那么接下来就讲一讲它的后台激活.当通知出现时并不会出现app的界面,但是app能在后台获取到通知中的信息. 关于xaml和Toast通知架构我们在这里就不再赘 ...
- C#写爬虫,版本V2.0
这个版本主要是以百度图片为对象,对其进行爬虫操作,实现了最基本的下载功能,但是缺陷非常多,日后还会对其进行改进. 打开百度图片,同时打开开发者工具,我们会发现,百度图片是通过如下的一段ajax来加载图 ...
- should be mapped with insert="false" update="false
SSH项目出现了 should be mapped with insert="false" update="false 错误,仔细检查后发现,是两个不同的属性映射了表中的 ...
- Apache Lucene学习笔记
Hadoop概述 Apache lucene: 全球第一个开源的全文检索引擎工具包 完整的查询引擎和搜索引擎 部分文本分析引擎 开发人员在此基础建立完整的全文检索引擎 以下为转载:http://www ...