
[深度应用]·实战掌握PyTorch图片分类简明教程
[深度应用]·实战掌握PyTorch图片分类简明教程
个人网站--> http://www.yansongsong.cn/
项目GitHub地址--> https://github.com/xiaosongshine/image_classifier_PyTorch/
1.引文
深度学习的比赛中,图片分类是很常见的比赛,同时也是很难取得特别高名次的比赛,因为图片分类已经被大家研究的很透彻,一些开源的网络很容易取得高分。如果大家还掌握不了使用开源的网络进行训练,再慢慢去模型调优,很难取得较好的成绩。
我们在[PyTorch小试牛刀]实战六·准备自己的数据集用于训练讲解了如何制作自己的数据集用于训练,这个教程在此基础上,进行训练与应用。
2.数据介绍
数据 下载地址
这次的实战使用的数据是交通标志数据集,共有62类交通标志。其中训练集数据有4572张照片(每个类别大概七十个),测试数据集有2520张照片(每个类别大概40个)。数据包含两个子目录分别train与test:
为什么还需要测试数据集呢?这个测试数据集不会拿来训练,是用来进行模型的评估与调优。
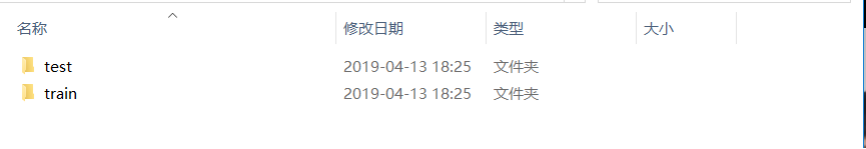

train与test每个文件夹里又有62个子文件夹,每个类别在同一个文件夹内:

我从中打开一个文件间,把里面图片展示出来:
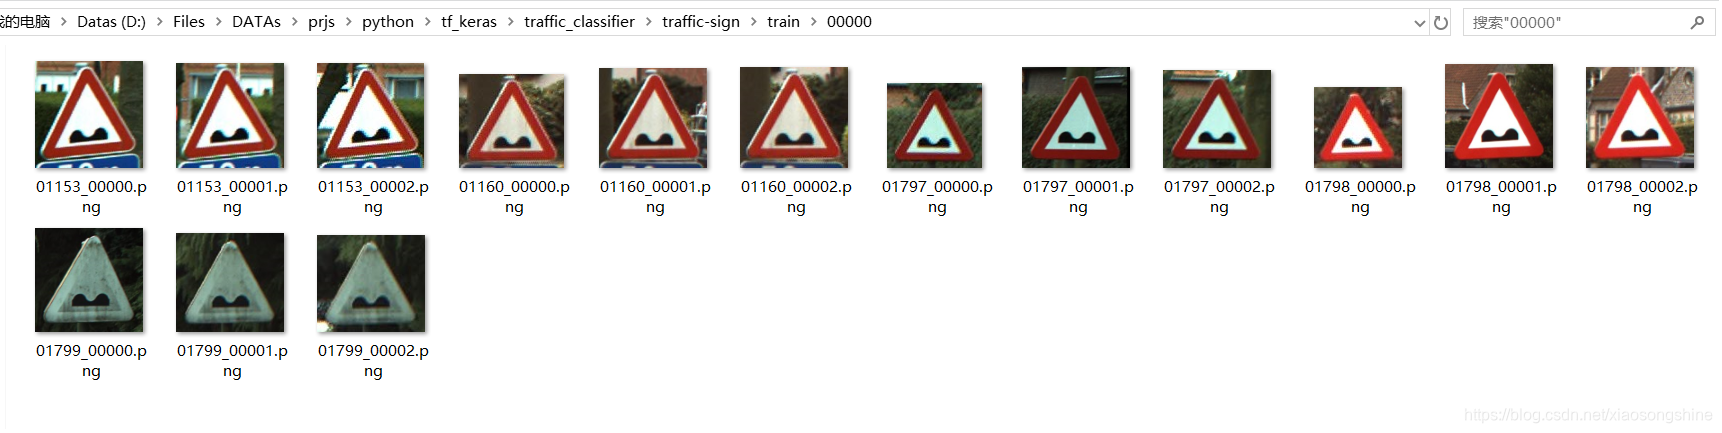
其中每张照片都类似下面的例子,100*100*3的大小。100是照片的照片的长和宽,3是什么呢?这其实是照片的色彩通道数目,RGB。彩色照片存储在计算机里就是以三维数组的形式。我们送入网络的也是这些数组。
3.网络构建
1.导入Python包,定义一些参数
import torch as t

import torchvision as tv

import os

import time

import numpy as np

from tqdm import tqdm

class DefaultConfigs(object):

    data_dir = "./traffic-sign/"

    data_list = ["train","test"]

    lr = 0.001

    epochs = 10

    num_classes = 62

    image_size = 224

    batch_size = 40

    channels = 3

    gpu = "0"

    train_len = 4572

    test_len = 2520

    use_gpu = t.cuda.is_available()

config = DefaultConfigs()
2.数据准备,采用PyTorch提供的读取方式(具体内容参考[PyTorch小试牛刀]实战六·准备自己的数据集用于训练)
注意一点Train数据需要进行随机裁剪,Test数据不要进行裁剪了
normalize = tv.transforms.Normalize(mean = [0.485, 0.456, 0.406],

                                    std = [0.229, 0.224, 0.225]

                                    )

transform = {

    config.data_list[0]:tv.transforms.Compose(

        [tv.transforms.Resize([224,224]),tv.transforms.CenterCrop([224,224]),

        tv.transforms.ToTensor(),normalize]#tv.transforms.Resize 用于重设图片大小

    ) ,

    config.data_list[1]:tv.transforms.Compose(

        [tv.transforms.Resize([224,224]),tv.transforms.ToTensor(),normalize]

    )

}

datasets = {

    x:tv.datasets.ImageFolder(root = os.path.join(config.data_dir,x),transform=transform[x])

    for x in config.data_list

}

dataloader = {

    x:t.utils.data.DataLoader(dataset= datasets[x],

        batch_size=config.batch_size,

        shuffle=True

    )

    for x in config.data_list

}
3.构建网络模型(使用resnet18进行迁移学习,训练参数为最后一个全连接层 t.nn.Linear(512,num_classes))
def get_model(num_classes):

    model = tv.models.resnet18(pretrained=True)

    for parma in model.parameters():

        parma.requires_grad = False

    model.fc = t.nn.Sequential(

        t.nn.Dropout(p=0.3),

        t.nn.Linear(512,num_classes)

    )

    return(model)
如果电脑硬件支持,可以把下述代码屏蔽,则训练整个网络,最终准确率会上升,训练数据会变慢。
for parma in model.parameters():

    parma.requires_grad = False
模型输出
ResNet(

  (conv1): Conv2d(3, 64, kernel_size=(7, 7), stride=(2, 2), padding=(3, 3), bias=False)

  (bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

  (relu): ReLU(inplace)

  (maxpool): MaxPool2d(kernel_size=3, stride=2, padding=1, dilation=1, ceil_mode=False)

  (layer1): Sequential(

    (0): BasicBlock(

      (conv1): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

    )

    (1): BasicBlock(

      (conv1): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

    )

  )

  (layer2): Sequential(

    (0): BasicBlock(

      (conv1): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (downsample): Sequential(

        (0): Conv2d(64, 128, kernel_size=(1, 1), stride=(2, 2), bias=False)

        (1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      )

    )

    (1): BasicBlock(

      (conv1): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

    )

  )

  (layer3): Sequential(

    (0): BasicBlock(

      (conv1): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (downsample): Sequential(

        (0): Conv2d(128, 256, kernel_size=(1, 1), stride=(2, 2), bias=False)

        (1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      )

    )

    (1): BasicBlock(

      (conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

    )

  )

  (layer4): Sequential(

    (0): BasicBlock(

      (conv1): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (downsample): Sequential(

        (0): Conv2d(256, 512, kernel_size=(1, 1), stride=(2, 2), bias=False)

        (1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      )

    )

    (1): BasicBlock(

      (conv1): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

      (relu): ReLU(inplace)

      (conv2): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False)

      (bn2): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)

    )

  )

  (avgpool): AvgPool2d(kernel_size=7, stride=1, padding=0)

  (fc): Sequential(

    (0): Dropout(p=0.3)

    (1): Linear(in_features=512, out_features=62, bias=True)

  )

)
4.训练模型(支持自动GPU加速,GPU使用教程参考:[开发技巧]·PyTorch如何使用GPU加速)
def train(epochs):

    model = get_model(config.num_classes)

    print(model)

    loss_f = t.nn.CrossEntropyLoss()

    if(config.use_gpu):

        model = model.cuda()

        loss_f = loss_f.cuda()

    opt = t.optim.Adam(model.fc.parameters(),lr = config.lr)

    time_start = time.time()

    for epoch in range(epochs):

        train_loss = []

        train_acc = []

        test_loss = []

        test_acc = []

        model.train(True)

        print("Epoch {}/{}".format(epoch+1,epochs))

        for batch, datas in tqdm(enumerate(iter(dataloader["train"]))):

            x,y = datas

            if (config.use_gpu):

                x,y = x.cuda(),y.cuda()

            y_ = model(x)

            #print(x.shape,y.shape,y_.shape)

            _, pre_y_ = t.max(y_,1)

            pre_y = y

            #print(y_.shape)

            loss = loss_f(y_,pre_y)

            #print(y_.shape)

            acc = t.sum(pre_y_ == pre_y)

            loss.backward()

            opt.step()

            opt.zero_grad()

            if(config.use_gpu):

                loss = loss.cpu()

                acc = acc.cpu()

            train_loss.append(loss.data)

            train_acc.append(acc)

            #if((batch+1)%5 ==0):

        time_end = time.time()

        print("Batch {}, Train loss:{:.4f}, Train acc:{:.4f}, Time: {}"\

            .format(batch+1,np.mean(train_loss)/config.batch_size,np.mean(train_acc)/config.batch_size,(time_end-time_start)))

        time_start = time.time()

        model.train(False)

        for batch, datas in tqdm(enumerate(iter(dataloader["test"]))):

            x,y = datas

            if (config.use_gpu):

                x,y = x.cuda(),y.cuda()

            y_ = model(x)

            #print(x.shape,y.shape,y_.shape)

            _, pre_y_ = t.max(y_,1)

            pre_y = y

            #print(y_.shape)

            loss = loss_f(y_,pre_y)

            acc = t.sum(pre_y_ == pre_y)

            if(config.use_gpu):

                loss = loss.cpu()

                acc = acc.cpu()

            test_loss.append(loss.data)

            test_acc.append(acc)

        print("Batch {}, Test loss:{:.4f}, Test acc:{:.4f}".format(batch+1,np.mean(test_loss)/config.batch_size,np.mean(test_acc)/config.batch_size))

        t.save(model,str(epoch+1)+"ttmodel.pkl")

if __name__ == "__main__":

    train(config.epochs)
训练结果如下:
def train(epochs):

    model = get_model(config.num_classes)

    print(model)

    loss_f = t.nn.CrossEntropyLoss()

    if(config.use_gpu):

        model = model.cuda()

        loss_f = loss_f.cuda()

    opt = t.optim.Adam(model.fc.parameters(),lr = config.lr)

    time_start = time.time()

    for epoch in range(epochs):

        train_loss = []

        train_acc = []

        test_loss = []

        test_acc = []

        model.train(True)

        print("Epoch {}/{}".format(epoch+1,epochs))

        for batch, datas in tqdm(enumerate(iter(dataloader["train"]))):

            x,y = datas

            if (config.use_gpu):

                x,y = x.cuda(),y.cuda()

            y_ = model(x)

            #print(x.shape,y.shape,y_.shape)

            _, pre_y_ = t.max(y_,1)

            pre_y = y

            #print(y_.shape)

            loss = loss_f(y_,pre_y)

            #print(y_.shape)

            acc = t.sum(pre_y_ == pre_y)

            loss.backward()

            opt.step()

            opt.zero_grad()

            if(config.use_gpu):

                loss = loss.cpu()

                acc = acc.cpu()

            train_loss.append(loss.data)

            train_acc.append(acc)

            #if((batch+1)%5 ==0):

        time_end = time.time()

        print("Batch {}, Train loss:{:.4f}, Train acc:{:.4f}, Time: {}"\

            .format(batch+1,np.mean(train_loss)/config.batch_size,np.mean(train_acc)/config.batch_size,(time_end-time_start)))

        time_start = time.time()

        model.train(False)

        for batch, datas in tqdm(enumerate(iter(dataloader["test"]))):

            x,y = datas

            if (config.use_gpu):

                x,y = x.cuda(),y.cuda()

            y_ = model(x)

            #print(x.shape,y.shape,y_.shape)

            _, pre_y_ = t.max(y_,1)

            pre_y = y

            #print(y_.shape)

            loss = loss_f(y_,pre_y)

            acc = t.sum(pre_y_ == pre_y)

            if(config.use_gpu):

                loss = loss.cpu()

                acc = acc.cpu()

            test_loss.append(loss.data)

            test_acc.append(acc)

        print("Batch {}, Test loss:{:.4f}, Test acc:{:.4f}".format(batch+1,np.mean(test_loss)/config.batch_size,np.mean(test_acc)/config.batch_size))

        t.save(model,str(epoch+1)+"ttmodel.pkl")

if __name__ == "__main__":

    train(config.epochs)
训练10个Epoch,测试集准确率可以到达0.86,已经达到不错效果。通过修改参数,增加训练,可以达到更高的准确率。
[深度应用]·实战掌握PyTorch图片分类简明教程的更多相关文章
- [深度应用]·实战掌握Dlib人脸识别开发教程
[深度应用]·实战掌握Dlib人脸识别开发教程 个人网站--> http://www.yansongsong.cn/ 项目GitHub地址--> https://github.com/xi ...
- Go 语言图片处理简明教程
虽然 Go 语言主要用于 Web 后端以及各类中间件和基础设施开发,也难免遇到一些图像处理的需求.Go 语言提供的 image 标准库提供了基本的图片加载.裁剪.绘制等能力,可以帮助我们实现一些绘图需 ...
- 对比学习:《深度学习之Pytorch》《PyTorch深度学习实战》+代码
PyTorch是一个基于Python的深度学习平台,该平台简单易用上手快,从计算机视觉.自然语言处理再到强化学习,PyTorch的功能强大,支持PyTorch的工具包有用于自然语言处理的Allen N ...
- 深度学习之神经网络核心原理与算法-caffe&keras框架图片分类
之前我们在使用cnn做图片分类的时候使用了CIFAR-10数据集 其他框架对于CIFAR-10的图片分类是怎么做的 来与TensorFlow做对比. Caffe Keras 安装 官方安装文档: ht ...
- [深度应用]·Keras实现Self-Attention文本分类(机器如何读懂人心)
[深度应用]·Keras实现Self-Attention文本分类(机器如何读懂人心) 配合阅读: [深度概念]·Attention机制概念学习笔记 [TensorFlow深度学习深入]实战三·分别使用 ...
- TensorFlow 2.0 深度学习实战 —— 浅谈卷积神经网络 CNN
前言 上一章为大家介绍过深度学习的基础和多层感知机 MLP 的应用,本章开始将深入讲解卷积神经网络的实用场景.卷积神经网络 CNN(Convolutional Neural Networks,Conv ...
- TensorFlow深度学习实战---图像识别与卷积神经网络
全连接层网络结构:神经网络每两层之间的所有结点都是有边相连的. 卷积神经网络:1.输入层 2.卷积层:将神经网络中的每一个小块进行更加深入地分析从而得到抽象程度更高的特征. 3 池化层:可以认为将一张 ...
- 源码分析——迁移学习Inception V3网络重训练实现图片分类
1. 前言 近些年来,随着以卷积神经网络(CNN)为代表的深度学习在图像识别领域的突破,越来越多的图像识别算法不断涌现.在去年,我们初步成功尝试了图像识别在测试领域的应用:将网站样式错乱问题.无线领域 ...
- 深度学习实战篇-基于RNN的中文分词探索
深度学习实战篇-基于RNN的中文分词探索 近年来,深度学习在人工智能的多个领域取得了显著成绩.微软使用的152层深度神经网络在ImageNet的比赛上斩获多项第一,同时在图像识别中超过了人类的识别水平 ...
随机推荐
- bzoj4044 [Cerc2014] Virus synthesis
回文自动机上dp f[x]表示形成x代表的回文串所需的最小步数, 若len[x]为奇数,f[x]=len[x],因为即使有更优的,也是直接添加,没有复制操作,那样就不用从x转移了. 若len[x]为偶 ...
- [HNOI2015]菜肴制作 拓扑序
逆序最大字典序拓扑序 反向建边,逆序字典序最大.. #include<cstdio> #include<cstring> #include<iostream> #i ...
- centos-7 yum装docker-ce后启动失败
相关版本: centos-7: CentOS Linux release 7.0.1406 (Core) docker-ce: Docker version 18.03.0-ce, build 0 ...
- 利用face_recognition库裁取人脸
from PIL import Image import face_recognition # Load the jpg file into a numpy array image = face_re ...
- 开源)嗨,Java,你可以生成金山词霸的二维码分享海报吗?
As long as you can still grab a breath, you fight.只要一息尚存,就不得不战. 有那么一段时间,我特别迷恋金山词霸的每日一句分享海报.因为不仅海报上的图 ...
- Java后端框架之Spring Boot详解,文末有Java分布式实战项目视频可取
在 Java 后端框架繁荣的今天,Spring 框架无疑是最最火热,也是必不可少的开源框架,更是稳坐 Java 后端框架的龙头老大. 用过 Spring 框架的都知道 Spring 能流行是因为它的两 ...
- 深入学习MySQL事务:ACID特性的实现原理
事务是MySQL等关系型数据库区别于NoSQL的重要方面,是保证数据一致性的重要手段.本文将首先介绍MySQL事务相关的基础概念,然后介绍事务的ACID特性,并分析其实现原理. MySQL博大精深,文 ...
- asp.net core系列 51 Identity 授权(下)
1.6 基于资源的授权 前面二篇中,熟悉了五种授权方式(对于上篇讲的策略授权,还有IAuthorizationPolicyProvider的自定义授权策略提供程序没有讲,后面再补充).本篇讲的授权方式 ...
- Spring Boot 中关于自定义异常处理的套路!
在 Spring Boot 项目中 ,异常统一处理,可以使用 Spring 中 @ControllerAdvice 来统一处理,也可以自己来定义异常处理方案.Spring Boot 中,对异常的处理有 ...
- 优雅地 `async/await`
async/await 虽然取代了回调,使用类似同步的代码组织方式让代码更加简洁美观,但错误处理时需要加 try/catch. 比如下面这样,一个简单的 Node.js 中使用 async/await ...