
爬取5K分辨率超清唯美壁纸
@
爬取5K分辨率超清唯美壁纸
简介
壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空,有的人喜欢美女,有的人喜欢动物。然而,终究有一天你已经产生审美疲劳了,但你下定决定要换壁纸的时候,又发现网上的壁纸要么分辨率低,要么带有水印。
这里有一款Mac下的小清新壁纸神器Pap.er,可能是Mac下最好的壁纸软件,自带5K超清分辨率壁纸,富有多种类型壁纸,当我们想在Windows或者Linux下使用的时候,就可以考虑将5K超清分辨率壁纸爬取下来。
编写思路
首先,打开Charles软件,进行抓包。打开Pap.er,开始抓包。(由于是Mac系统下的APP,所以非Mac系统的朋友可以直接看抓包结果)
抓包分析结果如下:
参数page不用改动,per_page指的是每页提取的数量,也就是我们想要提取的图片数量。
抓完包之后,我们开始编写5K壁纸解析程序
# 爬取不同类型图片

def crawler_photo(type_id, photo_count):

    # 最新 1, 最热 2, 女生 3, 星空 4

    if(type_id == 1):

        url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c68ffb9463b7fbfe72b0db0?page=1&per_page=' + str(photo_count)

    elif(type_id == 2):

        url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c69251c9b1c011c41bb97be?page=1&per_page=' + str(photo_count)

    elif(type_id == 3):

        url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c81087e6aee28c541eefc26?page=1&per_page=' + str(photo_count)

    elif(type_id == 4):

        url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c81f64c96fad8fe211f5367?page=1&per_page=' + str(photo_count)

    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"}

    # 获取图片链接列表数据,json格式

    respond = requests.get(url, headers=headers)

    # 对json格式转化为python对象

    photo_data = json.loads(respond.content)

    # 已经下载的图片张数

    now_photo_count = 1

    # 所有图片张数

    all_photo_count = len(photo_data)

    # 开始下载并保存5K分辨率壁纸

    for photo in photo_data:

        # 创建一个文件夹存放我们下载的图片(若存在则不用重新创建)

        if not os.path.exists('./' + str(type_id)):

            os.makedirs('./' + str(type_id))

        # 准备下载的图片链接,5K超清壁纸链接

        file_url = photo['urls']['raw']

        # 准备下载的图片名称,不包含扩展名

        file_name_only = file_url.split('/')

        file_name_only = file_name_only[len(file_name_only) -1]

        # 准备保存到本地的完整路径

        file_full_name = './' + str(type_id) + '/' + file_name_only

        # 开始下载图片

        Down_load(file_url, file_full_name, now_photo_count, all_photo_count)

        # 已经下载的图片数量加1

        now_photo_count = now_photo_count + 1
根据不同类型的壁纸,创建不同的文件夹编号进行分类。
上面的Down_load()函数是下载文件的意思,调用requests库,具体代码如下:
# 文件下载器

def Down_load(file_url, file_full_name, now_photo_count, all_photo_count):

    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"}

    # 开始下载图片

    with closing(requests.get(file_url, headers=headers, stream=True)) as response:

        chunk_size = 1024  # 单次请求最大值

        content_size = int(response.headers['content-length'])  # 文件总大小

        data_count = 0 # 当前已传输的大小

        with open(file_full_name, "wb") as file:

            for data in response.iter_content(chunk_size=chunk_size):

                file.write(data)

                done_block = int((data_count / content_size) * 50)

                data_count = data_count + len(data)

                now_jd = (data_count / content_size) * 100

                print("\r %s:[%s%s] %d%% %d/%d" % (file_full_name, done_block * '█', ' ' * (50 - 1 - done_block), now_jd, now_photo_count, all_photo_count), end=" ")

    # 下载完图片后获取图片扩展名,并为其增加扩展名

    file_type = filetype.guess(file_full_name)

    os.rename(file_full_name, file_full_name + '.' + file_type.extension)
chunk_size指的是单次请求的最大值,content_size指的就是我们下载5K超清壁纸的大小,为了能够直观显示下载情况,所以添加了下载进度条的显示效果。核心代码为file.write(data)。
下载完毕后,为了方便我们查看文件,所以需要给图片添加对应的扩展名,比如jpg,png,gif,这里使用到filetype库对文件进行解析,判断其类型。
最后,开始在main中爬取5K高清壁纸:
if __name__ == '__main__':

    # 最新 1, 最热 2, 女生 3, 星空 4

    # 爬取类型为3的图片(女生),一共准备爬取100张

    print("程序已经开始运行,请稍等……")

    crawler_photo(1, 100)

    crawler_photo(2, 100)

    crawler_photo(3, 100)

    crawler_photo(4, 100)
使用教程
- 确保以下库均已安装:
# 如果没有安装,请使用pip install module安装

import requests

import filetype

import os

import json

from contextlib import closing
演示图片
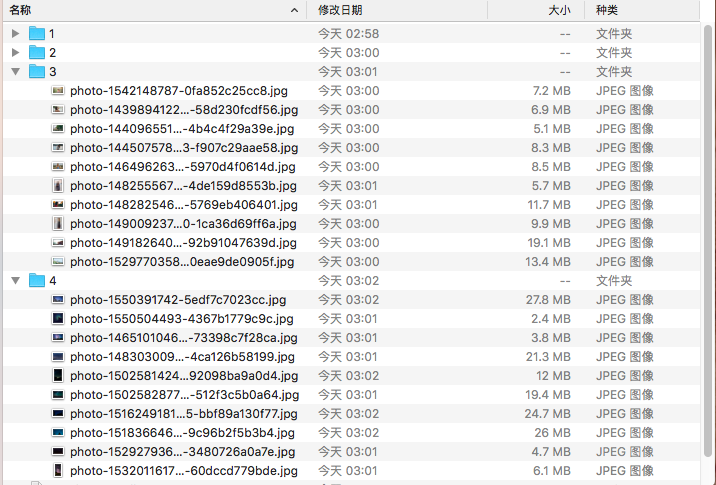
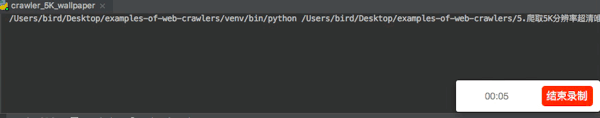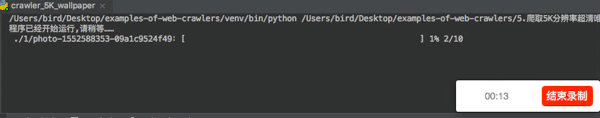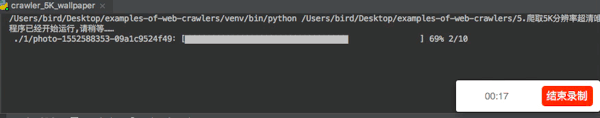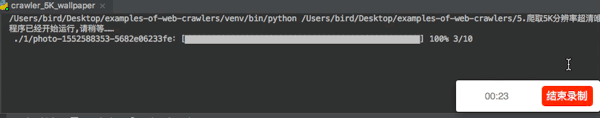
完整源代码
项目源代码在GitHub仓库
项目持续更新,欢迎您star本项目
爬取5K分辨率超清唯美壁纸的更多相关文章
- Python爬虫教程-爬取5K分辨率超清唯美壁纸源码
简介 壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空,有的人喜欢美女,有的人喜欢动物.然而,终究有一天你已经产生审美疲劳了,但你下定决定要换壁纸的时候,又发现网上的壁 ...
- python 爬取王者荣耀高清壁纸
代码地址如下:http://www.demodashi.com/demo/13104.html 一.前言 打过王者的童鞋一般都会喜欢里边设计出来的英雄吧,特别想把王者荣耀的英雄的高清图片当成电脑桌面 ...
- Python爬虫-爬取科比职业生涯高清图集
前面学习了Python爬取豆瓣电影Top250的数据,爬取的信息是电影信息的文本信息,但是在互联网上流行的图片才有更大的吸引力,本篇我们来使用python爬取网页上的图片并保存在本地硬盘上,很兴奋吧, ...
- xpath+多进程爬取全书网纯爱耽美类别的所有小说。
# 需要的库 import requests from lxml import etree from multiprocessing import Pool import os # 请求头 heade ...
- Requests库入门——应用实例-网络图片的爬取与保存(好看的小姐姐≧▽≦)
在B站学习这一节的时候,弹幕最为激烈,不管大家是出于什么目的都想体验一下网络爬虫爬取图片的魅力,毕竟之前的实例实话说都是一些没有太大作用的信息. 好了,直接上代码: import requests i ...
- Python爬取 | 唯美女生图片
这里只是代码展示,且复制后不能直接运行,需要配置一些设置才行,具体请查看下方链接介绍: Python爬取 | 唯美女生图片 from selenium import webdriver from fa ...
- Python抓取花瓣网高清美图
一:前言 嘀嘀嘀,上车请刷卡.昨天看到了不错的图片分享网——花瓣,里面的图片质量还不错,所以利用selenium+xpath我把它的妹子的栏目下爬取了下来,以图片栏目名称给文件夹命名分类保存到电脑中. ...
- Node JS爬虫:爬取瀑布流网页高清图
原文链接:Node JS爬虫:爬取瀑布流网页高清图 静态为主的网页往往用get方法就能获取页面所有内容.动态网页即异步请求数据的网页则需要用浏览器加载完成后再进行抓取.本文介绍了如何连续爬取瀑布流网页 ...
- Python爬虫爬取美剧网站
一直有爱看美剧的习惯,一方面锻炼一下英语听力,一方面打发一下时间.之前是能在视频网站上面在线看的,可是自从广电总局的限制令之后,进口的美剧英剧等貌似就不在像以前一样同步更新了.但是,作为一个宅diao ...
随机推荐
- #Java学习之路——基础阶段(第十一篇)
我的学习阶段是跟着CZBK黑马的双源课程,学习目标以及博客是为了审查自己的学习情况,毕竟看一遍,敲一遍,和自己归纳总结一遍有着很大的区别,在此期间我会参杂Java疯狂讲义(第四版)里面的内容. 前言: ...
- 手把手安装Laravel框架(permissions扩展包)实现RBAC权限---以及一些安装时的ERROR
a.依赖管理工具,框架,环境 1.composer 2.laravel(我的是5.5) 3.PHP(我的7.2),MySql(我的5.7) b,安装 1.首先需要安装一个干净的 Laravel 项目, ...
- JavaScript第一回-来龙去脉
简写:JavaScript-JS ECMAScript-ES 写在前面的话:啃文字大多时间不是件愉快的事情,但是我们必须过这个坎,让自己习惯,让自己不讨厌,至于喜欢不喜欢,我们等时间给出答案. J ...
- React的入门知识与概念【1】
回顾在以往的项目开发中,从最初的使用的原生html+js+css+jquery开发,到后来随着项目功能的增加,也渐渐学习了Vue.js框架的开发,以及Vue.js的全家桶Axios,Vue-route ...
- Redis学习笔记~Twenproxy所起到的作用
回到目录 Twenproxy除了可以作为redis的代理,它同样支持memerycached.我这里主要了解Twemproxy在redis集群上的解决方案.Twemproxy除了完美的解决了分片,路由 ...
- Matlab图像处理常用基本函数
之前用Matlab做图像处理工作时,用到什么函数就查什么函数,从没做过系统的总结,再做的时候又要去查,所以总结还是有必要的~ 为了方便,在此只列出函数名和基本用法,如不特别指出,不详细说明参数,辅助h ...
- Java基础系列-Enum深入解析
原创文章,转载请标注出处:https://www.cnblogs.com/V1haoge/p/10755129.html 一.概述 枚举就是一个语法糖效果. 定义一个枚举,其实就是定义一个继承抽象类E ...
- wkhtmltox实现网页转换成图片或pdf
1.先下载http://download.gna.org/wkhtmltopdf/obsolete/windows/wkhtmltox-0.11.0_rc1-installer.exe,安装 2.在命 ...
- Java开发相关的linux一些基础命令,必须要掌握的
1.查找文件 find / -name filename.txt 根据名称查找/目录下的filename.txt文件. find . -name "*.xml" 递归查找所有的 ...
- JVM虚拟机基本概念
一.JVM运行时数据区域1.1.程序计数器 一块较小的内存空间,当前线程所执行的字节码指示器.每个线程有一个独立的程序计数器1.2.Java虚拟机栈 线程私有,生命周期与线程相同 每个方法在执行时会创 ...