前提是大家至少了解HBase的基本需求和组件。
从大家最熟悉的客户端发起请求开始讲起吧,这样大家能够深有体会的逐步了解原理。比如我们发起了一条PUT请求,客户端首先需要查找到需要响应请求的REGIONSERVER。 记录region->regionserver映射是由HBASE系统表.META.记录的。所以我们只要知道. META.表的位置就能知道每个region响应的key的范围 和region所在机器。但是.META.表又保存在哪些机器上呢?这又是由-ROOT-表记录的 master在分配完-ROOT-表后 会将-ROOT-表的位置放到ZOOKEEPER中。所以我们在配置客户端的时候配置的是ZOOKEEPER的位置,而不是MASTER位置。
为什么要分为-ROOT-和.META.呢?这是因为region信息本身很多 一个集群中可能会出现成千上万的region 因此.META.表本身也无法在一个region中保存所有用户region的信息,所以本身也会分裂。而.META.表的region数就比较有限了所以-ROOT-是不会分裂的.
综上,客户端首次请求时,先拿-ROOT-然后通过请求范围找对应的.META.,在.META.中找打具体的region server 然后发送请求。-ROOT-和.META.是可以缓存的。
现在,我们解决了 客户端应当把PUT发送到哪个rs的问题,接下来就要发送请求了。region server收到请求后会保存PUT数据。这就不得不说HBASE的数据模型了,HBASE使用的列式存储,基本数据结构为LSMT log structure merge tree。简略的思路描述是,将操作记录在树中的节点上然后适时的将节点合并从而使key的删除修改能够最终体现在一个节点上,读取的时候会读取带有key相应操作的节点,返回最终key的值。可以看到lsmt是将随机读写转化为顺序读写的数据结构,读方面更适合扫库那样的顺序读取,不太适合随机读取。
那么一个PUT请求时怎么和LSMT搭上关系的呢?首先region server接到请求时,先将操作(keyvalue 时间戳 操作类型)保存为HLog,然后在保存到memstore中,然后即可返回写入成功的请求。其中memstore保存在内存中,写满后flush为hdfs文件。hlog是为了防止rs故障时,memstore数据必然丢失导致的数据丢失,在客户端可以禁用hblog来加快写入速度,但这是用数据不安全换来的。只要每次memstore刷入hdfs后,会判断hdfs刷入的中最早的操作 然后由另外的线程根据此记录删除旧的HLog文件。
接下来说说memstore写满时的处理。memstore写满(每个region的列族都有单独的memstore对象但实际上共用一块内存池)时,会将其中的操作分发到对应region的每个列族(store)做处理。然后store将这些操作序列保存为存储文件(storefile)。
从大体上粗略的看 region server这边重要的实体结构是这样:regionserver : region = 1 : n;region : store= 1 : n;store : storefile = 1 : n。对于每个列族的数据文件,实机上是一个LSMT的叶子节点,每个文件中保存的是最近的对于列族中key的操作。
当一个列族中文件过多的时候,会触发compact,也就是说的文件合并。HBase的compact分为两种 minor和major:minor是小范围内的合并文件,只合并部分。目的在于把小文件积累成大文件。因为没有全量数据,所以对于一个key的删除操作还是需要保留标记,无法物理删除。majorcompact把列族中的所有文件合并为一个,目的在于使key的修改和删除,最终在物理上生效。因为major compact操作的是此列族的全量数据,所以可以做物理删除。但是也由于是全量数据,执行起来耗费时间也会比价长,所以hbase对major compact做了时间间隔限制。
当store的store file集合中总文件长度太大时(超过配置的阈值),这个region会一分为二,也就是split。由于split是以region为单位的,所以有些列族因为其他列族过大也被连坐般的split。所以从这个流程粗略的看来 put会触发flush,flush会触发compact,compact会触发split。当然这都是在多个线程中执行的,不会明显的阻塞住客户端请求。
store file的大小和memstore大小有关系,一次flush会在一个列族里生成一个store file。所以memstore越大,产生大store file的机会也就越多。put不均匀时,有的列族里会有比较多的长度较小的store file,但是文件多了会触发compact。小文件compact很快,所以不用担心。
store file
------------------------------------------------
|block |
|----------------------------------------------|
|block |
...
| meta |
|---------------------------------------------|
|block索引,以及一些key范围信息|
|---------------------------------------------|
|布隆过滤 |
-----------------------------------------------
可以粗略的认为 一个storefile的结构是这样的,尾部的顺序和细节记不太清楚了。一个block包括多个key value,key在文件内是有序的。一条key value记录如下图:
<ignore_js_op>
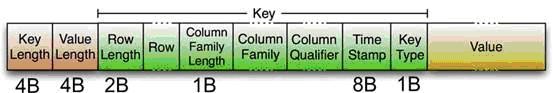
读数据的时候我会发送一个get请求,在region server内部会转为一个scan。他会到相关列族中去scan storefile。storefile的尾部包含block索引、布隆过滤器、更新时间等所以这可以加快需要scan的文件过滤。所以针对一个store file读是这样的:判断get请求中的row key是否在文件保存的数据范围内;判断get请求中的row key是否能从布龙过滤器中找到(如果过滤器为row-col过滤器还可以判断是否包括需要get的col);判断get请求中的时间范围 是否在文件保存的数据的时间范围中;获取对应的block index;把block加载到block cache中;然后scan block;从多个store file的结果中 get请求中需要包含的version个数,取前几个从而满足get请求中需要包含的version个数。get可以看做特殊的scan操作。
总得blockcache大小是有限的,会有淘汰的.实际上blockcache对于scan来说更合适,因为scan一般是一个范围的扫,block中的row key又是有序的,所以说顺序读会比随机读快。一般hbase比较难适应高并发的随机读,因为blockcache这个设计的本身,就不适合缓存随机的row key:随机读的特点就是读的key均匀散列,这样会使读操作,落在每个block上,导致读的时候每个block先被加载到内存,然后很快因为其他的block持续加载进来而被淘汰出去,然后就这样换来换去,反而更浪费时间。
最后两个比较重要的操作是open和close region。这两个在容灾和均衡中常用。
先说close吧 正常close时会先flush memstore 然后通知master close结束。非正常关闭时,就来不及flush了。master会通过zk和region server之间的心跳这两种途径得知regionsever挂掉的情况。
open 一般由master发起。master先找到包含region操作对应的HLog文件,然后挑选出region对应的操作放到region目录中,然后命令某个region server open之。open时先重演HLog中记录的操作,然后再加载region对应的store和store file。
比较重要的原理就是这样的了。原理清楚了的话,再分析起来代码,就能有一个宏观的了解了。
- HBase笔记:对HBase原理的简单理解
早些时候学习hadoop的技术,我一直对里面两项技术倍感困惑,一个是zookeeper,一个就是Hbase了.现在有机会专职做大数据相关的项目,终于看到了HBase实战的项目,也因此有机会搞懂Hbas ...
- [转]毕设- 深入HBase架构解析(一)
深入HBase架构解析(一) 前记 公司内部使用的是MapR版本的Hadoop生态系统,因而从MapR的官网看到了这篇文文章:An In-Depth Look at the HBase Archi ...
- [原][Docker]特性与原理解析
Docker特性与原理解析 文章假设你已经熟悉了Docker的基本命令和基本知识 首先看看Docker提供了哪些特性: 交互式Shell:Docker可以分配一个虚拟终端并关联到任何容器的标准输入上, ...
- 【算法】(查找你附近的人) GeoHash核心原理解析及代码实现
本文地址 原文地址 分享提纲: 0. 引子 1. 感性认识GeoHash 2. GeoHash算法的步骤 3. GeoHash Base32编码长度与精度 4. GeoHash算法 5. 使用注意点( ...
- Web APi之过滤器执行过程原理解析【二】(十一)
前言 上一节我们详细讲解了过滤器的创建过程以及粗略的介绍了五种过滤器,用此五种过滤器对实现对执行Action方法各个时期的拦截非常重要.这一节我们简单将讲述在Action方法上.控制器上.全局上以及授 ...
- Web APi之过滤器创建过程原理解析【一】(十)
前言 Web API的简单流程就是从请求到执行到Action并最终作出响应,但是在这个过程有一把[筛子],那就是过滤器Filter,在从请求到Action这整个流程中使用Filter来进行相应的处理从 ...
- GeoHash原理解析
GeoHash 核心原理解析 引子 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL.oracle.PostgreSQL等)都在使用B树.B树索引本质上是对索引字段 ...
- alibaba-dexposed 原理解析
alibaba-dexposed 原理解析 使用参考地址: http://blog.csdn.net/qxs965266509/article/details/49821413 原理参考地址: htt ...
- 支付宝Andfix 原理解析
支付宝Andfix 原理解析 使用参考地址: http://blog.csdn.net/qxs965266509/article/details/49802429 原理参考地址: http://blo ...
随机推荐
- ubuntu成功安装搜狗输入法
在安装之前,我们要先了解一个事实,那就是linux下安装软件和Windows是非常不同的,并不是简单地双击安装包就可以安装了.linux很多软件都有自己的一个依赖源,如果不先安装好这些依赖源,你是无法 ...
- MD5加密概述
一.Note: 写到这篇文章是工作中实际遇到了,以前都听过不过没有细看.这里简单概述下,原理的话需要看看更专业的介绍了. 二.MD5简介 Message Digest Algorithm MD5(中文 ...
- lb route 相关的一些问题
lb route 相关的一些问题 ========================== 查看系统平台和版本 > show hardware Platform: NetScaler Virtual ...
- 2017 Multi-University Training Contest - 1
hdu 6033 pragma comment(linker, "/STACK:102400000,102400000") #include <cstdio> #inc ...
- navicat for mysql 导出数据的坑
navicat 选择转储结构和数据的时候,生成的 sql 文件会比较大,因为每一条数据都会生成一条 sql 语句,所以会导致 使用 source 还原的时候会很慢很慢很慢, 而使用 mysqldump ...
- 【题解】【LibreOJ Beta Round #5】游戏 LOJ 531 基环树 博弈论
Prelude 题目链接:萌萌哒传送门♪(^∇^*) Subtask 1 & 2 这是什么鬼题面... 首先要看出,这就是一个基环树博弈. 具体题意:给出一个基环内向树,一个棋子初始在\(1\ ...
- 在xadmin中自定义内容的变量及优化汇总
在网上找了很多有关xadmin的内容,发现都不太全 ,找到一篇总结不错的 http://www.lybbn.cn/data/bbsdatas.php?lybbs=62 1.list_display 指 ...
- [Java多线程]-学习多线程需要来了解哪些东西?(concurrent并发包的数据结构和线程池,Locks锁,Atomic原子类)
前言:刚学习了一段机器学习,最近需要重构一个java项目,又赶过来看java.大多是线程代码,没办法,那时候总觉得多线程是个很难的部分很少用到,所以一直没下决定去啃,那些年留下的坑,总是得自己跳进去填 ...
- Bootstrap3和Bootsrap4的区别
Bootstrap3和Bootstap4的区别 1.Bootsrap4 css文件减少了40%以上 2.Bootsrap4已经不支持IE8以及IOS 6的支持 3.多了些类好组件
- springboot+spring session+redis+nginx实现session共享和负载均衡
环境 centos7. jdk1.8.nginx.redis.springboot 1.5.8.RELEASE session共享 添加spring session和redis依赖 <depen ...
