
大数据-hive安装
1、下载Hive需要的版本
我们选用的是hive-3.1.0
将下载下来的hive压缩文件放到/opt/workspace/下
2、解压hive-3.1.0.tar.gz文件
[root@master1 workspace]# tar -zxvf apache-hive-3.1.-bin.tar.gz
3、重命名
[root@master1 workspace]# mv apache-hive-3.1.-bin hive-3.1.
4、因为我们的hive运行在hive on spark 所以需要在lib文件下加入jar包
Since Hive 2.2., Hive on Spark runs with Spark 2.0. and above, which doesn’t have an assembly jar.
To run with YARN mode (either yarn-client or yarn-cluster), link the following jars to HIVE_HOME/lib.

scala-library

spark-core

spark-network-common
mysql-connector-java-8.0.12.jar
5、修改配置文件 hive-site.xml hive-env.sh /etc/profile
hive-env.sh配置文件
# Hive Client memory usage can be an issue if a large number of clients

# are running at the same time. The flags below have been useful in

# reducing memory usage:

#

# if [ "$SERVICE" = "cli" ]; then

#   if [ -z "$DEBUG" ]; then

#     export HADOOP_OPTS="$HADOOP_OPTS -XX:NewRatio=12 -Xms10m -XX:MaxHeapFreeRatio=40 -XX:MinHeapFreeRatio=15 -XX:+UseParNewGC -XX:-UseGCOverheadLimit"

#   else

#     export HADOOP_OPTS="$HADOOP_OPTS -XX:NewRatio=12 -Xms10m -XX:MaxHeapFreeRatio=40 -XX:MinHeapFreeRatio=15 -XX:-UseGCOverheadLimit"

#   fi

# fi

# The heap size of the jvm stared by hive shell script can be controlled via:

#

# export HADOOP_HEAPSIZE=

export HADOOP_HEAPSIZE=

#

# Larger heap size may be required when running queries over large number of files or partitions.

# By default hive shell scripts use a heap size of  (MB).  Larger heap size would also be

# appropriate for hive server.

# Set HADOOP_HOME to point to a specific hadoop install directory

# HADOOP_HOME=${bin}/../../hadoop

export HADOOP_HOME=/opt/workspace/hadoop-2.9.

# Hive Configuration Directory can be controlled by:

# export HIVE_CONF_DIR=

export HIVE_CONF_DIR=/opt/workspace/hive-3.1./conf

# Folder containing extra libraries required for hive compilation/execution can be controlled by:

# export HIVE_AUX_JARS_PATH=

export HIVE_AUX_JARS_PATH=/opt/workspace/hive-3.1./lib
hive-site.xml配置文件如下
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?><!--
Licensed to the Apache Software Foundation (ASF) under one or more
contributor license agreements. See the NOTICE file distributed with
this work for additional information regarding copyright ownership.
The ASF licenses this file to You under the Apache License, Version 2.0
(the "License"); you may not use this file except in compliance with
the License. You may obtain a copy of the License at
http://www.apache.org/licenses/LICENSE-2.0
Unless required by applicable law or agreed to in writing, software
distributed under the License is distributed on an "AS IS" BASIS,
WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
See the License for the specific language governing permissions and
limitations under the License.
--><configuration>
<!-- WARNING!!! This file is auto generated for documentation purposes ONLY! -->
<!-- WARNING!!! Any changes you make to this file will be ignored by Hive. -->
<!-- WARNING!!! You must make your changes in hive-site.xml instead. -->
<!-- Hive Execution Parameters -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://159.226.48.202:3306/hivedata?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&u seSSL=false</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>(用户名)
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>(密码)
<value>MyPass@123</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<property>
<name>hive.metastore.local</name>
<value>true</value>
</property>
<property>
<name>hive.metastore.local</name>
<value>true</value>
</property>
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/hive/warehouse</value>
</property>
<!--
<property>
<name>hive.execution.engine</name>
<value>spark</value>
</property>
<property>
<name>spark.home</name>
<value>/opt/workspace/spark-2.3.0-bin-hadoop2-without-hive</value>
</property>
<property>
<name>spark.master</name>
<value>spark://master1:7077,spark://master2:7077</value> // 或者yarn-cluster/yarn-client
</property>
<property>
<name>spark.submit.deployMode</name>
<value>client</value>
</property>
<property>
<name>spark.eventLog.enabled</name>
<value>true</value>
</property>
<property>
<name>spark.eventLog.dir</name>
<value>hdfs://user/spark/spark-log</value>
</property>
<property>
<name>spark.serializer</name>
<value>org.apache.spark.serializer.KryoSerializer</value>
</property>
<property>
<name>spark.executor.memeory</name>
<value>512m</value>
</property>
<property>
<name>spark.driver.memeory</name>
<value>512m</value>
</property>
<property>
<name>spark.executor.extraJavaOptions</name>
<value>-XX:+PrintGCDetails -Dkey=value -Dnumbers="one two three"</value>
</property>-->
<!--spark engine -->
<property>
<name>hive.execution.engine</name>
<value>spark</value>
</property>
<property>
<name>hive.enable.spark.execution.engine</name>
<value>true</value>
</property>
<!--sparkcontext -->
<property>
<name>spark.master</name>
<value>yarn-cluster</value>
</property>
<property>
<name>spark.serializer</name>
<value>org.apache.spark.serializer.KryoSerializer</value>
</property>
<!--下面的根据实际情况配置 -->
<property>
<name>spark.executor.instances</name>
<value>3</value>
</property>
<property>
<name>spark.executor.cores</name>
<value>4</value>
</property>
<property>
<name>spark.executor.memeory</name>
<value>1024m</value>
</property>
<property>
<name>spark.driver.cores</name>
<value>2</value>
</property>
<property>
<name>spark.driver.memory</name>
<value>1024m</value>
</property>
<property>
<name>spark.yarn.queue</name>
<value>default</value>
</property>
<property>
<name>spark.app.name</name>
<value>myInceptor</value>
</property>
<!--事务相关 -->
<property>
<name>hive.support.concurrency</name>
<value>true</value>
</property>
<property>
<name>hive.enforce.bucketing</name>
<value>true</value>
</property>
<property>
<name>hive.exec.dynamic.partition.mode</name>
<value>nonstrict</value>
</property>
<property>
<name>hive.txn.manager</name>
<value>org.apache.hadoop.hive.ql.lockmgr.DbTxnManager</value>
</property>
<property>
<name>hive.compactor.initiator.on</name>
<value>true</value>
</property>
<property>
<name>hive.compactor.worker.threads</name>
<value>1</value>
</property>
<property>
<name>spark.executor.extraJavaOptions</name>
<value>-XX:+PrintGCDetails -Dkey=value -Dnumbers="one two three"
</value>
</property>
<!--其它 -->
<property>
<name>hive.server2.enable.doAs</name>
<value>false</value>
</property>
<property>
<name>hive.server2.thrift.max.worker.threads</name>
<value>1000</value>
</property>
<property>
<name>hive.spark.job.monitor.timeout</name>
<value>3m</value>
<description>
Expects a time value with unit (d/day, h/hour, m/min, s/sec, ms/msec, us/usec, ns/nsec), which is sec if not specified.
Timeout for job monitor to get Spark job state.
</description>
</property>
</configuration>
注意事项:在不同的服务器上进行配置时,注意标红部分,需要按照不同的服务器进行更改,改为对应的ip及元数据库。
/etc/profile
# Hive Config

export HIVE_HOME=/opt/workspace/hive-3.1.

export HIVE_CONF_DIR=${HIVE_HOME}/conf

export HADOOP_CLASSPATH=$HADOOP_CLASSPATH:$HIVE_HOME/lib/*
export PATH=.:${JAVA_HOME}/bin:${SCALA_HOME}/bin:${MAVEN_HOME}/bin:$HADOOP_HOME/sbin:$HADOOP_HOME/bin:${HIVE_HOME}/bin:${SPARK_HOME}/bin:${HBASE_HOME}/bin:$SQOOP_HOME/bin:${ZK_HOME}/bin:$PATH
source /etc/profile
6、hive初始化
[root@master1 hive-3.1.0]# cd bin
[root@master1 bin]# schematool -initSchema -dbType mysql
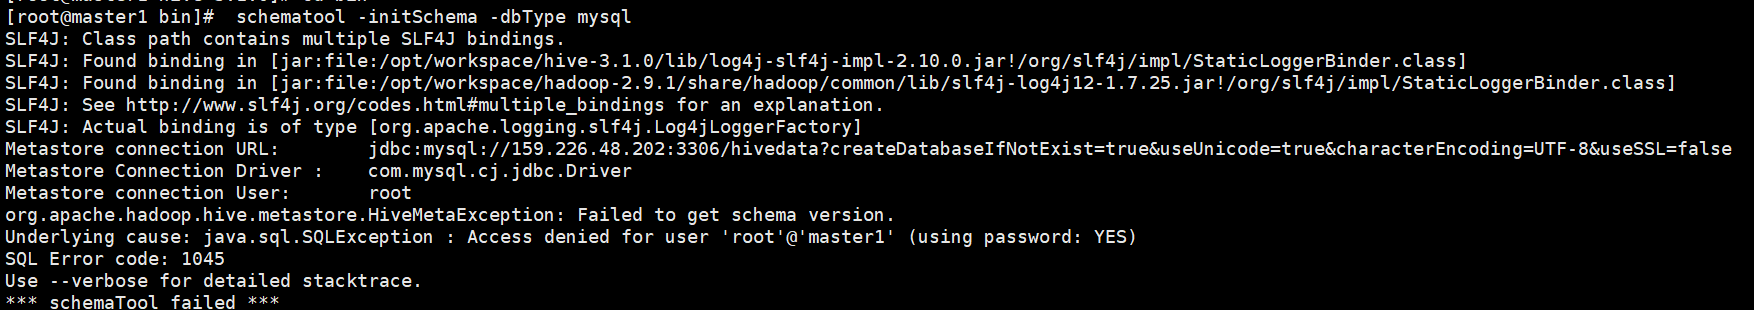
问题:mysql需要授权
说明:在进行grant mysql添加时候,注意:之前设置的是本地登录mysql 密码是123456
而在hive-site.xml中配置的远程访问元数据库hivedata是使用密码MyPass@123,所以设置密码时需要注意,之后进行刷新操作。
登录数据库密码变为MyPass@123
[root@slave1 bin]# mysql -u root -p

Enter password:

Welcome to the MySQL monitor.  Commands end with ; or \g.

Your MySQL connection id is

Server version: 5.6. MySQL Community Server (GPL)

Copyright (c) , , Oracle and/or its affiliates. All rights reserved.

Oracle is a registered trademark of Oracle Corporation and/or its

affiliates. Other names may be trademarks of their respective

owners.

Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.

mysql> grant all privileges on *.* to root@"%" identified by 'MyPass@123';

Query OK,  rows affected (0.00 sec)

mysql> grant all privileges on *.* to root@"localhost" identified by 'MyPass@123';

Query OK,  rows affected (0.01 sec)
mysql> grant all privileges on *.* to root@"slave1" identified by 'MyPass@123';
Query OK, 0 rows affected (0.00 sec)
mysql> flush privileges;

Query OK,  rows affected (0.00 sec)
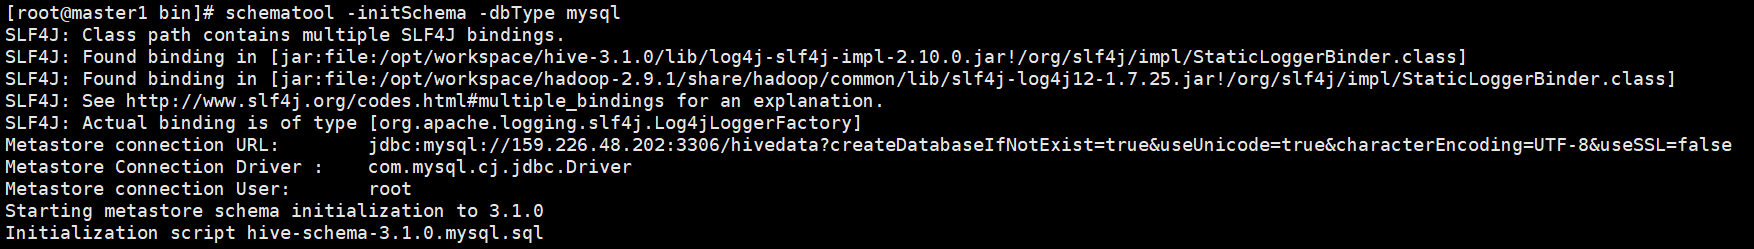
重新初始化成功。状态如下:
[root@master1 hive-3.1.]# cd bin

[root@master1 bin]# schematool -initSchema -dbType mysql

参考:https://blog.csdn.net/sinat_25943197/article/details/81906060
大数据-hive安装的更多相关文章
- 大数据软件安装之Hadoop(Apache)(数据存储及计算)
大数据软件安装之Hadoop(Apache)(数据存储及计算) 一.生产环境准备 1.修改主机名 vim /etc/sysconfig/network 2.修改静态ip vim /etc/udev/r ...
- 大数据软件安装之HBase(NoSQL数据库)
一.安装部署 1.Zookeeper正常部署 (见前篇博文大数据软件安装之ZooKeeper监控 ) [test@hadoop102 zookeeper-3.4.10]$ bin/zkServer.s ...
- 大数据软件安装之Hive(查询)
一.安装及配置 官方文档: https://cwiki.apache.org/confluence/display/Hive/GettingStarted 安装Hive2.3 1)上传apache-h ...
- 大数据--Hive的安装以及三种交互方式
1.3 Hive的安装(前提是:mysql和hadoop必须已经成功启动了) 在之前博客中我有记录安装JDK和Hadoop和Mysql的过程,如果还没有安装,请先进行安装配置好,对应的随笔我也提供了百 ...
- 【大数据】安装关系型数据库MySQL安装大数据处理框架Hadoop
作业来源于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1. 简述Hadoop平台的起源.发展历史与应用现状. 列举发展过 ...
- 【大数据】安装关系型数据库MySQL 安装大数据处理框架Hadoop
作业要求来自:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3161 1.安装Mysql 使用命令 sudo apt-get ins ...
- [Hadoop大数据]——Hive初识
Hive出现的背景 Hadoop提供了大数据的通用解决方案,比如存储提供了Hdfs,计算提供了MapReduce思想.但是想要写出MapReduce算法还是比较繁琐的,对于开发者来说,需要了解底层的h ...
- [Hadoop大数据]——Hive连接JOIN用例详解
SQL里面通常都会用Join来连接两个表,做复杂的关联查询.比如用户表和订单表,能通过join得到某个用户购买的产品:或者某个产品被购买的人群.... Hive也支持这样的操作,而且由于Hive底层运 ...
- 大数据hadoop安装
hadoop集群搭建--CentOS部署Hadoop服务 在了解了Hadoop的相关知识后,接下来就是Hadoop环境的搭建,搭建Hadoop环境是正式学习大数据的开始,接下来就开始搭建环境!我们用到 ...
随机推荐
- Checked异常和Runtime异常体系
Java的异常被分为两大类:Checked异常和Runtime异常(运行时异常).所有的RuntimeException类及其子类的实例被称为Runtime异常:不是RuntimeException类 ...
- java Long、Integer 、Double、Boolean类型 不能直接比较
测试: System.out.println(new Long(1000)==new Long(1000)); System.out.println(new Integer(1000)==new In ...
- HDU 6127 Hard challenge (极角扫描)
题意:给定 n 个点,和权值,他们两两相连,每条边的权值就是他们两个点权值的乘积,任意两点之间的直线不经过原点,让你从原点划一条直线,使得经过的直线的权值和最大. 析:直接进行极角扫描,从水平,然后旋 ...
- CodeForces 339B Xenia and Ringroad(水题模拟)
题意:给定 n 个地方,然后再给 m 个任务,每个任务必须在规定的地方完成,并且必须按顺序完成,问你最少时间. 析:没什么可说的,就是模拟,记录当前的位置,然后去找和下一个位置相差多长时间,然后更新当 ...
- 大型Unity手游《英雄之刃-最后之战》源码分析
英雄之刃之最后一战是国内首款原创精品MOBA手游,是一款由前暴雪文案亲自操刀世界观,日韩专业团队打造美术场景,新加坡团队精心制作战斗音乐的旷世之作! 超快速的匹配对战.默契的团队协作给你带来意犹未尽的 ...
- c# MSMQ 消息队列
转 消息队列 http://www.cnblogs.com/anbylau2130/p/3469512.html
- Linux 判断进程是否已经运行的程序
bool ServerProcess::isAlreadyRunning() { #ifndef __linux__ WarningLog(<<"can't check if p ...
- Oracle数据表转换为Shapefile(二)
在上一篇博文<Oracle数据表转换为Shapefile(一)>中详细描述了一种基于Oracle数据表生产Shapefile的技术方法,本文同样以详细图解的方式描述一种更便捷的方法来完成同 ...
- JulyNovel-React
写在前面的话 目前,JulyNovel后端框架基本搭建.部署完毕,GraphQL提供的API接口也有着高可用性,数据库里也存了六七百兆爬来的小说数据,是时候开始写前端了. 框架选用 JulyNovel ...
- IIS 发布webservice 需要用户名和密码访问 解决
今天,我在IIS上发布了一个自己写的webservice,然后我在远程通过浏览器来访问这个webservice的时候出现一个登录界面如下 之前我朋友发布webservice的时候也出现过一次,那次好 ...