
SqlServer 在查询结果中如何过滤掉重复数据
问题背景

SELECT *

FROM (

SELECT ROW_NUMBER() OVER ( ORDER BY T.USERID asc )AS Row

,T.USERID

,T.CreateTime

FROM UserInfo T

LEFT JOIN DiseaseInfo i ON i.UserID=T.UserID

) TT WHERE TT.Row between 0 AND 20 ORDER BY UserID DESC
SELECT DISTINCT ROW ,*

FROM (

SELECT ROW_NUMBER() OVER (PARTITION BY T.USERID ORDER BY T.USERID asc )AS Row

,T.USERID

,T.CreateTime

FROM UserInfo T

LEFT JOIN DiseaseInfo i ON i.UserID=T.UserID

) TT WHERE TT.Row between 0 AND 12 ORDER BY UserID DESC


SELECT *

FROM (

SELECT ROW_NUMBER() OVER ( order by T.USERID asc )AS Row

,T.USERID

,LEFT(T.Patient_Tel1,5)+'' AS Tel

,T.CreateTime

,h.HName

,h.HID

fromUserInfo T

LEFT JOIN ClinicInfo c ON c.UserID=T.UserID AND C.Disabled=1

LEFT JOIN HospitalInfo H ON H.HID=c.VisitHospital WHERE T.Disabled=1

AND t.UserID>=17867 AND T.UserID<=17875

--(T.Patient_Tel1 like '%13800000000%')

) TT WHERE

TT.Row between 0and20

SELECT DISTINCT row,*

FROM (

SELECT ROW_NUMBER() OVER ( partition by T.USERID order by T.USERID asc )AS Row

,T.USERID

,LEFT(T.Patient_Tel1,5)+'' AS Tel

,T.CreateTime

,h.HName

,h.HID

fromUserInfo T

LEFT JOIN ClinicInfo c ON c.UserID=T.UserID AND C.Disabled=1

LEFT JOIN HospitalInfo H ON H.HID=c.VisitHospital WHERE T.Disabled=1

AND t.UserID>=17867 AND T.UserID<=17875

--(T.Patient_Tel1 like '%13800000000%')

) TT WHERE

--row=1 AND

TT.Row between 0 and 20

SELECT *

FROM (

--partition by T.USERID 以UserID对结果集进行分区

SELECT ROW_NUMBER() OVER ( partition by T.USERID order by T.USERID asc )AS Row

,T.USERID

,LEFT(T.Patient_Tel1,5)+'' AS Tel

,T.CreateTime

,h.HName

,h.HID

fromUserInfo T

LEFT JOIN ClinicInfo c ON c.UserID=T.UserID AND C.Disabled=1

LEFT JOIN HospitalInfo H ON H.HID=c.VisitHospital WHERE T.Disabled=1

AND t.UserID>=17867 AND T.UserID<=17875

--(T.Patient_Tel1 like '%13800000000%')

) TT WHERE

--因为之前已经以UserID对结果集进行分区,所以如果存在重复的字段则row的值会不相同

--row=1 AND

TT.Row between 0 and 20
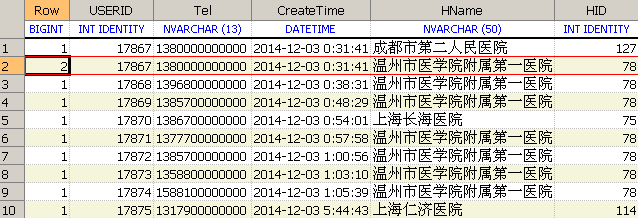

-- 新增一层查询解决过滤掉重复数据后无法分页的问题

SELECT * FROM (

SELECT ROW_NUMBER() OVER (ORDER BY userid) AS RowNum,*

FROM (

--partition by T.USERID 以UserID对结果集进行分区

SELECT ROW_NUMBER() OVER ( partition by T.USERID order by T.USERID asc )AS Row

,T.USERID

,LEFT(T.Patient_Tel1,5)+'' AS Tel

,T.CreateTime

,h.HName

,h.HID

fromUserInfo T

LEFT JOIN ClinicInfo c ON c.UserID=T.UserID AND C.Disabled=1

LEFT JOIN HospitalInfo H ON H.HID=c.VisitHospital WHERE T.Disabled=1

AND t.UserID>=17867 AND T.UserID<=20875

--(T.Patient_Tel1 like '%13800000000%')

) TT

)AS T

WHERE

--过滤重复数据

Row=1

--对结果进行分页

AND RowNum between 13 and 24

SqlServer 在查询结果中如何过滤掉重复数据的更多相关文章
- MySQL查询表中某个字段的重复数据
1. 查询SQL表中某个字段的重复数据 SELECT user_name,COUNT(*) AS count FROM db_user_info GROUP BY user_name HAVING c ...
- mysql去重, 把url重复且区为空的中去掉、统计重复数据、、结果集去重合并成一行
delete from 表名 where id not in (select d.id from (SELECT id FROM 表名 GROUP BY c1,c2,c3,c4)as d) #去重复, ...
- Mysql中查找并删除重复数据的方法
(一)单个字段 1.查找表中多余的重复记录,根据(question_title)字段来判断 代码如下 复制代码 select * from questions where question_title ...
- 查询Oracle中字段名带"."的数据
SDE中的TT_L线层会有SHAPE.LEN这样的字段,使用: SQL>select shape.len from tt_l; 或 SQL>select t.shape.len from ...
- SQL-游标-查询数据库中的所有表的数据个数
--sql语句-游标等使用 ) ) declare @i INT ) declare @cstucount INT --上方设置变量 --初始值 declare mCursor cursor --设置 ...
- 用java查询HBase中某表的一批数据
java代码如下: package db.query; import java.io.IOException; import org.apache.hadoop.conf.Configuration; ...
- 【SQL】查询数据库中某个字段有重复值出现的信息
select name,mobile from [GeneShop].[dbo].[xx_member] where mobile in ( SELECT mobile FROM [GeneShop] ...
- mysql查询sql中检索条件为大批量数据时处理
当userIdArr数组值为大批量时,应如此优化代码实现
- Java中List集合去除重复数据的方法
1. 循环list中的所有元素然后删除重复 public static List removeDuplicate(List list) { for ( int i = 0 ; i < list. ...
随机推荐
- Urllib库的基本用法
1.什么是url? 统一资源定位符是对可以从互联网上得到的资源的位置和访问方法的一种简洁的表示,是互联网上标准资源的地址. 基本URL包含模式(或称协议).服务器名称(或IP地址).路径和文件名,如“ ...
- cbv
- [BZOJ5287][HNOI2018]毒瘤(虚树DP)
暴力枚举非树边取值做DP可得75. 注意到每次枚举出一个容斥状态的时候,都要做大量重复操作. 建立虚树,预处理出虚树上两点间的转移系数.也可动态DP解决. 树上倍增.动态DP.虚树DP似乎是这种问题的 ...
- [BZOJ4567][SCOI2016]背单词(Trie+贪心)
1.题意表述十分难以理解,简单说就是:有n个单词,确定一个背的顺序,使总代价最小. 2.因为第(1)种情况的代价是n*n,这个代价比任何一种不出现第(1)种情况的方案都要大,所以最后肯定不会出现“背某 ...
- BZOJ.3498.[PA2009]Cakes(三元环 枚举)
题目链接 感觉我可能学的假的(复杂度没问题,但是常数巨大). 一个比较真的说明见这儿:https://czyhe.me/blog/algorithm/3-mem-ring/3-mem-ring/. \ ...
- SpringBoot静态资源目录
在web开发中,静态资源的访问是必不可少的,如:图片.js.css 等资源的访问. SpringBoot对静态资源访问提供了很好的支持,基本使用默认配置就能满足开发需求. 在传统的web项目中静态资源 ...
- Codeforces Round #288 (Div. 2) C. Anya and Ghosts 模拟 贪心
C. Anya and Ghosts time limit per test 2 seconds memory limit per test 256 megabytes input standard ...
- ACdream 速攻组~
1007 a + b /*这题就是一个快速幂,但是十分猥琐的是,模是1e10 + 7,不是1e9 + 7,这就产生了一个爆long long的问题.所以要对快速幂中的乘法操作进行一下改造.请教了BIT ...
- Linux终端(Xshell等)的编码设置
先简单说说一下遇到的情况吧: 在用类似Xshell的工具连接远端Linux时,运行命令ls时,如果有中文,就会显示有乱码: 网上查资料时,也把相应的连接属性修改为utf-8了(见下图),但是还是不行: ...
- phpcms功能列表
上1 站点首页 就是前台首页 会员中心 跳到会员中心页面 搜索 新闻,图片等文档搜索 锁屏 锁住账号 Phpcms 官网 授权 官网查询 支持论坛 官网论坛 帮助 官网帮助 上2 我的面板 个人信息 ...