
Redis配置与优化
一、缓存概念
缓存是为了调节速度不一致的两个或多个不同的物质的速度,在中间对速度较慢的一方起到加速作用,比如CPU的一级、二级缓存是保存了CPU最近经常访问的数据,内存是保存CPU经常访问硬盘的数据,而且硬盘也有大小不一的缓存,甚至是物理服务器的raid 卡有也缓存,都是为了起到加速CPU 访问硬盘数据的目的,因为CPU的速度太快了,CPU需要的数据由于硬盘往往不能在短时间内满足CPU的需求,因此CPU缓存、内存、Raid 卡缓存以及硬盘缓存就在一定程度上满足了CPU的数据需求,即CPU 从缓存读取数据可以大幅提高CPU的工作效率。
1. 系统缓存
buffer与cache buffer:缓冲也叫写缓冲,一般用于写操作,可以将数据先写入内存再写入磁盘,buffer 一般用于写缓冲,用于解决不同介质的速度不一致的缓冲,先将数据临时写入到里自己最近的地方,以提高写入速度,CPU会把数据先写到内存的磁盘缓冲区,然后就认为数据已经写入完成看,然后由内核在后续的时间在写入磁盘,所以服务器突然断电会丢失内存中的部分数据。
cache:缓存也叫读缓存,一般用于读操作,CPU读文件从内存读,如果内存没有就先从硬盘读到内存再读到CPU,将需要频繁读取的数据放在里自己最近的缓存区域,下次读取的时候即可快速读取。
2.缓存保存位置及分层结构 互联网应用领域,提到缓存为王
用户层: 浏览器DNS缓存,应用程序DNS缓存,操作系统DNS缓存客户端
代理层: CDN,反向代理缓存
Web层: Web服务器缓存
应用层 : 页面静态化
数据层: 分布式缓存,数据库
系统层: 操作系统cache
物理层: 磁盘cache, Raid Cache
DNS缓存 浏览器的DNS缓存默认为60秒,即60秒之内在访问同一个域名就不在进行DNS解析
应用层缓存 Nginx、PHP等web服务可以设置应用缓存以加速响应用户请求,另外有些解释性语言,比如:PHP/Python/Java不能直接运行,需要先编译成字节码,但字节码需要解释器解释为机器码之后才能执行,因此字节码也是一种缓存,有时候还会出现程序代码上线后字节码没有更新的现象。所以一般上线新版前,需要先将应用缓存清理,再上线新版。
另外可以利用动态页面静态化技术,加速访问,比如:将访问数据库的数据的动态页面,提前用程序生成静态页面文件html 电商网站的商品介绍,评论信息非实时数据等皆可利用此技术实现。
数据层缓存 分布式缓存服务
Redis
Memcached
数据库
MySQL 查询缓存
innodb缓存、MYISAM缓存
硬件缓存 CPU缓存(L1的数据缓存和L1的指令缓存)、二级缓存、三级缓存
磁盘缓存:Disk Cache
磁盘阵列缓存: Raid Cache,可使用电池防止断电丢失数据
二、关系数据库和非关系数据库
1.什么是关系型数据库
一个结构化的数据库,创建在关系模型基础上 (二维表格模型)基础上
一般面向于记录
SQL语句(标准数据查询语言)
就是一种基于关系型数据库的语言,用于执行对关系型数据库中数据的检索和操作。 包括:Oracle、MySQL、SQL Server、Microsoft Access、DB2等
2.什么是非关系型数据库 NoSQL (NoSQL=NotOnlySQL), 意思是“不仅仅是SQL",是非关系型数据库的总称。
除了主流的关系型数据库外的数据库,都认为是非关系型。
主流的NoSQL数据库有Redis、MongBD、Hbase、Memcached等。
3.非关系型数据库的产生背景 High performance——对数据库高并发读写需求
Huge Storage——对海量数据高效存储与访问需求
High Scalability && High Availability——对数据库高可扩展性与高可用性需求
4.关系型数据库和非关系型数据库区别
1)数据存储方式不同
关系型和非关系型数据库的主要差异是数据存储的方式。
关系型数据天然就是表格式的,因此存储在数据表的行和列中。数据表可以彼此关联协作存储,也很容易提取数据。
非关系型与其相反,数据不适合存储在数据表的行和列中,而是大块组合在一起。非关系型数据通常存储在数据集中,就像文档、键值对或者图结构。你的数据及其特性是选择数据存储和提取方式的首要影响因素。
关系型:依赖于关系模型E-R图,同时以表格式的方式存储数据 非关系型:除了以表格形式存储之外,通常会以大块的形式组合在一一起进行存储数据
2)扩展方式不同
SQL和NoSQL数据库最大的差别可能是在扩展方式上,要支持日益增长的需求当然要扩展。
要支持更多并发量,SQL数据库是纵向扩展,也就是说提高处理能力,使用速度更快速的计算机,这样处理相同的数据集就更快了。
因为数据存储在关系表中,操作的性能瓶颈可能涉及很多个表,这都需要通过提高计算机性能来客服。虽然SQL数据库有很大扩展空间,但最终肯定会达到纵向扩展的上限。
而NoSQL数据库是横向扩展的。因为非关系型数据存储天然就是分布式的,NoSQL数据库的扩展可以通过给资源池添加更多普通的数据库服务器(节点) 来分担负载。
关系:纵向(天然表格式) 非关:横向(天然分布式)
3) 对事务性的支持不同
如果数据操作需要高事务性或者复杂数据查询需要控制执行计划,那么传统的SQL数据库从性能和稳定性方面考虑是最佳选择。
SQL数据库支持对事务原子性细粒度控制,并且易于回滚事务。
虽然NoSQL数据库也可以使用事务操作,但稳定性方面没法和关系型数据库比较,所以优势在操作的扩展性和大数据量处理方面。
关系型:特别适合高事务性要求和需要控制执行计划的任务 非关系:此处会稍显弱势,其优势在于高扩展性和大数据量处理方面
总结
关系型数据库: 实例->数据库->表(table)->记录行(row)、数据字段(column)
非关系型数据库: 实例->数据库->集合(collection)–>键值对(key-value) 非关系型数据库不需要手动建数据库和集合(表)。
三 、Redis介绍
Redis是一个开源的、使用C语言编写的NoSOL数据库,Redis服务器程序是单进程模型。
Redis基于内存运行并支持持久化(支持存储在磁盘),采用key-value(键值对)的存储形式,是目前分布式架构中不可或缺的一环。
Redis服务在一台服务器上可以同时启动多个Redis进程,Redis的实际处理速度则是完全依靠于主进程的执行效率。
若在服务器上只运行一个Redis进程, 当多个客户端同时访问时, 服务器的处理能力是会有一定程度的下降;
若在同一台服务器上开启 多个Redis进程, Redis在提高并发处理能力的同时会给服务器的CPU造成很大压力。
即在实际生产环境中, 需要根据实际的需求来决定开启多少个Redis进程。 (一般建议开启2个,用作备份和抗高并发)
若对高并发要求更高一些, 可能会考虑在同一台服务器上开启多个进程。 若CPU资源比较紧张,采用单进程即可。
四 、Redis优点
具有极高的数据读写速度:数据读取的速度最高可达到110000次/s,数据写入速度最高可达到81000次/s。、
支持丰富的数据类型:支持key-value、 Strings、Lists、Hashes ( 散列值)、Sets及OrderedSets等数据类型操作。 pS : string 字符串(可以为整形、浮点和字符型,统称为元素) list列表:(实现队列,元素不唯一,先入先出原则) set 集合:(各不相同的元素) hash hash散列值:( hash的key必须是唯一的) set /ordered sets集合/有序集合
支持数据的持久化:可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。
原子性: Redis所有 操作都是原子性的。
支持数据备份:即master-salve 模式的数据备份。
五、单线程 Redis 6.0版本前一直是单线程方式处理用户的请求
单线程为何如此快?
纯内存
非阻塞
避免线程切换和竞态消耗
六、redis 对比 memcached
支持数据的持久化:可以将内存中的数据保持在磁盘中,重启redis服务或者服务器之后可以从备份文件中恢复数据到内存继续使用
支持更多的数据类型:支持string(字符串)、hash(哈希数据)、list(列表)、set(集合)、zset(有序集合)
支持数据的备份:可以实现类似于数据的master-slave模式的数据备份,另外也支持使用快照+AOF
支持更大的value数据:memcache单个key value最大只支持1MB,而redis最大支持512MB(生产不建议超过2M,性能受影响)
在Redis6版本前,Redis 是单线程,而memcached是多线程,所以单机情况下没有memcached 并发高,性能更好,但redis 支持分布式集群以实现更高的并发,单Redis实例可以实现数万并发
支持集群横向扩展:基于redis cluster的横向扩展,可以实现分布式集群,大幅提升性能和数据安全性
都是基于 C 语言开发
七 、Redis安装部署
部署步骤
1)# 关闭防火墙和SElinux
systemctl stop firewalld
systemctl disable firewalld
setenforce 0

2)#安装gcc gcc-c++ 编译器
yum install -y gcc gcc-c++ make

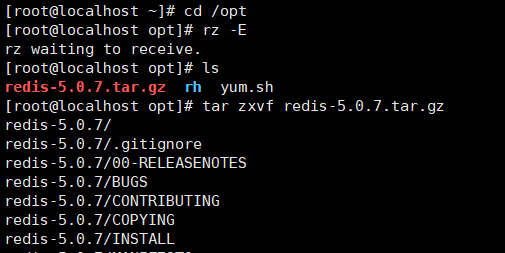
3)#切换至/opt目录,把下载好的安装包上传进来并解压
cd /opt/
tar zxvf redis-5.0.7.tar.gz
4)#进入目录然后编译安装
cd /opt/redis-5.0.7/
make
make PREFIX=/usr/local/redis install
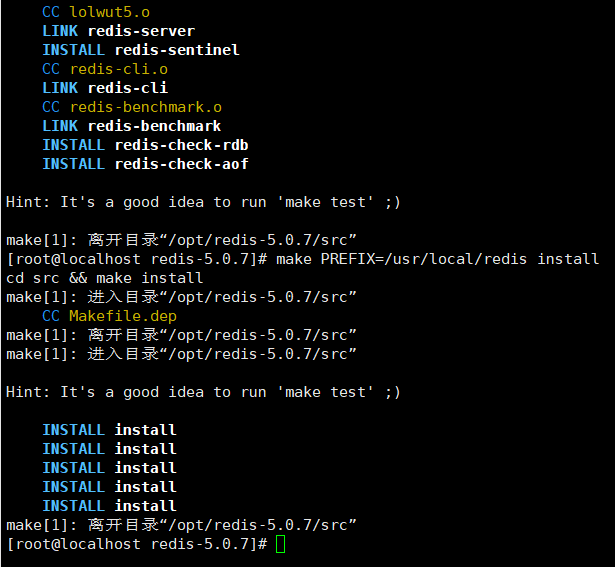
#由于Redis源码包中直接提供了Makefile 文件,所以在解压完软件包后,不用先执行./configure 进行配置,可直接执行make与make install命令进行安装
5)#执行install_server.sh脚本
cd /opt/redis-5.0.7/utils
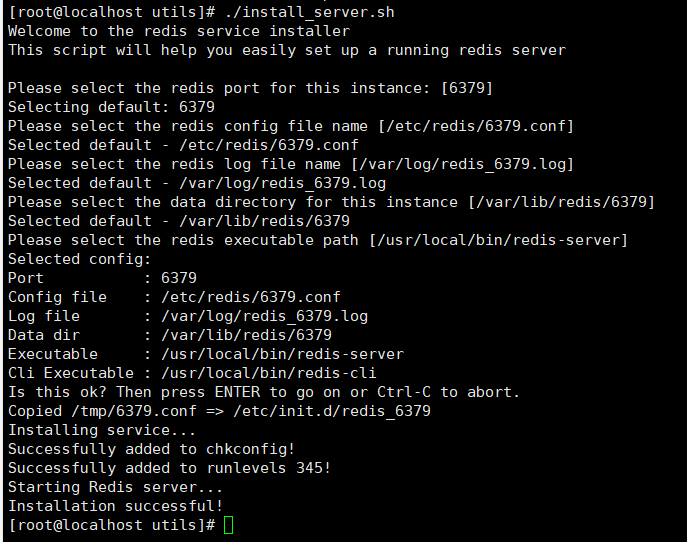
./install_server.sh #一路回车,指导让你输入路径这一步
#路径需要手动输入
Please select the redis executable path [] /usr/local/redis/bin/ redis-server
Selected config: Port : 6379 #默认侦听端口为6379
Config file : /etc/redis/6379.conf #配置文件路径
Log file : /var/log/redis_6379.log #日志文件路径
Data dir : /var/lib/ redis/6379 #数据文件路径
Executable : /usr/local/redis/bin/redis-server #可执行文件路径
Cli Executable : /usr/local/redis/bin/redis-cli #客户端命令工具
6)#优化路径并查端口是否打开
#把redis的可执行程序文件放入路径环境变量的目录中便于系统识别
ln -s /usr/local/redis/bin/* /usr/local/bin/
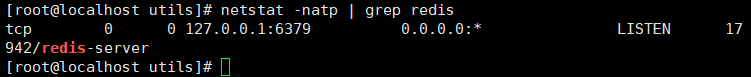
#当install_server.sh 脚本运行完毕,Redis 服务就已经启动,默认侦听端口为6379
netstat -natp | grep redis
7)#修改配置文件
vim /etc/redis/6379.conf
bind 127.0.0.1 172.168.10.1 #70行,添加监听的主机地址
port 6379 #93行,Redis默认的监听端口
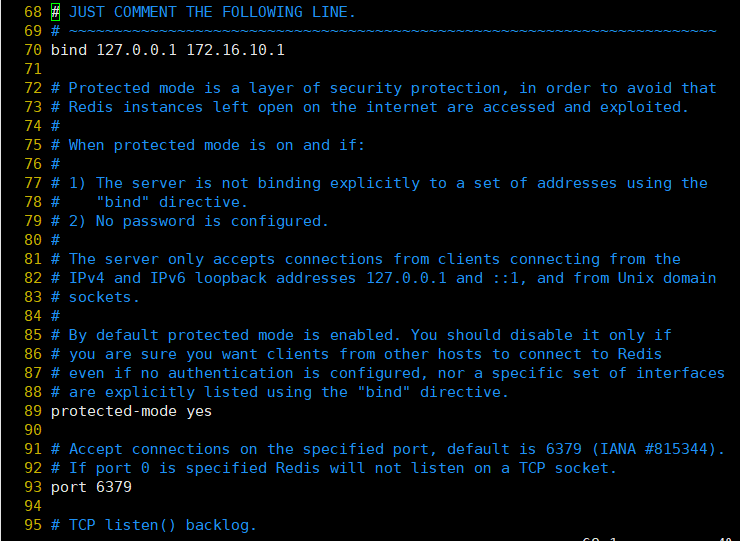
daemonize yes #137行,启用守护进程
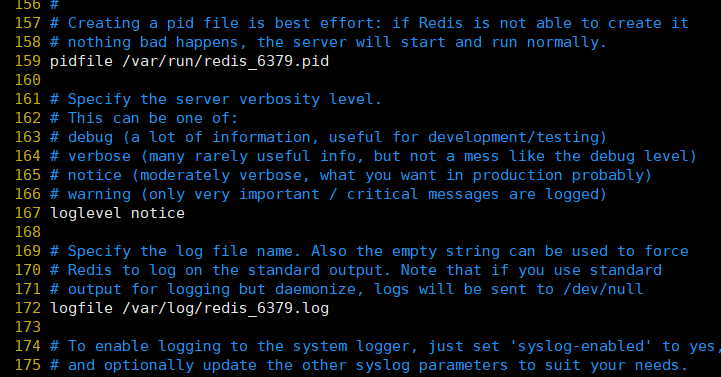
pidfile /var/run/redis_6379.pid #159行,指定PID文件

loglevel notice #167行,日志级别
logfile /var/log/redis_6379.log #172行,指定日志文
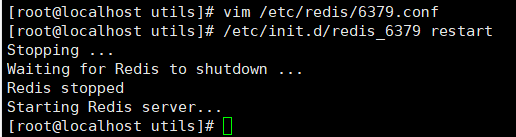
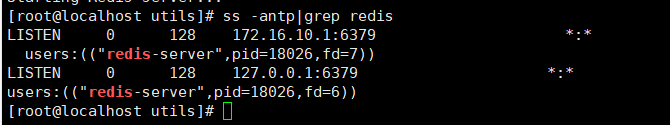
8) #重启redis查看监听的地址
/etc/init.d/redis_6379 restart #重启
ss -antp|grep redis
9)##Redis服务控制
/etc/init.d/redis_6379 stop #停止
/etc/init.d/redis_6379 start #启动
/etc/init.d/redis_6379 restart #重启
/etc/init.d/redis_6379 status #状态
Redis命令工具
rdb 和 aof 是redis服务中持久化功能的两种形式 redis-cli常用于登陆至redis数据库
Redis命令工具 功能
redis-server 用于启动Redis的工具
redi s-benchmark 用于检测Redis在本机的运行效率
redis-check-aof 修复AOF持久化文件
redis-check-rdb 修复RDB持久化文件
redis-cli: Redis命令行工具
redis-cli命令行工具(远程登录)
语法: redis-cli -h host -p port -a password
选项:
-h :指定远程主机
-p :指定Redis 服务的端口号
-a :指定密码,未设置数据库密码可以省略-a选项
-n :指定进入库的序列号 若不添加任何选项表示,则使用127.0.0.1:6379 连接本机上的 Redis 数据库,
#示例 redis-cli -h 172.16.10.1 -p 6379
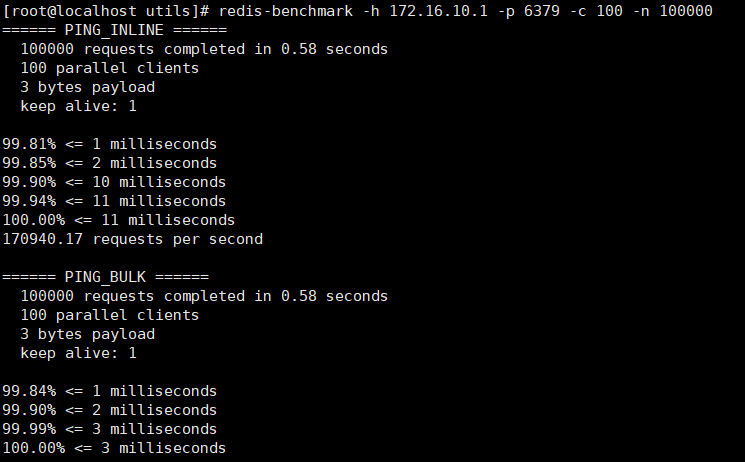
redis-benchmark 是官方自带的 Redis 性能测试工具,可以有效的测试 Redis 服务的性能。
#语法 redis-benchmark [选项] [选项值]
选项 作用
-h 指定服务器主机名
-p 指定服务器端口
-s 指定服务器socket(套接字)
-c 指定并发连接数
-n 指定请求数
-d 以字节的形式指定SET/GET值的数据大小
-k 1=keep alive O=reconnect
-r SET/GET/INCR使用随机key,SADD使用随机值
-P 通过管道传输请求
-q 强制退出redis,仅显示querylsec值
-csv 以csv格式输出
-1 生成循环,永久执行测试
-t 仅运行以逗号分隔的测试命令列表
-l ldle模式,仅打开N个idle连接并等待
示例1: 向IP地址为172.16.10.1、端口为6379的Redis服务器发送100个并发连接与100000个请求测试性能
redis-benchmark -h 172.16.10.1 -p 6379 -c 100 -n 100000
八、Redis数据库常用命令
常用命令
set: 存放数据,命令格式为 set key value
get: 获取数据,命令格式为 get key
命令 解释
set 存放数据
get 获取数据
keys s * 获取所有的key
keys s* 以s开头的数据
keys s? 以s开头后面包含任意—位的数据
exists aaa 判断aaa是否存在(存在:1,不存在:0)
delkey 删除当前数据库的key
type key 获取key对应的value值类型
rename key1 key2 将key1修改为key2
renamenx key1 key2 将key1修改为key2之前判断key2是否存在,不存在则重命名
dbsize 查看当前数据库中key的数目
Redis配置与优化的更多相关文章
- NoSQL 之 Redis配置与优化
NoSQL 之 Redis配置与优化 1.关系数据库与非关系型数据库概述 2.关系数据库与非关系型数据库区别 3.非关系型数据库产生背景 4.Redis简介 5.Redis安装部署 6.Redis 命 ...
- NoSQL之Redis配置与优化
NoSQL之Redis配置与优化 目录 NoSQL之Redis配置与优化 一.关系数据库和非关系数据库 1. 关系型数据库 2. 非关系型数据库 3. 非关系型数据库产生背景 4. 关系型数据库和非关 ...
- 2.NoSQL之Redis配置与优化
一.关系型数据库与非关系数据库 关系型数据库: 关系型数据库是一个结构化的数据库,创建在关系模型(二维表格模型)基础上,一般面向于记录. sQL语句(标准数据查询语言)就是一种基于关系型数据库的语言, ...
- EF架构~通过EF6的DbCommand拦截器来实现数据库读写分离~终结~配置的优化和事务里读写的统一
回到目录 本讲是通过DbCommand拦截器来实现读写分离的最后一讲,对之前几篇文章做了一个优化,无论是程序可读性还是实用性上都有一个提升,在配置信息这块,去除了字符串方式的拼接,取而代之的是sect ...
- Redis Cluster架构优化
Redis Cluster架构优化 在<全面剖析Redis Cluster原理和应用>中,我们已经详细剖析了现阶段Redis Cluster的缺点: 无中心化架构 Gossip消息的开销 ...
- 14. Redis配置统计字典
14. Redis配置统计字典14.1 info系统状态说明14.1.1 命令说明14.1.2 详细说明14.2 standalone配置说明和分析14.2.1 总体配置14.2.2 最大内存及策略1 ...
- Java系统高并发之Redis后端缓存优化
一:前端优化 暴露接口,按钮防重复(点击一次按钮后就变成禁用,禁止重复提交) 采用CDN存储静态化的页面和一些静态资源(css,js等) 二:Redis后端缓存优化 Redis 是完全开源免费的,遵守 ...
- php-fpm安装、配置与优化
转载自:https://www.zybuluo.com/phper/note/89081 1.php中fastcgi和php-fpm是什么东西 最近在研究和学习PHP的性能方面的知识,看到了factc ...
- redis 配置
一 Redis 支持写的指令 Redis大概的命令如下:set setnx setex appendincr decr rpush lpush rpushx lpushx linsert lset r ...
随机推荐
- 【ACM程序设计】差分
差分 假设有一个数列,我们需要对数列中的一个区间加上或减去一个值,直接想到的便是对该区间进行一次循环逐项加减. 但是当请求的操作变得非常多的时候,每次请求都进行一次循环会很容易爆时间,因此我们引入了差 ...
- 深度长文:深入理解Ceph存储架构
点击上方"开源Linux",选择"设为星标" 回复"学习"获取独家整理的学习资料! 本文是一篇Ceph存储架构技术文章,内容深入到每个存储特 ...
- 干货 | 一文彻底读懂nginx中的location指令
一个执着于技术的公众号 Nginx系列导读 给小白的 Nginx 10分钟入门指南 Nginx编译安装及常用命令 完全卸载nginx的详细步骤 Nginx 配置文件详解 一文带你读懂Nginx反向代理 ...
- Volatile的学习
首先先介绍三个性质 可见性 可见性代表主内存中变量更新,线程中可以及时获得最新的值. 下面例子证明了线程中可见性的问题 由于发现多次执行都要到主内存中取变量,所以会将变量缓存到线程的工作内存,这样当其 ...
- leetcode 3. Longest Substring Without Repeating Characters 无重复字符的最长子串
一.题目大意 https://leetcode.cn/problems/longest-substring-without-repeating-characters/ 给定一个字符串 s ,请你找出其 ...
- 690. Employee Importance - LeetCode
Question 690. Employee Importance Example 1: Input: [[1, 5, [2, 3]], [2, 3, []], [3, 3, []]], 1 Outp ...
- debconf-utils-交互式安装时预配置
debconf-utils是一个可以在Ubuntu下预先配置要安装程序的小工具,它可以避免在安装一个DEB程序时的弹窗输入问题,这可能在编写一键部署脚本的时候非常有用. 以下我们用安装MySQL-AP ...
- el-form 中的数组表单验证(数组可动态添加删除)
除了一些简单的表单验证之外,我们还会有一些稍微复杂点的多层级表单的验证,如下图所示可点击添加,删除对数组进行操作,当点击确定时需要验证每一条form-item不能为空 其tempalte部分主要代码如 ...
- .Net分表分库动态化处理
介绍 本期主角:ShardingCore 一款ef-core下高性能.轻量级针对分表分库读写分离的解决方案,具有零依赖.零学习成本.零业务代码入侵 背景 最近有个小伙伴来问我,分表下他有一批数据,这个 ...
- Linux Cgroup v1(中文翻译)(3):CPU Accounting Controller
英文原文: https://www.kernel.org/doc/html/latest/admin-guide/cgroup-v1/cpuacct.html CPU Accounting Contr ...