
1.5.5 HDFS读写解析-hadoop-最全最完整的保姆级的java大数据学习资料
1.5.5 HDFS读写解析
1.5.5.1 HDFS读数据流程
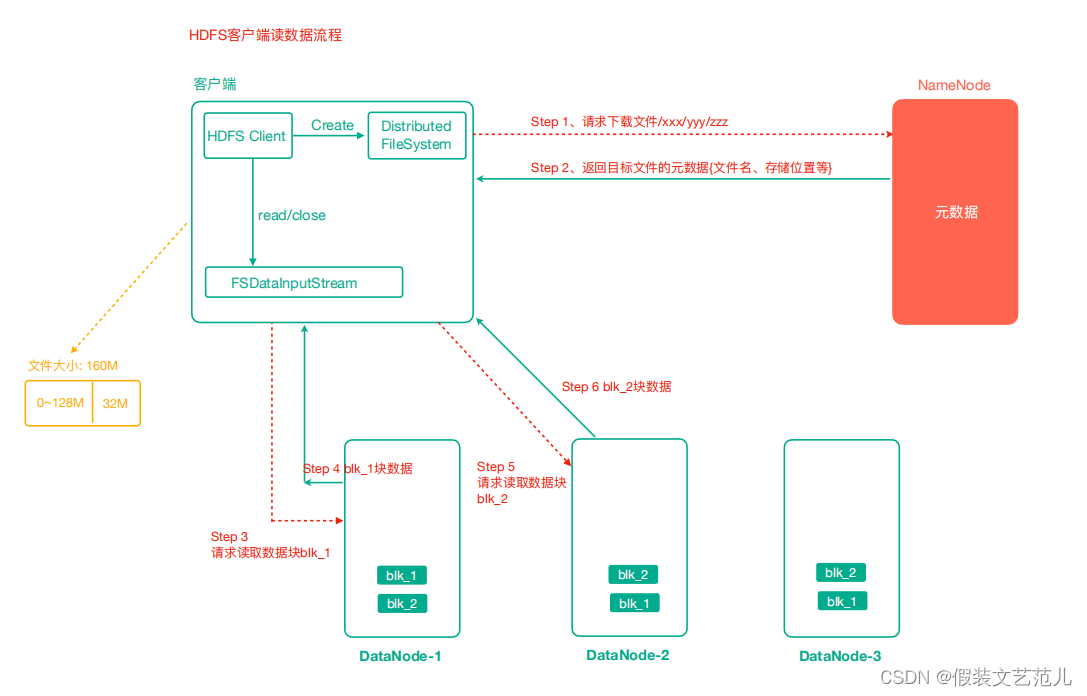
- 客户端通过Distributed FileSystem向NameNode请求下载文件,NameNode通过查询元数据, 找到文件块所在的DataNode地址。
- 挑选一台DataNode(就近原则,然后随机)服务器,请求读取数据。
- DataNode开始传输数据给客户端(从磁盘里面读取数据输入流,以Packet为单位来做校验)。
- 客户端以Packet为单位接收,先在本地缓存,然后写入目标文件。
1.5.5.2 HDFS写数据流程
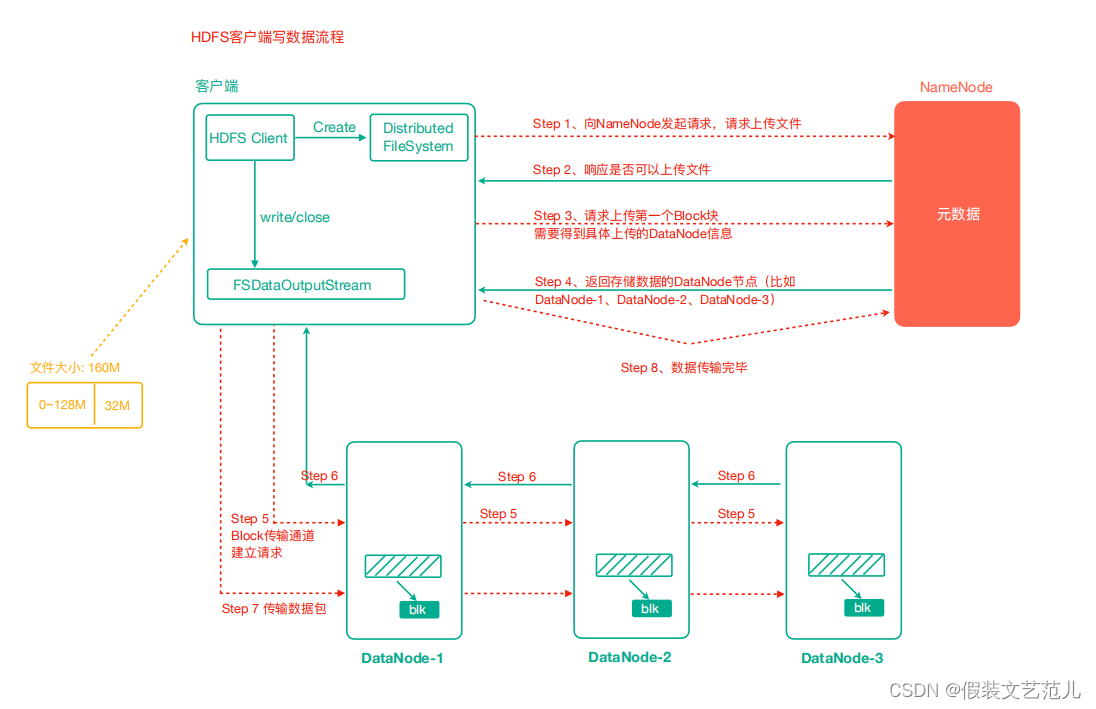
客户端通过Distributed FileSystem模块向NameNode请求上传文件,NameNode检查目标文件是否已存在,父目录是否存在。
NameNode返回是否可以上传。
客户端请求第一个 Block上传到哪几个DataNode服务器上。
NameNode返回3个DataNode节点,分别为dn1、dn2、dn3。
客户端通过FSDataOutputStream模块请求dn1上传数据,dn1收到请求会继续调用dn2,然后dn2调用dn3,将这个通信管道建立完成。
dn1、dn2、dn3逐级应答客户端。
客户端开始往dn1上传第一个Block(先从磁盘读取数据放到一个本地内存缓存),以Packet为单位,dn1收到一个Packet就会传给dn2,dn2传给dn3;dn1每传一个packet会放入一个确认队列等待确认。
当一个Block传输完成之后,客户端再次请求NameNode上传第二个Block的服务器。(重复执行 3-7步)。
验证Packet代码
@Test

public void testUploadPacket() throws IOException {

    //1 准备读取本地文件的输入流

    final FileInputStream in = new FileInputStream(new File("e:/lagou.txt"));

    //2 准备好写出数据到hdfs的输出流

    final FSDataOutputStream out = fs.create(new Path("/lagou.txt"), new Progressable() {

        public void progress () { //这个progress方法就是每传输64KB(packet)就会执行一次,

            System.out.println("&");

        }

    });

    //3 实现流拷贝

    IOUtils.copyBytes(in, out, configuration); //默认关闭流选项是true,所以会自动 关闭

    //4 关流         可以再次关闭也可以不关了

}
1.5.5 HDFS读写解析-hadoop-最全最完整的保姆级的java大数据学习资料的更多相关文章
- 大数据学习之Hadoop快速入门
1.Hadoop生态概况 Hadoop是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠.高效 ...
- 大数据学习笔记——Hadoop编程实战之HDFS
HDFS基本API的应用(包含IDEA的基本设置) 在上一篇博客中,本人详细地整理了如何从0搭建一个HA模式下的分布式Hadoop平台,那么,在上一篇的基础上,我们终于可以进行编程实操了,同样,在编程 ...
- 大数据学习(一) | 初识 Hadoop
作者: seriouszyx 首发地址:https://seriouszyx.top/ 代码均可在 Github 上找到(求Star) 最近想要了解一些前沿技术,不能一门心思眼中只有 web,因为我目 ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
- 大数据学习系列之六 ----- Hadoop+Spark环境搭建
引言 在上一篇中 大数据学习系列之五 ----- Hive整合HBase图文详解 : http://www.panchengming.com/2017/12/18/pancm62/ 中使用Hive整合 ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- 大数据学习之路之Hadoop
Hadoop介绍 一.简介 Hadoop是一个开源的分布式计算平台,用于存储大数据,并使用MapReduce来处理.Hadoop擅长于存储各种格式的庞大的数据,任意的格式甚至非结构化的处理.两个核心: ...
- 大数据学习笔记之Hadoop(二):HDFS文件系统
文章目录 一 HDFS概念 1.1 概念 1.2 组成 1.3 HDFS 文件块大小 二 HFDS命令行操作 三 HDFS客户端操作 3.1 eclipse环境准备 3.1.1 jar包准备 3.2 ...
- 大数据学习之HDFS基本API操作(下)06
hdfs文件流操作方法一: package it.dawn.HDFSPra; import java.io.BufferedReader; import java.io.FileInputStream ...
- 大数据学习-2 认识Hadoop
一.什么是Hadoop? Hadoop可以简单的理解为一个数据存储和数据分析分布式系统.随着互联网的普及产生的数据是非常的庞大的,那么我们怎么去处理这么大量的数据呢?传统的单一计算机肯定是完成不了的, ...
随机推荐
- 几篇关于MySQL数据同步到Elasticsearch的文章---第二篇:canal 实现Mysql到Elasticsearch实时增量同步
文章转载自: https://mp.weixin.qq.com/s?__biz=MzI2NDY1MTA3OQ==&mid=2247484377&idx=1&sn=199bc88 ...
- MySQL集群搭建(1)-主备搭建
数据库在任何业务中都是最重要的环节之一,这就对数据库架构提出的较高的要求.单点数据库永远不应该出现在生产环境,我们已经目睹过太多由于单点.备份缺失造成的损失,所以,搭建高可用 MySQL 集群是非常有 ...
- 类似-Xms、-Xmn这些参数的含义
答: 堆内存分配: JVM初始分配的内存由-Xms指定,默认是物理内存的1/64 JVM最大分配的内存由-Xmx指定,默认是物理内存的1/4 默认空余堆内存小于40%时,JVM就会增大堆直到-Xmx的 ...
- DirectX 使用 Vortice 从零开始控制台创建 Direct2D1 窗口修改颜色
本文将告诉大家如何使用 Vortice 底层库从零开始,从一个控制台项目,开始搭建一个最简单的使用 Direct2D1 的 DirectX 应用.本文属于入门级博客,期望本文能让大家了解 Vortic ...
- 云数据库技术|“重磅升级”后再测 TDSQL-C
来源:云数据库技术 标题 1.摘要 前段时间,测试了国内主要云原生数据库 PolarDB.TDSQL-C.GaussDB 的性能,参考:<再测云原生数据库性能>.在上次测试结果中,由于地域 ...
- Spring笔记三
Spring-03 1. AOP 1.1 概念 AOP为Aspect Oriented Programming的缩写,意为:面向切面编程.他是一种可以在不修改原来的核心代码的情况下给程序动态统一进 ...
- DDD-领域驱动(三)-聚合与聚合根
概念 高内聚 , 高内聚合Aggregate 就好比一个功能,各个模块互相是有依赖关系存在,例如: 低耦合:模块可以任意替换,不会影响系统的工作 例如:比如你今天穿了这套衣服,明天穿了另一套衣服,但你 ...
- Lombok好用是好用,就是容易踩坑,这份避坑指南请查收
序言 各位好啊,我是会编程的蜗牛,作为java开发者,我们平常在开发过程中,总是希望能够尽量少敲代码.这一方面,当然是为了偷懒,另一方面,当然也是为了代码看起来更加简洁一点,不断往编程规范上靠.然后其 ...
- spring boot使用swagger生成api接口文档
前言 在之前的文章中,使用mybatis-plus生成了对应的包,在此基础上,我们针对项目的api接口,添加swagger配置和注解,生成swagger接口文档 具体可以查看本站spring boot ...
- 3.ElasticSearch系列之Docker本地部署
对于之前的部署方式一般用于生产环境,而对于学习而言Docker方式快速部署就好了,本示例在window10环境下进行. 1. Docker使用Elasticsearch 需要对vm.max_map_c ...