
Hadoop 单节点(或集群)基本配置信息
1. 默认配置文件: 存放于Hadoop对应的jar包中
core-default.xmlhdfs-default.xmlyarn-default.xmlmapred-default.xml
2. 自定义配置文件: $HADOOP_HOME/etc/hadoop
core-site.xmlhdfs-site.xmlyarn-site.xmlmapred-site.xml
2.1 core-site.xml
 <configuration>

      <property>

          <!-- 指定HDFS中NameNode的地址 -->

          <name>fs.defaultFS</name>

          <value>hdfs://localhost:9000</value>

      </property>

          <!-- 指定Hadoop运行时产生文件的存储目录,hadoop启动时,会自动创建 -->

          <property>

              <name>hadoop.tmp.dir</name>

              <value>/(自定义路径)/hadoop-2.8.5/data/tmp</value>

          </property>

  </configuration>
2.2 hadoop-env.sh
export JAVA_HOME=服务器java环境变量
2.3 hdfs-site.xml
 <configuration>

    <!-- nameNode 文件的副本数量 -->

     <property>

         <name>dfs.replication</name>

         <value>1</value>

     </property>

     <!-- nameNode 的访问地址-->

     <property>

         <name>dfs.namenode.rpc-bind-host</name>

         <value>0.0.0.0</value>

     </property>

 </configuration>
2.4 yarn-site.xml
<configuration>

     <!-- Reducer 获取数据的方式-->

     <property>

         <name>yarn.nodemanager.aux-services</name>

         <value>mapreduce_shuffle</value>

     </property>

     <property>

         <name>yarn.resourcemanager.hostname</name>

         <value>0.0.0.0</value>

     </property>

     <!-- 指定YARN 的 ResourceManager 的地址-->

     <property>

         <name>yarn.resourcemanager.webapp.address</name>

         <value>${yarn.resourcemanager.hostname}:8090</value>

     </property>

     <!-- 开启日志聚集功能 -->

     <property>

         <name>yarn.log-aggregation-enable</name>

         <value>true</value>

     </property>

     <!-- 日志保留7天 -->

     <property>

         <name>yarn.log-aggregation.retain-seconds</name>

         <value>604800</value>

      </property>

  </configuration>
2.5 yarn-env.sh 配置
export JAVA_HOME=服务器java环境变量
2.6 mapred-site.xml
 <configuration>

     <!-- 指定MR运行在YARN上 -->

     <property>

         <name>mapreduce.framework.name</name>

         <value>yarn</value>

     </property>

     <!-- 历史记录服务器端地址 -->

     <property>

         <name>mapreduce.jobhistory.address</name>

         <value>localhost:10020</value>

     </property>

     <!-- 历史服务器web端地址 -->

     <property>

         <name>mapreduce.jobhistory.webapp.address</name>

         <value>0.0.0.0:8091</value>

     </property>

 </configuration>
2.7 mapred-env.sh 配置
export JAVA_HOME=服务器java环境变量
3. Hadoop 集群配置
3.1 节点内容预览
| 节点1 | 节点2 | 节点3 | |
|---|---|---|---|
| HDFS | NameNode DataNode |
DataNode | SecondaryNameNode DataNode |
| YARN | NodeManager | ResourceManager NodeManager |
NodeManager |
3.2 core-site.xml 配置
<configuration>

      <property>

          <!-- 指定HDFS中NameNode的地址 -->

          <name>fs.defaultFS</name>

          <value>hdfs://节点1:9000</value>

      </property>

          <!-- 指定Hadoop运行时产生文件的存储目录,hadoop启动时,会自动创建 -->

          <property>

              <name>hadoop.tmp.dir</name>

              <value>/(自定义路径)/hadoop-2.8.5/data/tmp</value>

          </property>

  </configuration>
3.3 hadoop-env.sh 配置
export JAVA_HOME=服务器java环境变量
3.4 hdfs-site.xml 配置
<configuration>

    <!-- nameNode 文件的副本数量 -->

     <property>

         <name>dfs.replication</name>

         <value>3</value>

     </property>

     <!-- 指定 Hadoop 辅助名称节点主机配置(SecondaryNameNode) -->

     <property>

         <name>dfs.namenode.secondary.http-address</name>

         <value>节点3主机名称:端口号</value>

     </property>

 </configuration>
3.5 yarn-env.sh 配置
export JAVA_HOME=服务器java环境变量
3.6 yarn-site.xml 配置
<configuration>

     <!-- Reducer 获取数据的方式-->

     <property>

         <name>yarn.nodemanager.aux-services</name>

         <value>mapreduce_shuffle</value>

     </property>

     <property>

         <name>yarn.resourcemanager.hostname</name>

         <value>节点2</value>

     </property>

     <!-- 指定YARN 的 ResourceManager 的地址-->

     <property>

         <name>yarn.resourcemanager.webapp.address</name>

         <value>${yarn.resourcemanager.hostname}:8090</value>

     </property>

     <!-- 开启日志聚集功能 -->

     <property>

         <name>yarn.log-aggregation-enable</name>

         <value>true</value>

     </property>

     <!-- 日志保留7天 -->

     <property>

         <name>yarn.log-aggregation.retain-seconds</name>

         <value>604800</value>

      </property>

  </configuration>
3.7 mapred-env.sh 配置
export JAVA_HOME=服务器java环境变量
3.8 mapred-site.xml 配置
 <configuration>

     <!-- 指定MR运行在YARN上 -->

     <property>

         <name>mapreduce.framework.name</name>

         <value>yarn</value>

     </property>

 </configuration>
3.9 slaves 配置
节点1

节点2

节点3
4. 常用命令
bin/hdfs namenode -format: 格式化命令;执行命令前,需要将单节点(或集群)中的/data,/logs目录删除。bin/hdfs dfs -put 待上传文件 上传的目的地:将本地文件上传至hdfs中。sbin/hadoop-daemon.sh start(stop) namenode: 启动(或停止)单节点NameNode。sbin/hadoop-daemon.sh start(stop) datanode: 启动(或停止)单节点DataNode。sbin/yarn-daemon.sh start(stop) resourcemanager: 启动(或停止)单节点ResourceManager。sbin/yarn-daemon.sh start(stop) nodemanager: 启动(或停止)单节点NodeManager。sbin/mr-jobhistory-daemon.sh start(stop) historyserver: 启动(或停止)单节点History记录。sbin/start-dfs.sh: 启动HDFS集群(注意:所有节点均已配置"Hadoop目录/etc/hadoop/slaves")。sbin/start-yarn.sh: 启动YARN集群(注意:所有节点均已配置"Hadoop目录/etc/hadoop/slaves"; 另外,需要在ResourceManager服务器启动)。sbin/stop-dfs.sh: 停止HDFS集群。sbin/stop-yarn.sh: 停止YARN集群。
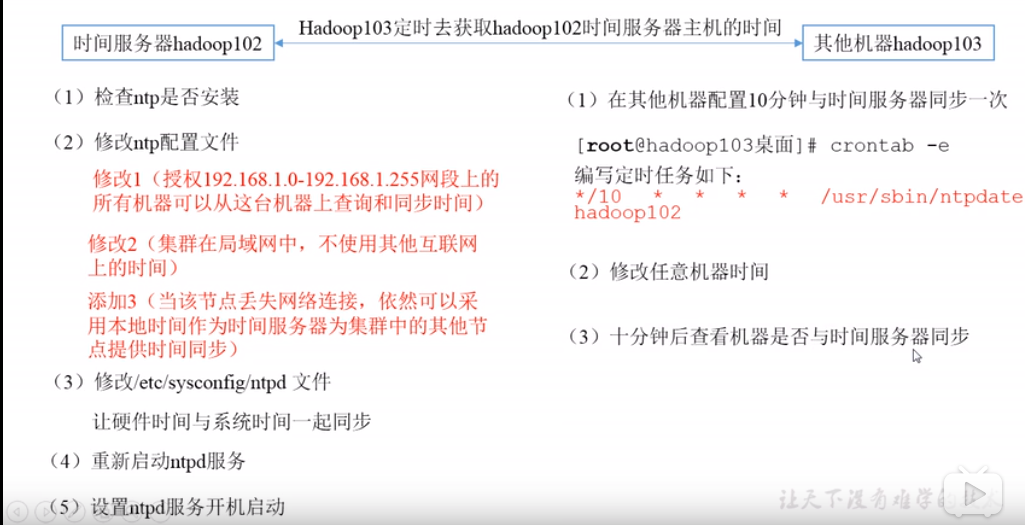
5. 集群时间同步
- 时间同步的方式:找一个机器, 作为时间服务器,所有机器与这台集群时间进行定时的同步;
- 检查
ntp是否安装rpm -qa|grep ntp; - 修改
ntp配置文件/etc/ntp.conf; - 修改
/etc/sysconfig/ntpd文件;- 让硬件时间与系统时间一起同步;
- 重启
ntpd服务; - 设置
ntpd服务开机启动;
- 检查
**参考资料:**
- [设置集群时间同步](https://www.bilibili.com/video/av32081351/?p=44)
- [rpm命令](http://man.linuxde.net/rpm)
Hadoop 单节点(或集群)基本配置信息的更多相关文章
- 使用Minikube运行一个本地单节点Kubernetes集群(阿里云)
使用Minikube运行一个本地单节点Kubernetes集群中使用谷歌官方镜像由于某些原因导致镜像拉取失败以及很多人并没有代理无法开展相关实验. 因此本文使用阿里云提供的修改版Minikube创建一 ...
- Hadoop 2.6.1 集群安装配置教程
集群环境: 192.168.56.10 master 192.168.56.11 slave1 192.168.56.12 slave2 下载安装包/拷贝安装包 # 存放路径: cd /usr/loc ...
- Kafka单节点及集群配置安装
一.单节点 1.上传Kafka安装包到Linux系统[当前为Centos7]. 2.解压,配置conf/server.property. 2.1配置broker.id 2.2配置log.dirs 2. ...
- K8s二进制部署单节点 etcd集群,flannel网络配置 ——锥刺股
K8s 二进制部署单节点 master --锥刺股 k8s集群搭建: etcd集群 flannel网络插件 搭建master组件 搭建node组件 1.部署etcd集群 2.Flannel 网络 ...
- Hadoop安装教程_集群/分布式配置
配置集群/分布式环境 集群/分布式模式需要修改 /usr/local/hadoop/etc/hadoop 中的5个配置文件,更多设置项可点击查看官方说明,这里仅设置了正常启动所必须的设置项: slav ...
- 1.如何在虚拟机ubuntu上安装hadoop多节点分布式集群
要想深入的学习hadoop数据分析技术,首要的任务是必须要将hadoop集群环境搭建起来,可以将hadoop简化地想象成一个小软件,通过在各个物理节点上安装这个小软件,然后将其运行起来,就是一个had ...
- ActiveMQ的单节点和集群部署
平安寿险消息队列用的是ActiveMQ. 单节点部署: 下载解压后,直接cd到bin目录,用activemq start命令就可启动activemq服务端了. ActiveMQ默认采用61616端口提 ...
- 使用Minikube运行一个本地单节点Kubernetes集群
使用Minikube是运行Kubernetes集群最简单.最快捷的途径,Minikube是一个构建单节点集群的工具,对于测试Kubernetes和本地开发应用都非常有用. ⒈安装Minikube Mi ...
- CentOS系统下Hadoop 2.4.1集群安装配置(简易版)
安装配置 1.软件下载 JDK下载:jdk-7u65-linux-i586.tar.gz http://www.oracle.com/technetwork/java/javase/downloads ...
- Hadoop 2.5.1集群安装配置
本文的安装只涉及了hadoop-common.hadoop-hdfs.hadoop-mapreduce和hadoop-yarn,并不包含HBase.Hive和Pig等. http://blog.csd ...
随机推荐
- 008_STM32之_keil编译内存大小解析
Program Size: Code=28784 RO-data=6480 RW-data=60 ZI-data=3900 的含义 1. Code: 程序所占用的FLASH大小,存储在FLASH. ...
- wait系列
转自 http://blog.csdn.net/todd911/article/details/15028511 1.wait函数和waitpid函数 当一个进程正常或异常终止时,内核就向其父进程发送 ...
- C语言学习笔记2-程序基础和变量
本系列文章由jadeshu编写,转载请注明出处.http://blog.csdn.net/jadeshu/article/details/50751977 作者:jadeshu 邮箱: jades ...
- GEOS库的编译
下载地址https://trac.osgeo.org/geos/ 选择最新的geos-3.6.2版本,下载 将geos-3.6.2放在VS2012文件夹下,本例是D:\VS2012 打开VS2012开 ...
- 谷歌浏览器试调网页 多出font标签
突然发现一些按钮的点击功能失效,在控制台发现该a标签中多出个font标签,导致文字区域不能触发到a标签 就算a标签宽高设置百分百 也没用. 经测试不同的浏览器情况不一样 safari就不会出现这种情况 ...
- elasticsearch _create api创建一个不存在的文档
https://www.elastic.co/guide/cn/elasticsearch/guide/current/create-doc.html当我们索引一个文档, 怎么确认我们正在创建一个完全 ...
- JavaScript作用域与闭包总结
1.全局作用域 所有浏览器都支持 window 对象,它表示浏览器窗口,JavaScript 全局对象.函数以及变量均自动成为 window 对象的成员.所以,全局变量是 window 对象的属性,全 ...
- ubantu 安装boost库 c++connector
安装libmysqlcppconn: sudo apt-get install libmysqlcppconn-dev 安装libboost: sudo apt-get install libboos ...
- 如何配置WAMP环境(主要是Apache与PHP)
1.配置Apache 1.编辑Apache配置文件---http.conf(位于安装目录下的conf子目录内): 2.修改Document Root 和 Directory选项,这是修改Apache的 ...
- 前端知识点回顾——mongodb和mongoose模块
mongodb和mongoose模块 数据库 数据库有关系型数据库(MySQL)和非关系型数据库(mongodb),两者的语法和数据存储形式不一样. mySQL 关系型数据库 类似于表格的形式,每一条 ...