
shelve:极其强大的序列化模块
介绍
数据序列化、或持久化,就是把数据从内存刷到磁盘上。但是要保证在读取的时候还能恢复到原来的状态。像pickle和json之类的持久化模块基本上无需介绍了,这里介绍两个其他很少用但是功能很强大的模块。
dbm
'''

在一些小型程序中,不需要关系型数据库时,可以方便的用持久字典来存储键值对,和python中的字典非常类似。而且dbm的键和值都必须是str或者bytes类型

'''

import dbm

'''

这里第一个参数直接传入文件名,第二个参数表示模式

常见的模式:

r:可读,默认就是这个模式

w:可读可写

但是r、w,都必须确保文件已经存在,否则报错。

c:可读可写,文件不存在时会创建

n:可读可写,但总是会创建一个新的文件,也就是说如果创建同名文件,那么之前的内容都会被清空,也就是起不到追加的效果。

因此我们平常的模式一般都会选择c

第三个参数是权限,这个在windows下基本不用,是一组用八进制表示的数字,默认是0o666,都是可读可写不可执行

'''

db = dbm.open("store", "c")

# 打开文件之后,就可以存储值了

# 注意key和value都必须是str或者bytes类型

db["name"] = "satori"

db["age"] = "16"

db["gender"] = "f"

db["anime"] = "东方地灵殿"

# 关闭文件,将内容写到磁盘上

db.close()

################################################################

# 打开文件

db = dbm.open("store", "c")

print(db.keys())  # [b'name', b'age', b'gender', b'anime']

for key in db.keys():

    print(f"key={key}, value={db[key]}")

    '''

    key=b'name', value=b'satori'

    key=b'age', value=b'16'

    key=b'gender', value=b'f'

    key=b'anime', value=b'\xe4\xb8\x9c\xe6\x96\xb9\xe5\x9c\xb0\xe7\x81\xb5\xe6\xae\xbf'

    '''
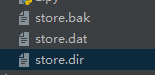
会多出来这三个文件
shelve
'''

shelve和dbm比较类似,但是功能远比dbm强大,因为它可以持久化任意对象

'''

import shelve

# 参数flag默认是c,因此我们只需要传入文件名就可以了,这个是自动追加在后面的

# 也就是说我写完之后,再次打开继续写的话,只会追加不会清空

sh = shelve.open("shelve")

sh["dict"] = {"name": "satori", "age": 16}

sh["list"] = [1, 2, 3, 4]

sh["set"] = {1, 2, 3, 2}

# 写完之后关闭文件,刷到内存里面

# 关闭之后就无法操作了

sh.close()

# 下面我们就可以操作数据了,下面的代码即便写在另一个py文件里面也是可以的

sh2 = shelve.open("shelve")

print(sh2["dict"], sh2["dict"].keys())  # {'name': 'satori', 'age': 16} dict_keys(['name', 'age'])

print(sh2["list"], sum(sh2["list"]))  # [1, 2, 3, 4] 10

print(sh2["set"])  # {1, 2, 3}

sh2.close()

# 可以看到,拿出来的就是原生的对象,可以直接用来进行操作的。那我们看看自己定义的类可不可以呢?

sh3 = shelve.open("shelve")

class A:

    def __init__(self, name, age):

        self.name = name

        self.age = age

    @property

    def print_info(self):

        return f"my name is {self.name}, age is {self.age}"

a = A("satori", 16)

# 将这个类和类的一个实例对象存储进去

sh3["A"] = A

sh3["a"] = a

sh3.close()

######################################

sh4 = shelve.open("shelve")

# sh4["A"]拿到A这个类,传入参数,调用方法

print(sh4["A"]("mashiro", "17").print_info)  # my name is mashiro, age is 17

# sh4["a"]拿到a这个实例对象,直接调用方法

print(sh4["a"].print_info)  # my name is satori, age is 16

# 我们发现依旧是可以的,说明了shelve这个模块真的很强大
# 我们再来看一个例子

import shelve

sh = shelve.open("shelve")

sh["list"] = [1, 2, 3]

sh["str"] = "mashiro"

sh.close()

##############################

sh = shelve.open("shelve")

sh["list"].append("xxxx")

sh["str"] = "satori"

sh.close()

#######################

sh = shelve.open("shelve")

print(sh["list"])  # [1, 2, 3]

print(sh["str"])  # satori

'''

分析结果,第一次打开文件我们创建两个键值对

sh["list"] = [1, 2, 3]

sh["str"] = "mashiro"

第二次打开文件,修改了两个键的值

第三次打开文件,打印。但是我们发现sh["str"]改变了,但是sh["list"]没有改变,这是为什么?

首先sh["str"] = "satori"很好理解,但是为什么sh["list"]没有变?

因为=,我们是直接赋值,将这一块内存里面的值给换掉,而sh["list"]我们是做append操作,这只是在原来的基础上进行修改

shelve默认情况下是不会记录,持久化对象的修改的,除非你是创建新的对象,或者是把原来的对象给换掉

如果是在原来的基础上(可变类型),比如列表、字典,进行添加或者删除操作,这些是不会被记录的

所以:sh["list"]=[1, 2, 3]  sh["list"].append("xxxx")  --->sh["list"]仍是[1, 2, 3]不会是[1, 2, 3, "xxx"]

因为shelve没有记录对象自身的修改,如果我想得到期望的结果,一种方法是把对象整体换掉

sh["list"] = [1, 2, 3, "xxxx"],这样等于是重新赋值,是可行的。但是有时候我们不知道列表里面内容,或者列表里面的内容是一些函数、类什么的、不好写的话,该咋办呢?

其实我们在打开文件的时候,还可以加上一个参数,叫做writeback

'''
import shelve

sh = shelve.open("shelve")

sh["list"] = [1, 2, 3]

sh["str"] = "mashiro"

sh.close()

##############################

# 如果我们需要进行修改,那么加上一个writeback=True就可以了,从名字也能看出来

# 这是会将修改的内容从新写回去

sh = shelve.open("shelve", writeback=True)

sh["list"].append("xxxx")

sh["str"] = "satori"

sh.close()

#######################

sh = shelve.open("shelve")

print(sh["list"])  # [1, 2, 3, 'xxxx']

print(sh["str"])  # satori

'''

可以看到都发生改变了,但是这个参数有缺陷,就是会有额外的内存消耗。当我们加上writeback=True的时候shelve会将我们读取的对象都放到一个内存缓存当中。

比如说我们获取了20持久化的对象,但是我们只修改了一个,剩余的19个只是查看并没有做修改,但当我们sh.close()的时候,会将这20个对象都写回去

因为shelve不知道你会对哪个对象进行修改,于是不管你是查看还是修改,都会放到缓存当中,然后再一次性都写回去。

这样会造成两点:

1.对象放到内存缓存当中,等于是重新拷贝了一份,因为我们读取文件已经到内存当中了,而shelve又把我们使用的对象放当内存的另一片空间中

2.写入数据,我们明明只修改了一份数据,但是它把20份都重新写回去了,这样会造成性能上的问题,导致效率会降低。

因此加不加这个参数,由具体情况决定

'''
同样也会多出来三个文件
shelve:极其强大的序列化模块的更多相关文章
- python 全栈开发,Day25(复习,序列化模块json,pickle,shelve,hashlib模块)
一.复习 反射 必须会 必须能看懂 必须知道在哪儿用 hasattr getattr setattr delattr内置方法 必须能看懂 能用尽量用__len__ len(obj)的结果依赖于obj. ...
- 0420模块 序列化模块 hashlib模块
复习:内置方法 __len__ len(obj)的结果依赖于obj.__len__()的结果,计算对象的长度__hash__ hash(obj)的结果依赖于obj.__hash__()的结果,计算对象 ...
- python开发模块基础:序列化模块json,pickle,shelve
一,为什么要序列化 # 将原本的字典.列表等内容转换成一个字符串的过程就叫做序列化'''比如,我们在python代码中计算的一个数据需要给另外一段程序使用,那我们怎么给?现在我们能想到的方法就是存在文 ...
- python序列化模块 json&&pickle&&shelve
#序列化模块 #what #什么叫序列化--将原本的字典.列表等内容转换成一个字符串的过程叫做序列化. #why #序列化的目的 ##1.以某种存储形式使自定义对象持久化 ##2.将对象从一个地方传递 ...
- 序列化模块— json模块,pickle模块,shelve模块
json模块 pickle模块 shelve模块 序列化——将原本的字典.列表等内容转换成一个字符串的过程就叫做序列化. # 序列化模块 # 数据类型转化成字符串的过程就是序列化 # 为了方便存储和网 ...
- 20,序列化模块 json,pickle,shelve
序列化模块 什么叫序列化? 将原本的字典,列表等内容转换成一个字符串的过程叫做序列化. 序列化的目的? 数据结构 通过序列化 转成 str. str 通过反序列化 转化成数据结构. json: jso ...
- Python 序列化模块(json,pickle,shelve)
json模块 JSON (JavaScript Object Notation):是一个轻量级的数据交换格式模块,受javascript对象文本语法启发,但不属于JavaScript的子集. 常用方法 ...
- json等序列化模块 异常处理
今日学习内容如下: 1.序列化模块 什么叫序列化——将原本的字典.列表等内容转换成一个字符串的过程就叫做序列化. 比如,我们在python代码中计算的一个数据需要给另外一段程序使用,那我们怎么给? 现 ...
- 序列化模块和sys模块
sys模块 sys模块是与python解释器交互的一个接口 sys.argv 命令行参数List,第一个元素是程序本身路径 sys.exit(n) 退出程序,正常退出时exit(0),错误退出sys. ...
随机推荐
- image-webpack-loader在mac或ubuntu报错
解决办法安装libpng库,在github issue https://github.com/tcoopman/image-webpack-loader/issues/49可查看 mac: brew ...
- 【Linux】常用基础命令
修改时间 date -s 月/日/年 例如:date -s 07/31/2019 date -s 时:分:秒 例如:date -s 23:56:50 hwclock -w 将时间写到bois,防止重启 ...
- B/S结构-登录页面-测试用例设计
页面描述: 有一个登陆页面, 假如上面有2个textbox, 一个提交按钮 测试需求: 请针对这个页面设计30个以上的testcase 功能测试(Function test) 0. 什么都不输入,点击 ...
- Android开发 移动端适配
1 UI自适应(UGUI) UI自适应又分为锚点自适应和缩放.锚点主要控制UI控件在父控件之中的位置,同时也能影响缩放. 锚点自适应缩放: 我们使用UGUI创建一个界面,设计使用1920x1080分辨 ...
- amh 操作
挂在分区到/home 迁移数据库/usr/local/mysql/data 到/home/data目录 504 卡死 进入kangle后台,选扩展,再选中扩展里的命令选项,修改PHP-NTS的协议为f ...
- 关于js查找和筛选和循环的几种方式
find(); find() 方法返回通过测试(函数内判断)的数组的第一个元素的值. find() 方法为数组中的每个元素都调用一次函数执行: 当数组中的元素在测试条件时返回 true 时, find ...
- [转帖]国产CPU性能最全盘点 宜良性竞争优胜劣汰
国产CPU性能最全盘点 宜良性竞争优胜劣汰 电子工程专辑的网站内容 其实里面说的不尽全面 比如龙芯和申威就放到一块了 一个是 MIPS 一个是Alpha 明显不一样的东西 x86的应该都不行 而且. ...
- 从零开始,SpreadJS 新人学习笔记(第二周)
Hello,大家好,我是Fiona.经过上周的学习,我已经初步了解了SpreadJS的目录结构,以及如何创建Spread项目到我的工程目录中.>>还不知如何开始学习SpreadJS的同学, ...
- 创建Maven Web项目时很慢解决办法
点击加号,Name输入archetypeCatalog,Value输入internal archetypeCatalog表示插件使用的archetype元数据,不加这个参数时默认为remote,loc ...
- 第一次把mysql装进docker里碰到的各种问题
最近电脑经常关机要关好长时间,老是需要长按电源键强行关机.也不知道是怎么回事. 后来查看关机时的日志,发现是mysql停不掉.这可闹心了!怎么办?上网搜了搜也没有找到什么好的解决办法.总不能每次关机都 ...