
【转载】Hadoop mapreduce 实现原理
1. 如何用通俗的方法解释MapReduce
MapReduce是Google开源的三大技术之一,是对海量数据进行“分而治之”计算框架。为了简单的理解并讲述给客户理解。我们举下面的例子来说明.
首先,面对一堆杂乱的东西,有若干个汉堡、若干个冰淇淋、若干个可乐。如果级别都是上万数量的情况下,有没有方法把他们较快的分析出来?
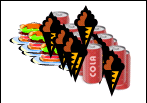
第一步,调度员简单的将这一堆东西分解成若干堆。

第二步,调度员为每堆物品分配一个分拣员,注意只分拣不计数,分拣员对应MAPReduce中的Map角色。分拣员干的事情,就是将物品按类别分拣,比如分拣后的每一堆的状态应该是如下图所示。分拣员所做的也分成简单,从自己面前这一堆物品中拿一个,看是面包的话,就扔面包那。是可乐就扔可乐那。

第三步,调度员为每类物品分配一个计数员(Reducer),把所有该类型的物品都发给他计数。比如所有的面包类别都分给第一个计数员来负责计数。计数员统计出每个类别的数目,再告诉调度员。

总结:Mapper用来分类,Reduce则用来对同类型的东西做进一步处理。对于互联网的应用场景,比如分析一个网页中出现的词汇最多的单词是什么。Mapper用来将网页中的文字段落分解成一个个单词。相同的单词会被送给同一个Reducer。Reducer会计算出该单词出现了多少次。最后按照各单词出现的次数得出结论。
2. 一个文本文件的处理过程
1)对应这样一个源文本文件

2)首先由调度员通过job.setInputFormatClass(TextInputFormat.class),知道应该转换成偏移量加文本方式的键-值对;再根据当前机器个数,文件大小确定应该分解成几个待处理的片段,比如说分解成两个片段,对应两个Map程序。
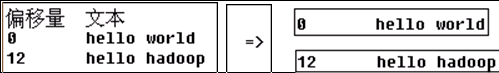
3)第一个Map程序每次被调用,接受到的入参(key,value)是
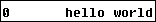
Map程序的输出是

4)第二个Map程序接受的输入将是

第二个Map的输出将是

5)Map程序的输出,会被重新组合,同一个Key的内容,会被分配到同一个Reduce上。
比如上面三个单词,会被分到三个Reducer上
6)第一个Reducer接收到,如下图,注意是两个1,来自两个Map的结果

第一个Reducer的输出会是如下图,意味着hello这个单词出现了两次

7)第二个Reducer接收到

第二个Reducer输出会是

8)第三个Reducer接收到

第三个Reducer输出是

9)最后将三个Reducer进行合并,得到的结果就是

10)汇总流程描述如图所示
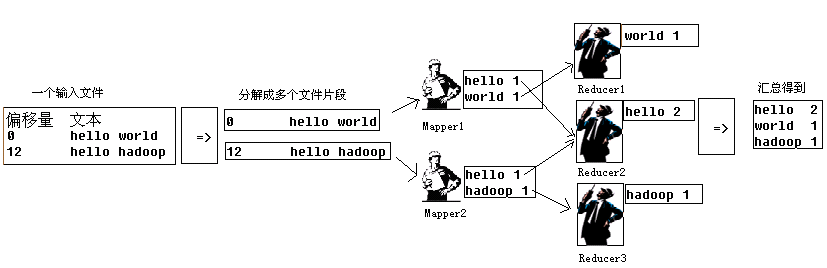
转载自
Hadoop的MapReduce实现原理解释
如侵删
【转载】Hadoop mapreduce 实现原理的更多相关文章
- [转载] Hadoop MapReduce
转载自http://blog.csdn.net/yfkiss/article/details/6387613和http://blog.csdn.net/yfkiss/article/details/6 ...
- Hadoop MapReduce工作原理
在学习Hadoop,慢慢的从使用到原理,逐层的深入吧 第一部分:MapReduce工作原理 MapReduce 角色 •Client :作业提交发起者. •JobTracker: 初始化作业,分配 ...
- 一图看懂hadoop MapReduce工作原理
MapReduce执行流程及单词统计WordCount示例
- [转载] MapReduce工作原理讲解
转载自http://www.aboutyun.com/thread-6723-1-1.html 有时候我们在用,但是却不知道为什么.就像苹果砸到我们头上,这或许已经是很自然的事情了,但是牛顿却发现了地 ...
- Hadoop化繁为简(三)—探索Mapreduce简要原理与实践
目录-探索mapreduce 1.Mapreduce的模型简介与特性?Yarn的作用? 2.mapreduce的工作原理是怎样的? 3.配置Yarn与Mapreduce.演示Mapreduce例子程序 ...
- 王家林的“云计算分布式大数据Hadoop实战高手之路---从零开始”的第十一讲Hadoop图文训练课程:MapReduce的原理机制和流程图剖析
这一讲我们主要剖析MapReduce的原理机制和流程. “云计算分布式大数据Hadoop实战高手之路”之完整发布目录 云计算分布式大数据实战技术Hadoop交流群:312494188,每天都会在群中发 ...
- Hadoop MapReduce 二次排序原理及其应用
关于二次排序主要涉及到这么几个东西: 在0.20.0 以前使用的是 setPartitionerClass setOutputkeyComparatorClass setOutputValueGrou ...
- Hadoop 4、Hadoop MapReduce的工作原理
一.MapReduce的概念 MapReduce是hadoop的核心组件之一,hadoop要分布式包括两部分,一是分布式文件系统hdfs,一部是分布式计算框就是mapreduce,两者缺一不可,也就是 ...
- 一起学Hadoop——MapReduce原理
一致性Hash算法. Hash算法是为了保证数据均匀的分布,例如有3个桶,分别是0号桶,1号桶和2号桶:现在有12个球,怎么样才能让12个球平均分布到3个桶中呢?使用Hash算法的做法是,将1 ...
随机推荐
- 【BZOJ1876】[SDOI2009]SuperGCD(数论,高精度)
[BZOJ1876][SDOI2009]SuperGCD(数论,高精度) 题面 BZOJ 洛谷 题解 那些说数论只会\(gcd\)的人呢?我现在连\(gcd\)都不会,谁来教教我啊? 显然\(gcd\ ...
- BZOJ 4785 [Zjoi2017]树状数组 | 二维线段树
题目链接 BZOJ 4785 题解 这道题真是令人头秃 = = 可以看出题面中的九条可怜把求前缀和写成了求后缀和,然后他求的区间和却仍然是sum[r] ^ sum[l - 1],实际上求的是闭区间[l ...
- luogu2577/bzoj1899 午餐 (贪心+dp)
首先,应该尽量让吃饭慢的排在前面,先按这个排个序 然后再来决定每个人到底去哪边 设f[i][j]是做到了第i个人,然后1号窗口目前的总排队时间是j,目前的最大总时间 有这个i和j的话,再预处理出前i个 ...
- oracle 按 123456789 排序 而不是 1 10 11 2 这种
order by decode(trim(translate(cptm,'0123456789',' ')),null,to_number(cptm))
- linux driver ------ platform模型,通过杂项设备(主设备号是10)注册设备节点
注册完设备和驱动之后,就需要注册设备节点 Linux杂项设备出现的意义在于:有很多简单的外围字符设备,它们功能相对简单,一个设备占用一个主设备号对于内核资源来说太浪费.所以对于这些简单的字符设备它们共 ...
- java.sql.SQLSyntaxErrorException: ORA-00911: 无效字符
java.sql.SQLSyntaxErrorException: ORA-: 无效字符 at oracle.jdbc.driver.T4CTTIoer.processError(T4CTTIoer. ...
- js(=>) 箭头函数 详细解说 案例大全
ES6标准新增了一种新的函数:Arrow Function(箭头函数). 为什么叫Arrow Function?因为它的定义用的就是一个箭头: x => x * x 上面的箭头函数相当于: fu ...
- Goslate: Free Google Translate API
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6E ...
- 用Shell编写的俄罗斯方块代码
用Shell编写的俄罗斯方块代码 不得不承认任何一门语言玩6了,啥都能搞出来啊,竟然用Shell编写出来了一个俄罗斯方块游戏的代码,很有意思,这个代码不是我写出来的,不过大家可以下载一下在window ...
- free命令常用参数详解
free命令常用参数详解 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 在运维期间我们会经常去查看服务器硬件信息,比如说内存,大家可能知道看内存用“[root@yinzhengji ...