
Python爬虫基础之认识爬虫
一、前言
爬虫Spider什么的,老早就听别人说过,感觉挺高大上的东西,爬网页,爬链接~~~dos黑屏的数据刷刷刷不断地往上冒,看着就爽,漂亮的校花照片,音乐网站的歌曲,笑话、段子应有尽有,全部都过来~~~
前段时间在学习Python打基础,一周时间过去了,是时候要开始写点东西了,Python爬虫刚好可验证下这段时间的学习成果,写写博文记录下自己学习爬虫的经过和遇到的坑,希望对同样是小白的园友有帮助!!!
我用的Python 3.5版本,2.7版本用的人也挺多的。
那么,接下来,我们要搞清楚几个问题:爬虫是什么东西?爬虫可以用来做什么?开发爬虫前需要掌握什么?
二、爬虫是什么东西
百度百科这么定义爬虫:

这里有几个关键词"规则","自动","万维网","程序"或者"脚本",理解了这几个关键词估计对爬虫就有个大体上的认识了。
接下来,会对这几个关键词就行解释.
三、爬虫从哪里爬取数据
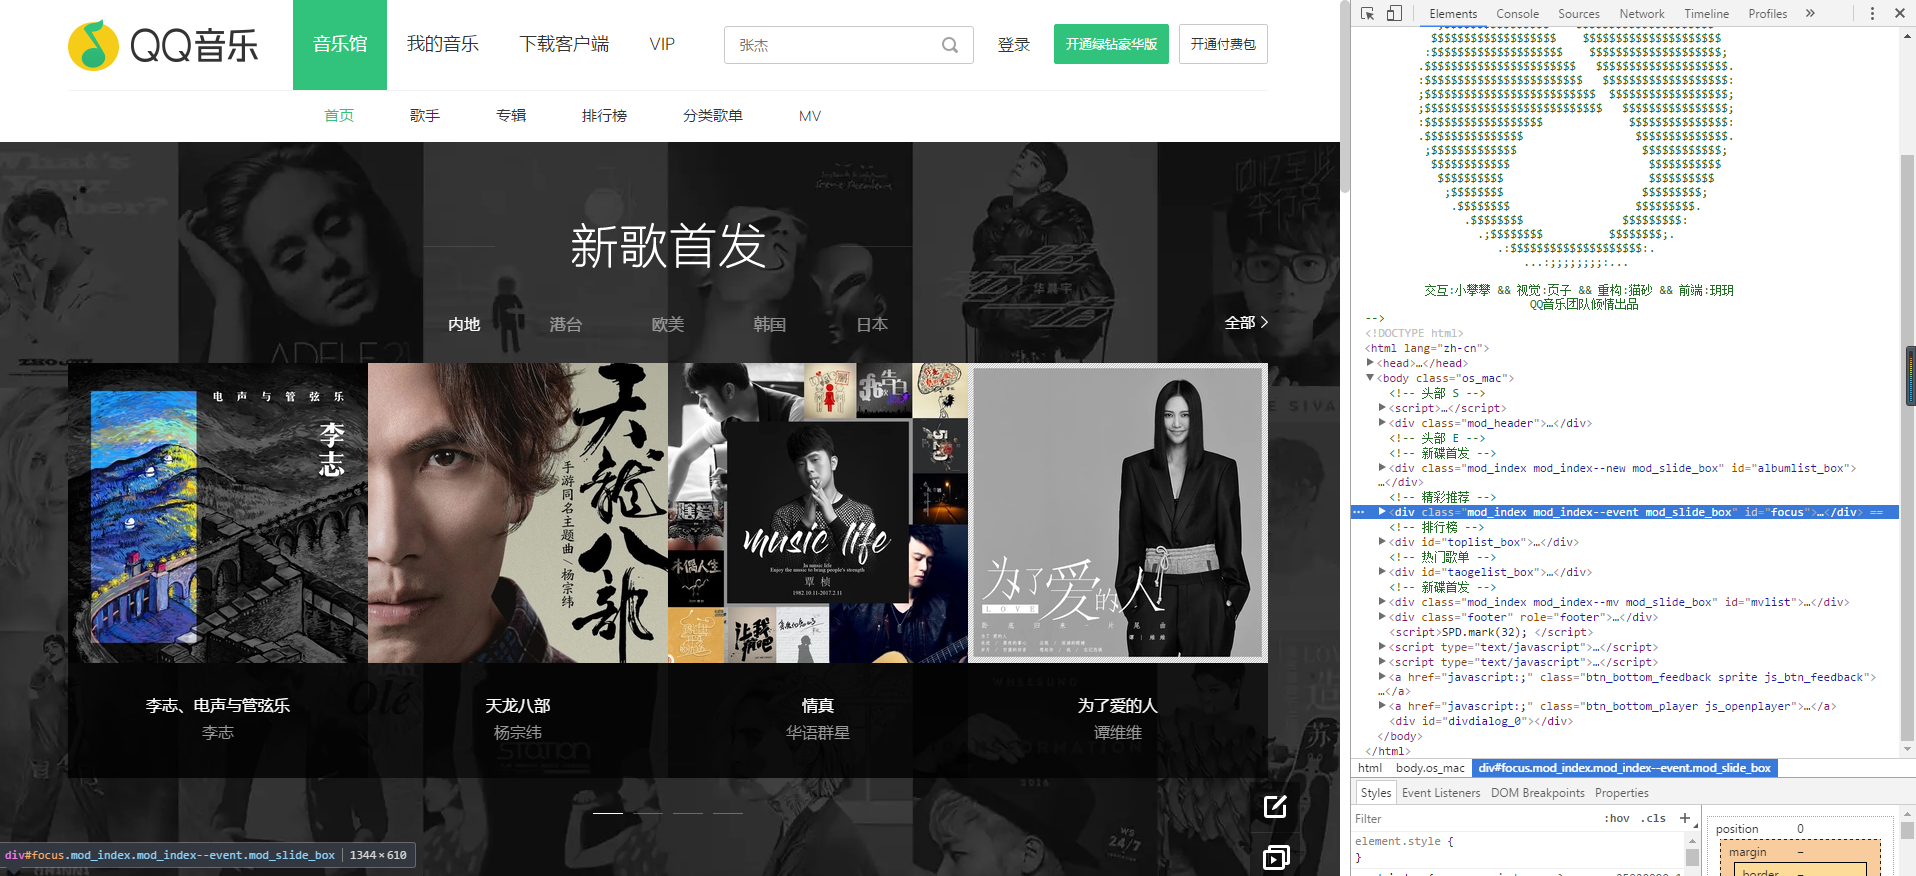
浏览器输入QQ音乐首页的网址:https://y.qq.com/,展现在我们面前的是浏览器解析器后的样子,敲击F12后,我们可以看到网页的源码,都是由一些html标签(标签我们这里用"节点"表示吧)构成。
所有网页的源码结构主要长的是这个样子:
<html>
<head>
<title>title name</title>
</head>
<body>
page content
</body>
</html>
关键词"万维网"?最简单的理解,万维网就是千千万万台电脑相互连接形成的像蜘蛛网一样的东西,我们的爬虫就是在这张网上干活,从网页上爬取信息。
关键词"规则"?这就是爬虫需要遵守的规则,<html>节点是<head>和<body>的父节点,<head>和<body>是子节点, 父节点包含子节点,子节点相邻的节点是兄弟节点,<title>是<html>的子孙节点,
这就构成了HTML DOM(文档对象模型),简单地说,爬虫就是爬取这些节点的内容,例如图片,文本等。。
关键词"自动"和"程序"或者"脚本"?可以理解成非人工的方式,也就是编写代码的方式,通过程序或者一段脚本(我们这里用Python脚本),自动按着我们预设的意愿工作,爬取我们认为有价值的信息,满足我们对信息的需求。
四、我的爬虫知识储备
HTML + CSS + Javascript
掌握一些HTML静态网页的知识,CSS样式,ID,标签,类选择器,还有Javascript如何定位和操作页面上的元素,w3school的教程,有教程和实例,还可以用来调试代码脚本,新手入门和知识查阅十分方便。网页解析方面,后面我们会用到正则表达式、BeautifulSoup和Lxml三种方式。
HTTP协议
具备一些网络方面的知识,了解浏览器和服务器之间的交互,如何发送http请求和处理请求结果。网页请求和下载网页,后面我们会用到Python的库urllib
Python
我们的脚本语言,这个自然不用说,必须掌握,入门推荐 runoob.com,Python基础 和 Python 3
掌握了以上知识,我们就可以开始实战了!!!
Python爬虫基础之认识爬虫的更多相关文章
- python爬虫基础16-cookie在爬虫中的应用
Cookie的Python爬虫应用 Cookie是什么 Cookie,有时也用其复数形式 Cookies,英文是饼干的意思.指某些网站为了辨别用户身份.进行 session 跟踪而储存在用户本地终端上 ...
- Python开发基础-Day15正则表达式爬虫应用,configparser模块和subprocess模块
正则表达式爬虫应用(校花网) import requests import re import json #定义函数返回网页的字符串信息 def getPage_str(url): page_stri ...
- python基础整理6——爬虫基础知识点
爬虫基础 什么是爬虫: 网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用的名字还有蚂蚁. ...
- Python爬虫基础
前言 Python非常适合用来开发网页爬虫,理由如下: 1.抓取网页本身的接口 相比与其他静态编程语言,如java,c#,c++,python抓取网页文档的接口更简洁:相比其他动态脚本语言,如perl ...
- Python爬虫入门:爬虫基础了解
有粉丝私信我想让我出更基础一些的,我就把之前平台的copy下来了,可以粗略看一下,之后都会慢慢出. 1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫 ...
- python 3.x 爬虫基础---Urllib详解
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 前言 爬虫也了解了一段时间了希望在半个月的时间内 ...
- python 3.x 爬虫基础---常用第三方库(requests,BeautifulSoup4,selenium,lxml )
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 python 3.x 爬虫基础---常用第三方库 ...
- python从爬虫基础到爬取网络小说实例
一.爬虫基础 1.1 requests类 1.1.1 request的7个方法 requests.request() 实例化一个对象,拥有以下方法 requests.get(url, *args) r ...
- python爬虫-基础入门-python爬虫突破封锁
python爬虫-基础入门-python爬虫突破封锁 >> 相关概念 >> request概念:是从客户端向服务器发出请求,包括用户提交的信息及客户端的一些信息.客户端可通过H ...
随机推荐
- 基于Metronic的Bootstrap开发框架--工作流模块功能介绍
在很早之前的随笔里面,已经介绍了WInform框架中工作流模块的功能,不过由于工作流模块中界面处理部分比较麻烦,一直没有在Bootstrap框架中进行集成,最近由于项目的关系,花了不少精力,把工作流模 ...
- 随心测试_软测基础_002_<测试工程师_核心技能体系>
测试工程师核心技能体系构成 测试基础体系:[对象——>方法——>流程].[测试活动类型——>质量] 测试分析体系:[测试对象分析]——>[测试设计(计划.数据.用例.文档)] ...
- 蒟蒻浅谈树链剖分之一——两个dfs操作
树链剖分,顾名思义就是将树形的结构剖分成链,我们以此便于在链上操作 首先我们需要明白在树链剖分中的一些概念 重儿子:某节点所有儿子中子树最多的儿子 重链:有重儿子构成的链 dfs序:按重儿子优先遍历时 ...
- Feature Pyramid Networks for Object Detection比较FPN、UNet、Conv-Deconv
https://vitalab.github.io/deep-learning/2017/04/04/feature-pyramid-network.html Feature Pyramid Netw ...
- Djangon
2.怎么样从浏览器获得用户输入的数据? request.浏览器的八种申请方式.get(条件) request.浏览器的八种申请方式[] request.浏览器的八种申请方式(这里什么也不要写)> ...
- js变速动画函数封装 回调函数及层级还有透明度
//点击按钮,改变宽度到达一个目标值,高度到达一个目标值 //获取任意一个元素的任意一个属性的当前的值---当前属性的位置值 function getStyle(element, attr) { re ...
- Bugku 分析 中国菜刀
解压之后得到了一个流量包,只有不到10KB,美滋滋 先抓重点,过滤出http,只有6条数据记录,3条post,3条response,3条post都是一样的 随便打开一条pos 是一个assert断言, ...
- license.json
{"license":{"uid":"5359f3d1-8c8c-462b-a17b-b7eb0c3ddb8f","type&qu ...
- Vue(二)简单入门
根据上一节搭建的hello-world工程(包含Router),用Webstorm打开,我们先运行一下工程. 界面如下 .. 我将在About里面介绍一下Vue的相关内容. 打开About.vue,修 ...
- (二叉树 BFS) leetcode102. Binary Tree Level Order Traversal
Given a binary tree, return the level order traversal of its nodes' values. (ie, from left to right, ...