
SPFA算法详解
前置知识:Bellman-Ford算法
前排提示:SPFA算法非常容易被卡出翔。所以如果不是图中有负权边,尽量使用Dijkstra!(Dijkstra算法不能能处理负权边,但SPFA能)
前排提示*2:一定要先学Bellman-Ford!
0.引子
在Bellman-Ford算法中,每条边都要松弛\(n-1\)轮,还不一定能松弛成功,这实在是太浪费了。能不能想办法改进呢?
非常幸运,SPFA算法能做到这点。(SPFA又名“Bellman-Ford的队列优化”,就是这个原因。)
1.基本思想
先说一个结论:只有一个点在上一轮被松弛成功时,这一轮从这个点连出的点才有可能被成功松弛。
为什么?显而易见
好吧其实我当初也花了不少时间理解这玩意
松弛的本质其实是通过一个点中转来缩短距离(如果你看了前置很容易理解)。所以,如果起点到一个点的距离因为某种原因变小了,从起点到这个距离变小的点连出的点的距离也有可能变小(因为可以通过变小的点中转)。(通读三遍再往下看)
所以,可以在下一轮只用这一轮松弛成功的点进行松弛,这就是SPFA的基本思想。
2.用队列实现
我们知道了在下一轮只用这一轮松弛成功的点进行松弛,就可以把这一轮松弛成功的点放进队列里,下一轮只用从队列里取出的点进行松弛。
为什么是队列而不是其他的玄学数据结构?因为队列具有“先进先出,后进后出”的特点,可以保证这一轮松弛的点不会在这一轮结束之前取出。
干说可能不太理解,所以还是举个栗子吧。
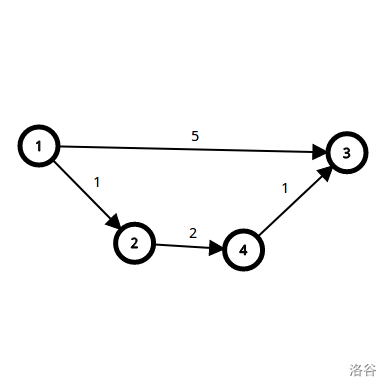
这又是之前的有向图,但是这次我们要用SPFA跑。
最开始,我们要把\(1\)号点放进队列(为什么要这样?先往下看)。\(dis\)数组和队列是这个亚子的:
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(\infty\) |
| \(3\) | \(\infty\) |
| \(4\) | \(\infty\) |
| queue | 1 |
|---|
用\(1\)号点进行松弛(就是\(1\)号到\(1\)号再到目标点):
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(1\) |
| \(3\) | \(5\) |
| \(4\) | \(\infty\) |
| queue | 2 | 3 |
|---|
\(2,3\)号点被松弛成功了,把它们加入到队列里。
\(1\)号点被用过了,把它扔掉。(工具点石锤)
用\(2\)号点进行松弛:
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(1\) |
| \(3\) | \(5\) |
| \(4\) | \(3\) |
| queue | 3 | 4 |
|---|
\(4\)号点被松弛成功了,把它们加入到队列里。
\(2\)号点被用过了,把它扔掉。
用\(3\)号点进行松弛:
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(1\) |
| \(3\) | \(5\) |
| \(4\) | \(3\) |
| queue | 4 |
|---|
没有点被松弛成功。
\(3\)号点被用过了,把它扔掉。
用\(4\)号点进行松弛:
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(1\) |
| \(3\) | \(4\) |
| \(4\) | \(3\) |
| queue | 3 |
|---|
\(3\)号点被松弛成功了,把它们加入到队列里。
\(4\)号点被用过了,把它扔掉。
用\(3\)号点进行松弛:
| \(i\) | \(dis[i]\) |
|---|---|
| \(1\) | \(0\) |
| \(2\) | \(1\) |
| \(3\) | \(4\) |
| \(4\) | \(3\) |
| queue |
|---|
没有点被松弛成功。
\(3\)号点被用过了,把它扔掉。
现在队列为空(也就是能松弛的都松弛了),算法结束。
3.Code
SPFA的具体实现,推荐结合上面的栗子食用。
#include <bits/stdc++.h>

using namespace std;

#define MAXN 10005

#define INF 0x7fffffff

int n,m,s,dis[MAXN];

vector<pair<int,int> > g[MAXN];//用vector存图,但是据说链式前向星更快

void spfa(){

    queue<int> q;

    q.push(s);//把初始点加入队列

    fill(dis+1,dis+1+n,INF);//因为一开始所有点都到不了,所以初始化为INF

    dis[s]=0;//自己到自己肯定距离为0

    while(!q.empty()){

        int u=q.front();

        q.pop();//从队列里取出第一个元素

        for(int i=0;i<g[u].size();i++){

            int v=g[u][i].first,w=g[u][i].second;

            if(dis[v]>dis[u]+w){

                dis[v]=dis[u]+w;

                q.push(v);

            }

            //如果能松弛成功,那么松弛,把松弛成功的目标点放入队列

        }

    }

}

int main(){

    scanf("%d%d%d",&n,&m,&s);

    for(int i=1;i<=m;i++){

        int u,v,w;

        scanf("%d%d%d",&u,&v,&w);

        g[u].push_back(make_pair(v,w));

    }//输入,建图

    spfa();

    for(int i=1;i<=n;i++){

        printf("%d ",dis[i]);

    }//输出

    return 0;

}
这个代码能够ACP3371,但是我还是推荐你自己码一遍。
4.特点
- 能够处理有负权边的图,但是隔壁Dijkstra不行。
- 在有负环的情况下,不存在最短路,因为不停在负环上绕就能把最短路刷到任意低。但是SPFA能够判断图中是否存在负环,具体方法为统计每个点的入队次数,如果有一个点入队次数$ \ge n $,那么图上存在负环,也就不存在最短路了。
- 什么?你不知道什么叫负环?下面的就是。
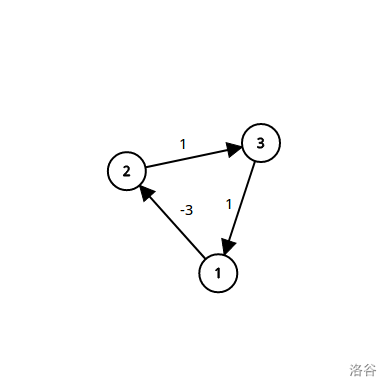
就是一个环,边权和是负。一般用一个名为菜鸡算法的算法判断
——Ynoi
- SPFA的时间复杂度是\(O(km)\),\(k\)是每一个节点的平均入队次数,经过实践,\(k\)一般为\(4\),所以SPFA通常情况下非常高效。但是SPFA非常容易被卡出翔,最坏情况下会变成\(O(nm)\)! 所以如果能用隔壁Dijkstra尽量不要用SPFA。至于具体怎么卡,据说是这样的:
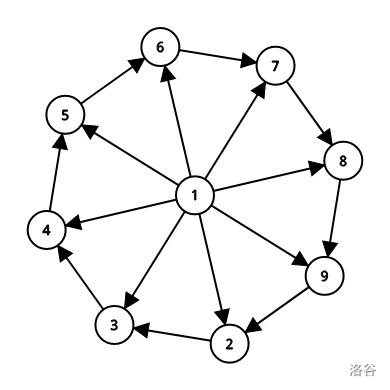
(这种图据说叫菊花图,能欺骗SPFA多次让点进入队列,所以\(k\)会变得非常大(上限为\(n\))。)
5.你都看到这了就不点一个赞吗?
这个最重要了qwq
SPFA算法详解的更多相关文章
- 图的最短路径-----------SPFA算法详解(TjuOj2831_Wormholes)
这次整理了一下SPFA算法,首先相比Dijkstra算法,SPFA可以处理带有负权变的图.(个人认为原因是SPFA在进行松弛操作时可以对某一条边重复进行松弛,如果存在负权边,在多次松弛某边时可以更新该 ...
- SPFA 算法详解
适用范围:给定的图存在负权边,这时类似Dijkstra等算法便没有了用武之地,而Bellman-Ford算法的复杂度又过高,SPFA算法便 派上用场了. 我们约定有向加权图G不存在负权回路,即最短路径 ...
- SPFA 算法详解( 强大图解,不会都难!) (转)
适用范围:给定的图存在负权边,这时类似Dijkstra等算法便没有了用武之地,而Bellman-Ford算法的复杂度又过高,SPFA算法便 派上用场了. 我们约定有向加权图G不存在负权回路,即最短路径 ...
- Bellman-Ford算法与SPFA算法详解
PS:如果您只需要Bellman-Ford/SPFA/判负环模板,请到相应的模板部分 上一篇中简单讲解了用于多源最短路的Floyd算法.本篇要介绍的则是用与单源最短路的Bellman-Ford算法和它 ...
- Bellman-Ford&&SPFA算法详解
Dijkstra在正权图上运行速度很快,但是它不能解决有负权的最短路,如下图: Dijkstra运行的结果是(以1为原点):0 2 12 6 14: 但手算的结果,dist[4]的结果显然是5,为什么 ...
- 【最短路径Floyd算法详解推导过程】看完这篇,你还能不懂Floyd算法?还不会?
简介 Floyd-Warshall算法(Floyd-Warshall algorithm),是一种利用动态规划的思想寻找给定的加权图中多源点之间最短路径的算法,与Dijkstra算法类似.该算法名称以 ...
- BM算法 Boyer-Moore高质量实现代码详解与算法详解
Boyer-Moore高质量实现代码详解与算法详解 鉴于我见到对算法本身分析非常透彻的文章以及实现的非常精巧的文章,所以就转载了,本文的贡献在于将两者结合起来,方便大家了解代码实现! 算法详解转自:h ...
- kmp算法详解
转自:http://blog.csdn.net/ddupd/article/details/19899263 KMP算法详解 KMP算法简介: KMP算法是一种高效的字符串匹配算法,关于字符串匹配最简 ...
- 机器学习经典算法详解及Python实现--基于SMO的SVM分类器
原文:http://blog.csdn.net/suipingsp/article/details/41645779 支持向量机基本上是最好的有监督学习算法,因其英文名为support vector ...
随机推荐
- 记一次mysql关于limit和orderby的优化
针对于大数据量查询,我们一般使用分页查询,查询出对应页的数据即可,这会大大加快查询的效率: 在排序和分页同时进行时,我们一定要注意效率问题,例如: select a.* from table1 a i ...
- PHP natsort() 函数
------------恢复内容开始------------ 实例 对数组进行排序: <?php$temp_files = array("temp15.txt"," ...
- 2019 HL SC day10
10天都过去了 4天都在全程懵逼.. 怎么可以这么难啊 我服了 现在想起依稀只记得一些结论 什么 反演? 什么后缀自动机?什么组合数的应用?什么神仙东西 ,不过讲课人的确都是神仙.(实名羡慕. mzx ...
- EF Code First数据库模型及属性约束
1.今日完成任务 数据库实体的创建 实体属性约束的添加 实体之间关系的添加 2.核心代码 EF模型 属性约束及实体之间的关系 使用FlutAPI对模型进行修正 3.遇到的问题及解决方案 最主要的是联合 ...
- [转]Java死锁排查
文章来源:微信公众号:猿天地 1. 死锁的概念: 是Java多线程情况下,两个或两个以上的进程在执行过程中,由于竞争资源或者由于彼此通信而造成的一种阻塞现象,若无外力作用,它们都讲无法推进下去.此时称 ...
- Qt信号参数中使用QVariantList时编译问题
今天调试代码时遇到一个奇怪的问题,不过一般感觉比较奇怪的问题,最后查到原因时,原因都比较简单! 编译问题 先来看一下qt的编译错误,提示一堆错误: In file included from D:\Q ...
- Python selenium爬虫实现定时任务过程解析
现在需要启动一个selenium的爬虫,使用火狐驱动+多线程,大家都明白的,现在电脑管家显示CPU占用率20%,启动selenium后不停的开启浏览器+多线程, 好,没过5分钟,CPU占用率直接拉到9 ...
- 18、Memento 备忘录模式
例如:用于记录快照(顺势状态).存盘 1.Memento Memento设计模式是一种软件设计模式,用于将对象回滚到其先前状态.它是行为设计模式的一部分,与算法和对象之间的职责分配有关. 行为模式描述 ...
- Django REST framework 单元测试
Django REST framework 单元测试 只是简单记录一下测试代码怎么写 环境 Win10 Python3.7 Django2.2 项目 参照官网 快速开始 写了一个 demo 测试 参照 ...
- C#设计模式之6-适配器模式
适配器模式(Adapter Pattern) 该文章的最新版本已迁移至个人博客[比特飞],单击链接 https://www.byteflying.com/archives/399 访问. 适配器模式属 ...